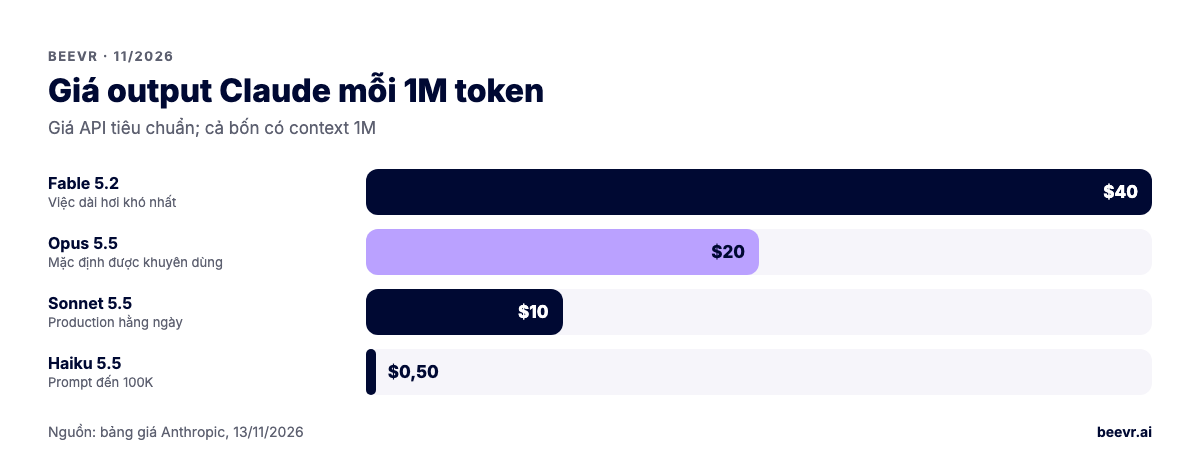
Tính đến tháng 11/2026, dòng model Claude hiện hành của Anthropic gồm Fable 5.2 ($8/$40 mỗi triệu token), Opus 5.5 ($4/$20), Sonnet 5.5 ($2/$10) và Haiku 5.5 (từ $0,10/$0,50). Cả bốn đều có context window 1M token. Hãy bắt đầu với Opus 5.5, hạ xuống Sonnet 5.5 hoặc Haiku 5.5 khi eval cho phép, và chỉ dùng Fable 5.2 cho việc dài hơi khó nhất.
Cập nhật ngày 13/11/2026. Anthropic đã thay gần hết dòng model trong bảy tuần: Opus 5.5 ngày 22/9, Sonnet 5.5 ngày 28/9, Haiku 5.5 ngày 7/10 và Fable 5.2 ngày 9/11. Nếu code của bạn vẫn trỏ vào một model 4.x, hoặc bạn chưa rõ "Fable" là gì, bài này đối chiếu từng model với loại việc phù hợp. Mọi mức giá, ID và giới hạn đều lấy từ tài liệu chính thức của Anthropic.
Tháng 11/2026 có những model Claude nào?
Có bốn model dùng chung cho mọi khách hàng: Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5 và Claude Haiku 5.5. Model thứ năm là Claude Mythos 5.2, cùng model với Fable 5.2 nhưng ít lớp bảo vệ hơn, và chỉ tổ chức đã xác minh mới dùng được. Mọi model hiện hành đều nhận text và ảnh, hỗ trợ tool use, có context 1M và output tối đa 128K.
| Fable 5.2 | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 | |
|---|---|---|---|---|
| Anthropic mô tả | Suy luận khó, tác vụ agent dài hơi | Coding agent chạy lâu và công việc tri thức | Cân bằng tốt nhất giữa tốc độ và trí tuệ | Tác vụ khối lượng lớn, cần độ trễ thấp |
| Ngày ra mắt | 9/11/2026 | 22/9/2026 | 28/9/2026 | 7/10/2026 |
| Input / output mỗi 1M | $8 / $40 | $4 / $20 | $2 / $10 | $0,10 / $0,50 (prompt đến 100K) |
| Cache hit mỗi 1M | $0,20 | $0,20 | $0,10 | $0,01 |
| Độ trễ tương đối | Moderate | Moderate | Fast | Fastest |
| Effort mặc định | high | medium | high | medium |
| Thinking | Luôn bật | Luôn bật | Adaptive | Adaptive |
| Context / output tối đa | 1M / 128K | 1M / 128K | 1M / 128K | 1M / 128K |
| Mốc kiến thức | 06/2026 | 06/2026 | 06/2026 | 06/2026 |
| Không ngừng trước | 9/11/2027 | 22/9/2027 | 28/9/2027 | 7/10/2027 |
Nguồn: tổng quan model Claude và bảng giá Claude, đọc ngày 13/11/2026.
Nên dùng model Claude nào?
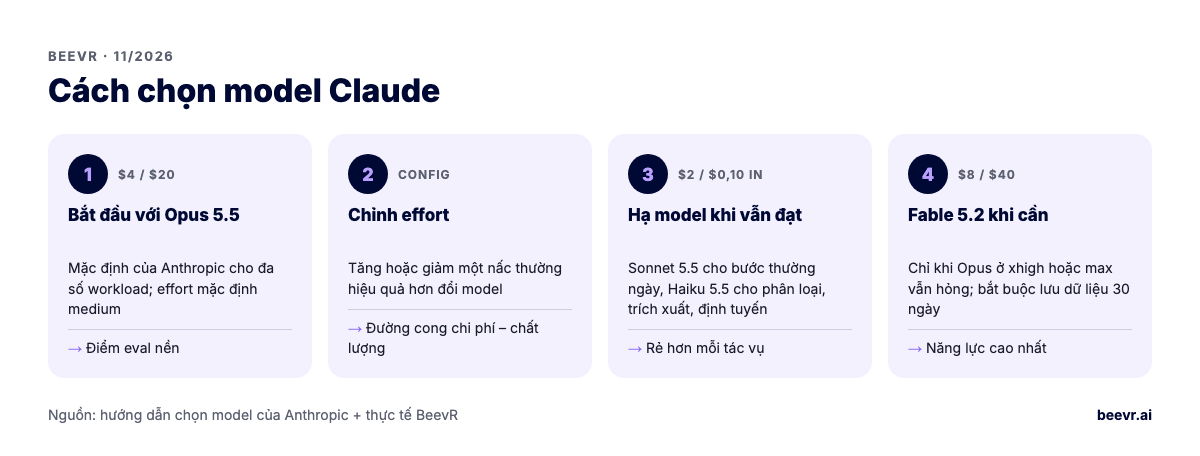
Lời khuyên của chính Anthropic là cho đa số workload bắt đầu với Claude Opus 5.5. Từ đó, hạ effort hoặc chuyển xuống Sonnet 5.5, Haiku 5.5 khi eval cho thấy chất lượng vẫn giữ được. Chỉ lên Fable 5.2 khi Opus 5.5 ở effort xhigh hoặc max vẫn chưa đạt với suy luận khó hay agent dài hơi.
Hướng dẫn chọn model của Anthropic gán bốn model cho bốn loại việc. Dưới đây là phiên bản của chúng tôi, kèm các tình huống gặp trong dự án khách hàng:
- Fable 5.2: phiên agent chạy hàng giờ, nghiên cứu nhiều bước, phân tích đến tận tài liệu hoặc bảng tính hoàn chỉnh. Dùng khi một lần chạy hỏng tốn kém hơn tiền token.
- Opus 5.5: coding agent chạy nhiều giờ, refactor lớn, kỹ thuật hệ thống phức tạp, workflow nặng về hình ảnh và computer use. Là lựa chọn mặc định tốt cho vai trò "lập kế hoạch" của agent.
- Sonnet 5.5: sinh code hằng ngày, phân tích dữ liệu, soạn tài liệu và tool use trong agent. Khi đã có eval, đây thường là mặc định đúng cho production.
- Haiku 5.5: phân loại, trích xuất, định tuyến, tóm tắt và nén context, hỗ trợ khách hàng trực tiếp, và làm subagent dưới một model lớn hơn.
Anthropic cũng nói chỉnh effort thường hiệu quả hơn đổi model. Trước khi đổi model, hãy thử tăng hoặc giảm effort một nấc rồi chạy lại eval.
Claude Fable và Claude Opus khác nhau thế nào?
Fable là tầng năng lực cao nhất mà Anthropic mở cho mọi khách hàng. Opus là mặc định được khuyên dùng cho phần lớn công việc. Fable 5.2 đắt gấp đôi Opus 5.5 ($8/$40 so với $4/$20) và mặc định effort high thay vì medium. Trên benchmark ra mắt của Anthropic, Fable 5.2 dẫn Opus 5.5 7,6 điểm ở FrontierSWE v2 (69,9% so với 62,3%) và 15,9 điểm ở Terminal-Bench-Science 0.1 (74,6% so với 58,7%).
Những gì thay đổi khi chuyển sang Fable 5.2
- Lịch sử hội thoại nghiêm ngặt. Nếu code sửa system prompt, tools hay bất kỳ message cũ nào, request bị lỗi 400. Claude Code, Agent SDK và Managed Agents tự xử lý việc này; harness tự viết thì phải giữ history ở dạng chỉ thêm vào.
- Thinking block gắn với model. Chỉ Fable 5.2 và Mythos 5.2 đọc được phần suy luận của Fable 5.2. Chuyển hội thoại sang Opus 5.5 hay model fallback sẽ làm rơi phần đó.
- Lưu trữ dữ liệu. Theo ghi chú Fable 5.2 của Anthropic, Fable 5.2 bắt buộc lưu dữ liệu 30 ngày và không dùng được với zero data retention, trừ khi Anthropic cho phép riêng. Opus 5.5 và Sonnet 5.5 thì dùng được với ZDR.
- Computer use. Tool cũ
computer_20251124trả lỗi ở mọi nơi trừ Amazon Bedrock. Hãy dùng toolsetcomputer_toolset_20260801.
Với workload có quy định, riêng điều khoản lưu trữ thường đã quyết định trước cả benchmark.
Claude Sonnet 5.5 có đủ thay Opus 5.5 không?
Thường là đủ. Trên trang ra mắt Sonnet 5.5 của Anthropic, Sonnet 5.5 chỉ kém Opus 5.5 vài điểm ở hầu hết các dòng (GDPval-AA 1844 so với 1846, OSWorld 2.1 80,1% so với 81,8%). Ở Terminal-Bench 4.0, Sonnet 5.5 còn vượt Opus 5.5 (70,6% so với 66,4%), với giá mỗi token chỉ bằng một nửa. Anthropic vẫn khẳng định Opus 5.5 mạnh hơn ở việc phức tạp, mở.
Có hai chi tiết về chi phí đáng chú ý. Ngày 7/10, giá đọc cache của Sonnet 5.5 giảm còn $0,10 mỗi triệu token; theo Anthropic, việc này giảm khoảng 20% chi phí ở phần lớn tác vụ agent. Anthropic cũng cho biết Sonnet 5.5 dùng ít token mỗi tác vụ hơn Sonnet 5, rẻ hơn tới 30% mỗi tác vụ trong thử nghiệm của họ. Với vòng lặp agent dùng cache nhiều, Sonnet 5.5 thường là model rẻ nhất vẫn đạt eval.
Một cái bẫy khi chuyển từ Sonnet 5: không tắt hẳn được thinking. Muốn tắt phần suy nghĩ trước khi trả lời, dùng thinking: {"type": "between_tools"}. Giá trị "disabled" giờ trả lỗi 400.
Khi nào nên dùng Claude Haiku 5.5?
Dùng Haiku 5.5 cho các bước khối lượng lớn, nhạy về chi phí, cần tốc độ hơn độ sâu: phân loại, trích xuất, định tuyến, tóm tắt, truy vấn cơ sở dữ liệu, hỗ trợ khách hàng trực tiếp và tác vụ subagent. Giá là $0,10/$0,50 mỗi triệu token với prompt đến 100.000 token, và $0,50/$2,50 khi vượt ngưỡng. Anthropic không khuyên dùng Haiku 5.5 cho coding agent phức tạp.
Bước nhảy so với Haiku 4.5 rất lớn. Trang Haiku 5.5 của Anthropic công bố 39,2% trên Terminal-Bench 4.0 (Haiku 4.5: 0,0%) và 72,4% trên tập offline của OSWorld 2.1 (Haiku 4.5: 15,7%). Haiku 5.5 cũng vượt GPT-6 Luna ở mọi benchmark mà cả hai cùng có. Đây là bản Haiku đầu tiên có tham số effort (từ low đến max), và theo Anthropic, chi phí trung bình thấp hơn Haiku 4.5 khoảng 75%.
Hãy để ý ngưỡng 100K. Mỗi request được tính giá theo toàn bộ prompt, kể cả phần đọc từ cache. Một request 101K token sẽ trả giá input gấp năm lần. Nếu dùng Haiku để tóm tắt tài liệu dài, hãy chia nhỏ dưới 100K hoặc tính ngân sách theo mức giá cao.
Model ID của Claude trên API, Bedrock, Google Cloud và Foundry là gì?
Trên Claude API, các ID là claude-fable-5-2, claude-opus-5-5, claude-sonnet-5-5 và claude-haiku-5-5. Từ thế hệ 4.6, mỗi ID không có ngày đều là một snapshot cố định, không phải alias trỏ đi nơi khác. Google Cloud, Microsoft Foundry và Claude Platform on AWS dùng cùng ID; Amazon Bedrock thêm tiền tố.
| Model | Claude API / Google Cloud / Foundry | Amazon Bedrock |
|---|---|---|
| Fable 5.2 | claude-fable-5-2 | global.anthropic.claude-fable-5-2 (chỉ bedrock-runtime) |
| Opus 5.5 | claude-opus-5-5 | anthropic.claude-opus-5-5 |
| Sonnet 5.5 | claude-sonnet-5-5 | anthropic.claude-sonnet-5-5 |
| Haiku 5.5 | claude-haiku-5-5 | anthropic.claude-haiku-5-5 |
Các ngày ngừng hoạt động ở bảng trên là cam kết của Anthropic cho nền tảng do Anthropic vận hành. Bedrock và Vertex do Google quản lý tự đặt vòng đời riêng, nên nếu triển khai ở đó hãy kiểm tra riêng. Models API trả về trường line (ví dụ opus). Hãy dùng trường này để nhóm model trong giao diện chọn model thay vì tách chuỗi ID.
Model Claude giá bao nhiêu mỗi triệu token?
Giá tiêu chuẩn là $8/$40 cho Fable 5.2, $4/$20 cho Opus 5.5, $2/$10 cho Sonnet 5.5 và $0,10/$0,50 cho Haiku 5.5 (prompt dưới 100K token). Batch API giảm một nửa cho tất cả. Đọc cache được giảm sâu hơn ở model mới: 0,025 lần giá input gốc trên Fable 5.2, 0,05 lần trên Opus 5.5 và Sonnet 5.5, và 0,1 lần ở các model khác.
- Ghi cache: 1,25 lần giá input gốc cho cache 5 phút, 2 lần cho cache 1 giờ.
- Context dài: không phụ phí đến 1M token với Claude 4.6 trở lên, trừ ngưỡng 100K của Haiku 5.5.
- Inference chỉ tại Mỹ: nhân 1,1 lần mọi loại token khi đặt
inference_geo: "us". - Fast mode: output nhanh tới 2,5 lần, giá $16/$80 (Fable 5.2) hoặc $8/$40 (Opus 5.5). Không dùng chung với Batch.
- Tokenizer: Claude 4.7 trở đi sinh nhiều hơn khoảng 30% token cho cùng một đoạn văn so với model cũ. Vì vậy, so thẳng với hóa đơn thời 4.5 sẽ đánh giá thấp chi phí mỗi request mới.
So sánh với OpenAI, Google và phép tính hóa đơn agent hằng tháng có trong bài so sánh giá API LLM tháng 11/2026.
Claude Mythos là gì, ai được dùng?
Claude Mythos 5.2 là cùng model với Fable 5.2 nhưng ít lớp chặn hơn về an ninh mạng và sinh học. Chỉ tổ chức đã được xác minh qua chương trình của Anthropic, như Cyber Verification Program hay Life Sciences Verification Program, mới dùng được. Giá vẫn là $8/$40. Khách hàng Claude Enterprise cũng tiếp cận model này qua Claude Security, sản phẩm chạy trên Mythos 5.2.
Nếu bạn làm công cụ bảo mật và liên tục bị từ chối dù việc hợp lệ, bỏ công làm hồ sơ xin quyền là đáng. Anthropic công bố Mythos 5.2 đạt 89,6% trên CVE Rediscovery. Model tương đương của OpenAI là GPT-6-Cyber, xem bài GPT-6 Cyber là gì.
Những model Claude cũ nào sắp ngừng hoạt động?
Gấp nhất là Claude Sonnet 4.5 (claude-sonnet-4-5-20250929), ngừng trên Claude API ngày 30/11/2026; Anthropic khuyên chuyển sang Sonnet 5.5. Fast mode của Opus 4.8 cũng bị gỡ cùng ngày. Claude Opus 4, Opus 4.1 và Sonnet 4 đã ngừng trên Claude API nhưng có thể vẫn chạy trên một số nền tảng cloud.
Các model cũ như Opus 4.5 đến 4.8, Opus 5, Sonnet 4.6, Sonnet 5 và Haiku 4.5 vẫn còn trong danh sách, nhưng model mới có giá bằng hoặc rẻ hơn: Opus 5 là $5/$25, Opus 5.5 là $4/$20. Chuyển lên chủ yếu là việc kỹ thuật (thinking luôn bật, effort mặc định mới, tham số bị từ chối). Bài chuyển đổi model LLM hướng dẫn chi tiết. Nếu đang so giữa các hãng, xem so sánh Claude Opus 5.5 và GPT-6 Sol.
BeevR làm việc này thế nào
Trên production, chúng tôi hiếm khi dùng một model Claude cho mọi việc. Một agent điển hình chúng tôi xây dùng Opus 5.5 hoặc Sonnet 5.5 để lập kế hoạch và ra quyết định, Haiku 5.5 để phân loại, trích xuất và nén context. Fable 5.2 chỉ xuất hiện ở chỗ eval chứng minh nó đáng tiền. Mỗi bước có bộ eval riêng và ngân sách chi phí, độ trễ riêng. Lựa chọn model là config, nên lần ra mắt tiếp theo chỉ là một lượt chạy thử chứ không phải viết lại. Với khách y tế và các ngành có quy định, chúng tôi kiểm tra điều khoản lưu trữ của từng model và có thể chạy model ngay trong tài khoản AWS của khách theo AWS BAA. Phần còn lại có trong checklist bảo mật AI agent.
BeevR là đội senior do founder dẫn dắt tại Hà Nội, được đánh giá 5.0 trên Clutch. Chúng tôi làm theo phạm vi cố định, giá cố định từ $10K mỗi giai đoạn, có demo chạy được mỗi thứ Sáu, và khách sở hữu code cùng IP ngay từ ngày đầu. Xem các dự án phát triển AI agent của chúng tôi.
Cần người giúp chọn và test đúng model Claude cho sản phẩm? Đặt lịch gọi 30 phút.