Tháng 11/2026, API của các LLM frontier có giá $2 đến $10 mỗi triệu token input và $10 đến $50 mỗi triệu token output. Model giá rẻ chỉ $0,10/$0,50. Trong ví dụ tính toán của chúng tôi, một agent làm 10.000 tác vụ mỗi tháng tốn $112 nếu chạy Claude Haiku 5.5 hoặc GPT-6 Luna, $2.120 với Sonnet 5.5 hoặc GPT-6.1 Sol, và $4.240 với Opus 5.5. Prompt caching cắt hóa đơn đi một nửa.
Cập nhật ngày 13/11/2026. Mọi mức giá dưới đây được đọc hôm nay từ trang giá chính thức của Anthropic, OpenAI và Google Gemini. Đây là giá trả theo mức dùng tiêu chuẩn, tính bằng USD, chưa trừ chiết khấu đàm phán và chưa có thuế. Giá niêm yết thay đổi thường xuyên (hai model trong bảng đổi giá trong vòng bảy tuần tới), nên hãy kiểm tra lại nguồn trước khi chốt ngân sách.
Tháng 11/2026, API LLM giá bao nhiêu mỗi triệu token?
Model flagship có giá $4 đến $10 mỗi triệu token input và $20 đến $50 mỗi triệu token output. Model tầng giữa mạnh (Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Carbon và Argon) khoảng $2/$10. Model nhỏ (Claude Haiku 5.5, GPT-6 Luna) là $0,10/$0,50. Ở hãng nào thì token output cũng đắt gấp bốn đến tám lần token input.
| Model | Input | Cache hit | Output | Batch in / out | Ghi chú |
|---|---|---|---|---|---|
| GPT-6 Astra | $10,00 | $1,00 | $50,00 | $5 / $25 | Input >272K: $20 / $75 |
| Claude Fable 5.2 | $8,00 | $0,20 | $40,00 | $4 / $20 | Context 1M cùng một giá |
| Claude Opus 5.5 | $4,00 | $0,20 | $20,00 | $2 / $10 | Context 1M cùng một giá |
| Gemini 4 Carbon | $2,00 | $0,10 | $10,00 | $1 / $5 | Tăng lên $4 / $20 từ 1/12 |
| Gemini 4 Argon | $2,00 | $0,10 | $10,00 | $1 / $5 | Tăng lên $4 / $20 từ 1/12 |
| Claude Sonnet 5.5 | $2,00 | $0,10 | $10,00 | $1 / $5 | Context 1M cùng một giá |
| GPT-6.1 Sol | $2,00 | $0,10 | $10,00 | $1 / $5 | Input >272K: $4 / $15 |
| GPT-6 Sol | $2,00 | $0,20 | $10,00 | $1 / $5 | Input >272K: $4 / $15 |
| Gemini 4 Hydrogen | $1,50 | $0,075 | $7,50 | $0,75 / $3,75 | Ra mắt 12/11 |
| GPT-6.1 Terra | $1,00 | $0,05 | $5,00 | $0,50 / $2,50 | Input >272K: $2 / $7,50 |
| Gemini 3.8 Flash | $0,75 | $0,075 | $3,75 | $0,375 / $1,875 | Tăng gấp đôi từ 1/1/2027 |
| Claude Haiku 5.5 | $0,10 | $0,01 | $0,50 | $0,05 / $0,25 | Prompt >100K: $0,50 / $2,50 |
| GPT-6 Luna | $0,10 | $0,01 | $0,50 | $0,05 / $0,25 | Input >272K: $0,20 / $0,75 |
Mọi giá tính bằng USD cho mỗi 1 triệu token, gói tiêu chuẩn, độ dài prompt thông thường. Bảng không gồm phí ghi cache, phí lưu cache theo giờ của Gemini và phí tool, ví dụ web search của Anthropic là $10 cho mỗi 1.000 lượt tìm.
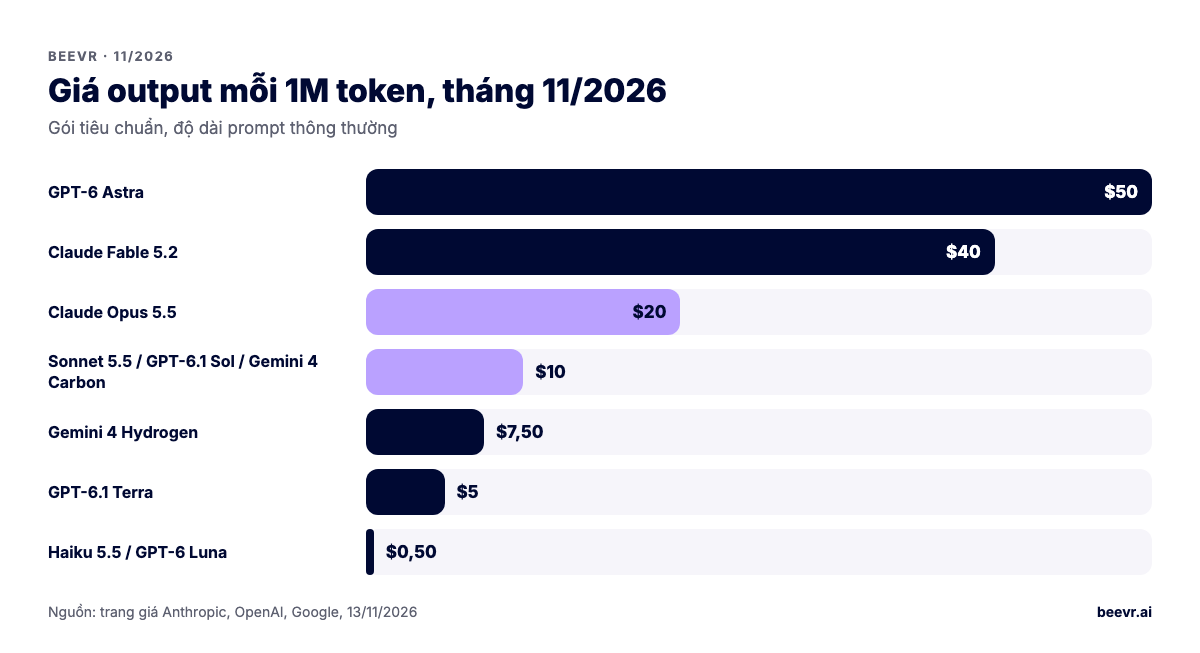
API LLM nào rẻ nhất tháng 11/2026?
Trong các model hiện hành của ba hãng lớn, Claude Haiku 5.5 và GPT-6 Luna đồng hạng ở mức $0,10 mỗi triệu token input và $0,50 mỗi triệu token output. Batch giảm còn $0,05/$0,25. Với prompt từ 100K đến 272K token, GPT-6 Luna rẻ hơn: giá Haiku 5.5 tăng 5 lần khi vượt 100K, còn giá Luna chỉ tăng gấp đôi, và chỉ khi vượt 272K.
Hai model không ngang nhau về năng lực trong các bài test của Anthropic: trên trang ra mắt Haiku 5.5, Haiku 5.5 đạt 39,2% trên Terminal-Bench 4.0, còn GPT-6 Luna đạt 16,4%. Đây là số của Anthropic, hãy tự chạy lại. Model text hiện hành rẻ nhất trên trang giá Gemini là Gemini 3.1 Flash-Lite, $0,25/$1,50, đắt hơn gấp đôi.
"Rẻ nhất mỗi token" hiếm khi là câu hỏi hữu ích. Hãy hỏi model rẻ nhất nào vẫn qua được eval ở mức chất lượng bạn cần. Với phân loại và trích xuất, đó thường là một model $0,10. Với lập kế hoạch nhiều bước của agent thì thường không phải.
Prompt caching tiết kiệm được bao nhiêu chi phí API LLM?
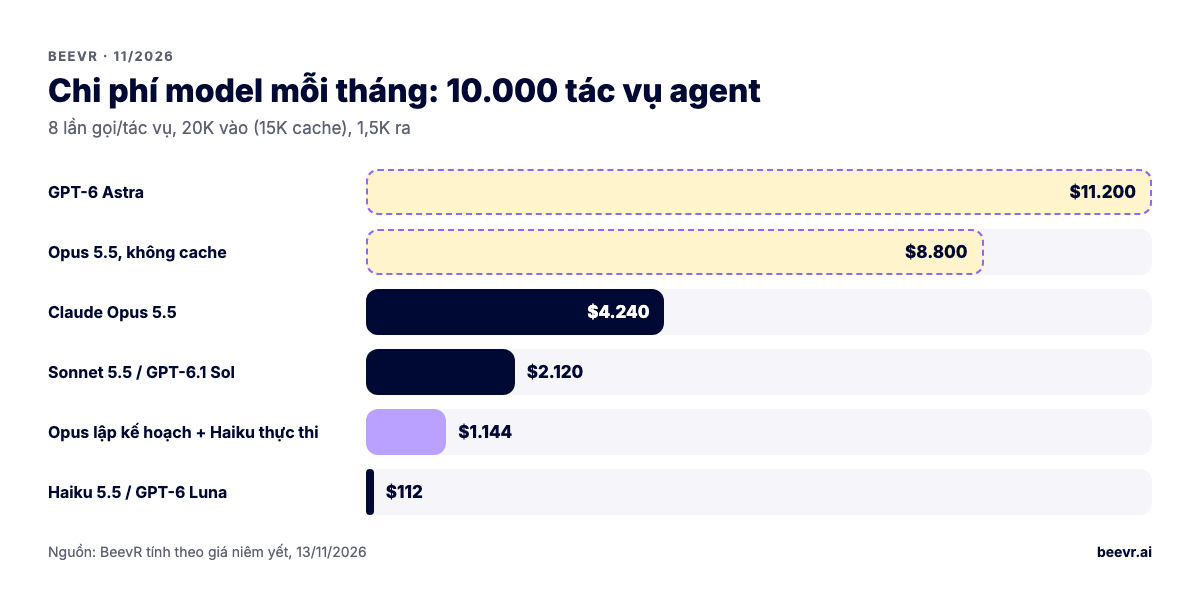
Với agent thì tiết kiệm rất nhiều. Cache hit chỉ tốn 2,5% đến 10% giá input thường trên Claude (2,5% với Fable 5.2, 5% với Opus 5.5 và Sonnet 5.5) và 5% đến 10% trên các model GPT-6 của OpenAI. Trong ví dụ tính toán bên dưới, caching cắt hóa đơn tháng của Opus 5.5 từ $8.800 xuống $4.240, tiết kiệm 52%.
Agent gửi lại cùng system prompt, định nghĩa tool và lịch sử hội thoại ở mỗi lượt, nên phần lớn token input là lặp lại. Caching chỉ hiệu quả khi phần lặp lại là một prefix ổn định. Hãy đặt nội dung cố định lên đầu, nội dung thay đổi xuống cuối, và đừng đổi thứ tự tool giữa các lần gọi.
- Anthropic: ghi cache tốn 1,25 lần giá input gốc cho cache 5 phút, hoặc 2 lần cho cache 1 giờ. Cache 5 phút hòa vốn chỉ sau một lần đọc.
- OpenAI: trang model GPT-6 ghi phí ghi cache của Sol là $2,50 mỗi triệu token (1,25 lần input). Từ 20/10 đã có prompt caching 12 giờ.
- Google: context caching có giá đọc theo token cộng phí lưu trữ theo giờ ($0,50 mỗi triệu token mỗi giờ với Gemini 3.8 Flash).
Batch API giảm được bao nhiêu chi phí?
Cả ba hãng đều tính 50% giá tiêu chuẩn cho job batch, áp dụng cho cả input và output. Ở Anthropic, giảm giá batch cộng dồn được với prompt caching. OpenAI còn bán cùng mức 50% dưới tên "Flex" cho lệnh gọi đồng bộ chấp nhận chờ lâu hơn. Batch hợp với eval, chạy bù dữ liệu, xử lý tài liệu và job ban đêm. Nó không hợp với bất cứ thứ gì người dùng đang phải chờ.
Đòn bẩy ngược lại là tốc độ. Gói Fast của OpenAI tốn 2 lần giá chuẩn, chế độ Ultrafast của GPT-6.1 Sol là $12/$60. Fast mode của Anthropic cho Opus 5.5 là $8/$40, cũng gấp 2 lần. Gói Priority của Gemini tốn 1,8 lần. Chỉ trả tiền cho tốc độ ở những bước người dùng nhìn thấy, nơi độ trễ thể hiện trên chỉ số của bạn.
Prompt dài có đắt hơn trên Claude, GPT và Gemini không?
Trên OpenAI thì có. Khi input vượt 272K token, các model GPT-6 tính input gấp đôi và output gấp 1,5 lần cho cả request. Trên Claude 4.6 trở lên thì không: toàn bộ cửa sổ 1M tính theo giá chuẩn, trừ Claude Haiku 5.5, model tăng giá 5 lần khi vượt 100K token. Trên Google, trong các model text hiện hành chỉ Gemini 3.1 Pro Preview có giá cao hơn khi vượt 200K.
Điều này quan trọng với hệ thống RAG và agent giữ lịch sử dài. Một request 300K token trên GPT-6.1 Sol trả $4 mỗi triệu token input thay vì $2. Cùng request đó trên Opus 5.5 trả mức thường $4, trên Sonnet 5.5 trả mức thường $2. Compaction, tức thay các lượt cũ bằng bản tóm tắt, giữ bạn dưới các ngưỡng này và thường rẻ hơn trả tiền cho context dài.
Chạy một AI agent mỗi tháng tốn bao nhiêu?
Trong ví dụ của chúng tôi, phí model dao động từ $112 đến $11.200 mỗi tháng, chỉ tùy vào model. Workload là 10.000 tác vụ agent mỗi tháng, mức thường gặp với một agent vận hành nội bộ hoặc một hệ thống hỗ trợ khách hàng cỡ vừa. Phí model chỉ là một phần chi phí vận hành sản phẩm AI. Bài chi phí vận hành sản phẩm AI đề cập hosting, observability và nhân sự.
Giả định
- 10.000 tác vụ mỗi tháng, mỗi tác vụ 8 lần gọi model.
- Mỗi lần gọi: 20.000 token input, trong đó 15.000 là prefix đã cache (system prompt, tool, lịch sử) và 5.000 là token mới; 1.500 token output, tính cả phần suy luận.
- Tổng mỗi tháng: 400M input không cache, 1.200M input từ cache, 120M output.
- Gói tiêu chuẩn, không batch. Chưa tính phụ phí ghi cache và phí lưu trữ của Gemini.
| Model | Chi phí model mỗi tháng | Mỗi tác vụ |
|---|---|---|
| GPT-6 Astra | $11.200 | $1,12 |
| Claude Fable 5.2 | $8.240 | $0,82 |
| Claude Opus 5.5 | $4.240 | $0,42 |
| Gemini 4 Carbon (từ 1/12) | $4.240 | $0,42 |
| GPT-6 Sol | $2.240 | $0,22 |
| Claude Sonnet 5.5 / GPT-6.1 Sol / Gemini 4 Carbon (T11) | $2.120 | $0,21 |
| Gemini 4 Hydrogen | $1.590 | $0,16 |
| GPT-6.1 Terra | $1.060 | $0,11 |
| Gemini 3.8 Flash (đến 31/12) | $840 | $0,08 |
| Claude Haiku 5.5 / GPT-6 Luna | $112 | $0,01 |
Ví dụ phép tính cho Opus 5.5: 400M × $4 + 1.200M × $0,20 + 120M × $20 = $1.600 + $240 + $2.400 = $4.240.
Ba lưu ý làm kết quả thay đổi
- Tokenizer khác nhau. Anthropic cho biết Claude 4.7 trở đi sinh nhiều hơn khoảng 30% token cho cùng đoạn văn so với các model Claude cũ. Cùng một prompt sẽ không cho cùng số token giữa các hãng.
- Số lượt khác nhau. Model mạnh có thể xong trong 5 lần gọi, model yếu cần 12 lần hoặc không bao giờ xong. Chi phí mỗi tác vụ hoàn thành mới là con số thật.
- Định tuyến tốt hơn chọn một model. Nếu Opus 5.5 xử lý 2 lần gọi lập kế hoạch mỗi tác vụ và Haiku 5.5 xử lý 6 lần còn lại, hóa đơn còn khoảng $1.060 + $84 = $1.144, thay vì $4.240. Anthropic mô tả kiểu này là executor/advisor và orchestrator/worker.
Giá LLM nào thay đổi vào tháng 12/2026 và tháng 1/2027?
Gemini 4 Carbon và Gemini 4 Argon tăng gấp đôi từ 1/12/2026, từ $2/$10 lên $4/$20. Gemini 3.8 Flash và 3.6 Flash tăng gấp đôi từ 1/1/2027, từ $0,75/$3,75 lên $1,50/$7,50. Cũng từ 1/12, request gửi tới gemini-2.5-pro sẽ được chuyển sang Gemini 3.8 Flash và tính theo giá của model đó.
Ở phía Anthropic và OpenAI, thay đổi đáng chú ý là ngừng hoạt động chứ không phải tăng giá. Claude Sonnet 4.5 ngừng ngày 30/11/2026 (giá $3/$15; model thay thế Sonnet 5.5 giá $2/$10). OpenAI gỡ các snapshot GPT-5 và o3 ngày 11/12. Bài tổng hợp model tháng 11/2026 liệt kê đủ các mốc. Cách xử lý việc chuyển đổi có trong bài chuyển đổi model LLM.
Làm sao giảm chi phí API LLM mà không giảm chất lượng?
Hãy đo trước, rồi thay từng đòn bẩy một trên một bộ eval cố định. Theo kinh nghiệm của chúng tôi, thứ tự tiết kiệm nhiều nhất là: cache prefix ổn định, chuyển bước dễ sang model nhỏ, hạ effort ở chỗ eval cho phép, chạy batch cho mọi việc offline, và nén lịch sử dài. Đổi hãng chỉ để có giá mỗi token rẻ hơn là việc làm cuối cùng.
- Ghi log token cho từng tác vụ, theo từng bước. Không thấy thì không cắt được.
- Cache triệt để. Giữ system prompt và danh sách tool ổn định, đặt ở đầu.
- Định tuyến theo độ khó. Model nhỏ cho phân loại, trích xuất, định tuyến; model lớn cho lập kế hoạch và ra quyết định.
- Chỉnh effort. Trên Claude và các model GPT-6, effort quyết định bạn trả bao nhiêu token suy luận. Opus 5.5 mặc định
medium, Sonnet 5.5 mặc địnhhigh. - Chạy batch cho việc offline. Eval và chạy bù dữ liệu được giảm 50%.
- Test lại sau mỗi lần đổi giá. Model rẻ nhất tháng 11 chưa chắc rẻ nhất tháng 1.
Ngân sách xây dựng đầy đủ quanh các con số này có trong bài chi phí xây dựng AI agent và chi phí phát triển ứng dụng AI 2026.
BeevR làm việc này thế nào
Chúng tôi coi chi phí model là một chỉ số kỹ thuật ngay từ sprint đầu tiên. Mọi agent chúng tôi bàn giao đều ghi log token, cache hit, chi phí và độ trễ cho từng bước. Dashboard hiển thị chi phí mỗi tác vụ hoàn thành ngay cạnh tỷ lệ qua eval. Nhờ vậy, khách thấy được việc đổi model hay đổi effort ảnh hưởng thế nào đến chất lượng và chi tiêu trước khi lên production. Chúng tôi thiết kế prompt để tận dụng cache, chuyển bước dễ sang model nhỏ, và đặt model sau một interface mỏng để mỗi lần đổi giá chỉ là một lần sửa config. Với khách trong ngành có quy định, model có thể chạy ngay trong tài khoản AWS của khách theo AWS BAA, nên cả hóa đơn token lẫn dữ liệu đều nằm ở phía khách.
BeevR là đội senior do founder dẫn dắt tại Hà Nội. Chúng tôi làm theo phạm vi cố định, giá cố định từ $10K mỗi giai đoạn, có demo chạy được mỗi thứ Sáu, không tính phí theo người dùng, và khách sở hữu code cùng IP ngay từ ngày đầu. Xem các dự án phát triển AI agent của chúng tôi.
Muốn có mô hình chi phí cho workload agent của chính bạn? Đặt lịch gọi 30 phút.