Trên số ít benchmark có cả hai model, Claude Opus 5.5 điểm cao hơn GPT-6 Sol: 1846 so với 1487 Elo trên GDPval-AA v2.1, theo kết quả Anthropic tự chạy. GPT-6 Sol rẻ bằng một nửa mỗi token ($2/$10 so với $4/$20 mỗi triệu token). Cả hai có context khoảng 1M token. Không hãng nào công bố số tham số. Nếu dự án mới bắt đầu vào tháng 11/2026, hãy so Opus 5.5 với GPT-6.1 Sol thay vì GPT-6 Sol.
Cập nhật ngày 13/11/2026. Hai model ra mắt cùng ngày 22/9/2026. Mọi con số dưới đây lấy từ trang model, trang giá và system card của chính Anthropic hoặc OpenAI, và chúng tôi ghi nguồn cho từng con số. Bài cũng trả lời ba câu được tìm nhiều nhất: Opus 5.5 có bao nhiêu tham số, nó có bị thụt lùi không, và "Sol" nghĩa là gì.
Claude Opus 5.5 có tốt hơn GPT-6 Sol không?
Xét benchmark đã công bố thì có. Xét giá mỗi token thì không, vì GPT-6 Sol rẻ bằng một nửa. Model nào "tốt hơn" với bạn tùy vào hai điều: khoảng cách chất lượng có hiện ra trong tác vụ của bạn không, và nó có đáng để trả gấp khoảng hai lần mỗi token không.
Bảng đối chiếu nhanh những gì mỗi hãng công bố:
| Claude Opus 5.5 | GPT-6 Sol | GPT-6.1 Sol (mới hơn) | |
|---|---|---|---|
| API ID | claude-opus-5-5 | gpt-6-sol | gpt-6.1-sol |
| Ngày ra mắt | 22/9/2026 | 22/9/2026 | 29/9/2026 |
| Input / output mỗi 1M token | $4 / $20 | $2 / $10 | $2 / $10 |
| Cache hit mỗi 1M | $0,20 | $0,20 | $0,10 |
| Batch | Giảm 50% ($2 / $10) | Giảm 50% ($1 / $5) | Giảm 50% ($1 / $5) |
| Context window | 1M token | 1,05M (input tối đa 922K) | 1,05M (input tối đa 922K) |
| Output tối đa | 128K | 128K | 128K |
| Phụ phí prompt dài | Không (1M vẫn giá chuẩn) | Trên 272K input: input x2, output x1,5 | Như GPT-6 Sol |
| Mốc kiến thức | 06/2026 | 20/4/2026 | 30/4/2026 |
| Điều khiển suy luận | Effort low → max, mặc định medium; thinking luôn bật | Effort none → max, mặc định medium | Effort low → max, mặc định medium (không có "none") |
| Số tham số | Không công bố | Không công bố | Không công bố |
Nguồn: tổng quan model Claude, bảng giá Claude, trang model OpenAI cho GPT-6 Sol và GPT-6.1 Sol, đọc ngày 13/11/2026.
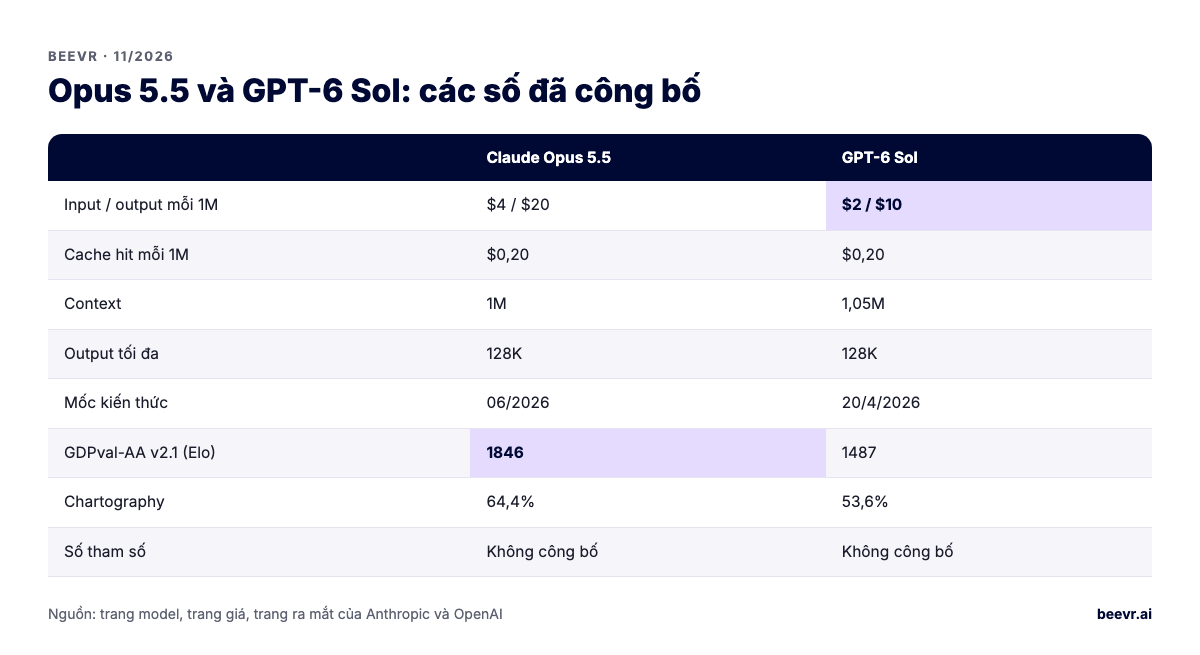
Claude Opus 5.5 và GPT-6 Sol so với nhau trên benchmark thế nào?
So sánh trực tiếp duy nhất nằm trên trang ra mắt Claude Sonnet 5.5 của Anthropic. Ở cả ba dòng chung, Opus 5.5 đều dẫn GPT-6 Sol: GDPval-AA v2.1 (1846 so với 1487 Elo), AA-Briefcase v1.1 (1822 so với 1483) và Chartography (64,4% so với 53,6%). Bài ra mắt GPT-6 Sol của OpenAI không có số benchmark dạng chữ để đối chiếu.
Khi đọc các số này, cần nhớ hai điều. Thứ nhất, phép so sánh do Anthropic chạy. Trang Sonnet 5.5 có ghi chú rằng điểm của GPT-6 Sol có thể chưa phản ánh các bản sửa mới nhất (OpenAI đã sửa lỗi mã hóa ảnh của GPT-6 Sol ngày 25/9). Thứ hai, chính Anthropic viết trên trang Opus 5.5 rằng chênh lệch benchmark ngày càng kém tin cậy khi dùng để đoán khác biệt ngoài thực tế.
Những chỗ hai hãng có công bố số
- Opus 5.5 so với model mạnh nhất của OpenAI: trên trang của Anthropic, Opus 5.5 đạt 66,4% trên Terminal-Bench 4.0, so với 57,9% của GPT-6 Astra. Astra dẫn ở AutomationBench (41,4% so với 40,0%) và Terminal-Bench-Science (64,6% so với 58,7%).
- GPT-6 Sol so với GPT-6.1 Sol: system card GPT-6.1 Sol của OpenAI cho thấy model mới dẫn ở SEC-Bench Pro (78,8% so với 66,3%), ExploitGym (35,1% so với 22,1%) và HealthBench (58,5 so với 53,2). Nó kém hơn chút ở tỷ lệ gian lận khi code (1,50% so với 1,30%; càng thấp càng tốt).
Nói thẳng: trên trang của cả hai hãng không có benchmark trung lập nào chạy Opus 5.5 và GPT-6 Sol trên cùng một harness. Bộ eval của chính bạn là phép so sánh duy nhất có giá trị.
Claude Opus 5.5 và GPT-6 Sol giá bao nhiêu mỗi triệu token?
Claude Opus 5.5 có giá $4 mỗi triệu token input và $20 mỗi triệu token output. GPT-6 Sol là $2 và $10. Cache hit đều là $0,20, và cả hai đều giảm 50% khi chạy batch. Khi input vượt 272K token, GPT-6 Sol tính input gấp đôi và output gấp 1,5 lần cho cả request. Opus 5.5 giữ nguyên một mức giá trên toàn bộ cửa sổ 1M.
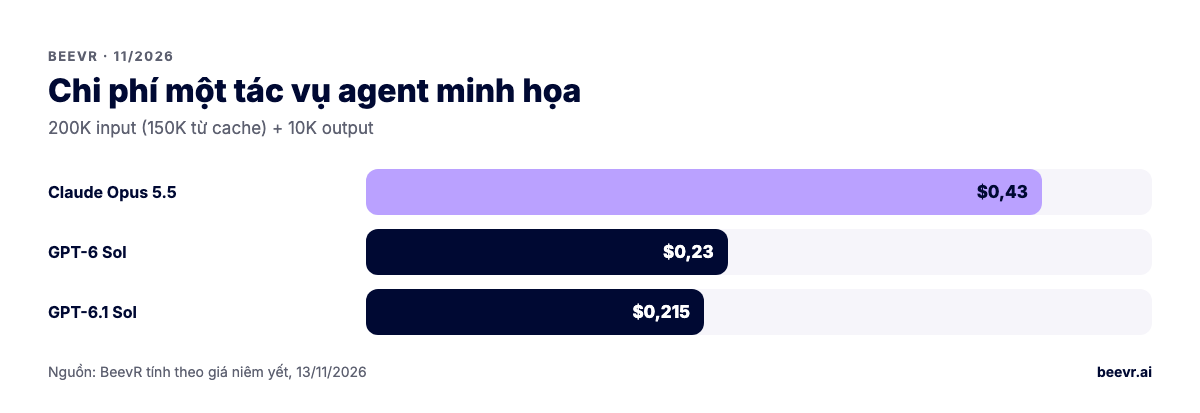
Giá mỗi token không phải giá mỗi tác vụ. Ví dụ minh họa một tác vụ agent: tổng 200K token input qua các lượt, trong đó 150K lấy từ cache, cộng 10K token output.
- Opus 5.5: 50K × $4 + 150K × $0,20 + 10K × $20 = $0,43 mỗi tác vụ
- GPT-6 Sol: 50K × $2 + 150K × $0,20 + 10K × $10 = $0,23 mỗi tác vụ
- GPT-6.1 Sol: 50K × $2 + 150K × $0,10 + 10K × $10 = $0,215 mỗi tác vụ
Thực tế có ba yếu tố làm kết quả này thay đổi. Hai hãng dùng tokenizer khác nhau, và Anthropic cho biết tokenizer hiện tại sinh nhiều hơn khoảng 30% token cho cùng một đoạn văn so với tokenizer trước bản 4.7. Thinking token của Claude được tính như output. Và model mạnh hơn có thể xong việc với ít lượt hơn: Anthropic nói Opus 5.5 rẻ hơn Opus 5 khoảng 40% trên workload thông thường ở cấu hình mặc định. Hãy đo số token cho mỗi tác vụ hoàn thành trên traffic thật của bạn. Bài so sánh giá API LLM làm cùng phép tính cho 11 model.
Context window của Claude Opus 5.5 và GPT-6 Sol là bao nhiêu?
Claude Opus 5.5 có context window 1M token và output tối đa 128K token. GPT-6 Sol có context window 1.050.000 token, trong đó input tối đa 922K và output tối đa 128K. Thực tế hai bên ngang nhau. Khác biệt nằm ở giá: Opus 5.5 tính cùng một giá mỗi token dù prompt 900K hay 9K, còn GPT-6 Sol áp giá context dài khi vượt 272K.
Trên Message Batches API của Claude, Opus 5.5 sinh được tới 300K token output nếu gửi beta header output-300k-2026-03-24. Cửa sổ lớn không có nghĩa là model nhớ tốt phần cuối cửa sổ, nên hãy test việc truy xuất với đúng kích thước tài liệu thật trước khi dựa vào nó.
Claude Opus 5.5 có bao nhiêu tham số?
Anthropic không công bố. Trang ra mắt Opus 5.5, trang tổng quan model và tài liệu giá đều không có số tham số, kích thước model hay chi tiết kiến trúc. OpenAI cũng không công bố số tham số của GPT-6 Sol. Mọi con số "Opus 5.5 parameters" bạn thấy trên mạng đều là ước đoán của bên thứ ba, không phải dữ kiện.
Các lab frontier mã đóng đã ngừng công bố kích thước model từ nhiều năm nay. Những gì họ có công bố lại hữu ích hơn khi chọn model:
- Giới hạn: context window, output tối đa, mốc kiến thức (06/2026 với Opus 5.5, 04/2026 với GPT-6 Sol).
- Giá và tốc độ: giá mỗi token, chiết khấu cache và batch, độ trễ tương đối. Anthropic xếp Opus 5.5 ở mức "Moderate" và cho biết model sinh output nhanh hơn Opus 5 trên 30%.
- Hành vi và an toàn: system card kèm các eval an toàn, như xếp hạng Preparedness của OpenAI hay kết quả alignment của Anthropic.
- Vòng đời: Anthropic cam kết không cho Opus 5.5 ngừng hoạt động trước ngày 22/9/2027.
Model open-weight thì thường có công bố số tham số. Ví dụ, changelog của Mistral ghi GLM 5.3 Flash của Z.ai là model mixture-of-experts 320B tham số, 18B active. Dù vậy, số tham số active cũng không nói được nhiều về việc model làm tác vụ của bạn tốt đến đâu.
Claude Opus 5.5 có bị thụt lùi so với Opus 5 không?
Theo benchmark Anthropic công bố thì không: Opus 5.5 vượt Opus 5 ở mọi dòng trong bảng ra mắt, chẳng hạn 66,4% so với 52,3% trên Terminal-Bench 4.0. Phần lớn phản ánh "Opus 5.5 regression" bắt nguồn từ thay đổi hành vi API làm hỏng tích hợp cũ, cộng với cơ chế fallback an toàn ở một số request.
Những thay đổi trông giống thụt lùi
- Effort mặc định thấp hơn. Opus 5.5 mặc định effort
medium, còn Opus 5 mặc địnhhigh. Nếu chưa bao giờ đặt effort, mỗi request của bạn sẽ được suy luận ít hơn. Hãy đặt rõ giá trị. - Không tắt được thinking.
thinking: {"type": "disabled"}trả lỗi 400. Code đọccontent[0].textcó thể hỏng vì response có thể bắt đầu bằng thinking block. - Tham số bị từ chối. Ép
tool_choice, đặt temperature/top_p/top_k khác mặc định và prefill câu trả lời đều bị từ chối. - Fallback an toàn. Anthropic cho biết trong benchmark, một số tác vụ an ninh mạng do Opus 4.8 hoàn thành và một số tác vụ sinh học do Opus 5 hoàn thành, vì lớp bảo vệ production đã can thiệp. Nếu workload của bạn chạm các mảng này, một số câu trả lời có thể đến từ model cũ hơn.
Từng thay đổi phá vỡ tương thích và kế hoạch chuyển đổi dựa trên eval có trong bài chuyển đổi model LLM lên GPT-6 Sol, Claude Opus 5.5. Nếu đã sửa hết những điểm trên mà chất lượng vẫn giảm thật, hãy cố định bộ eval và so các mức effort trước khi kết luận là do model.
"Sol" trong tên model OpenAI nghĩa là gì?
"Sol" là một tầng trong cách đặt tên của OpenAI, không phải một loại LLM riêng. Từ GPT-5.6, OpenAI đặt tên model theo năng lực và chi phí. Astra là mạnh nhất (chỉ có ở GPT-6). Sol là model tổng quát mạnh cho code phức tạp và agent. Terra là tầng giữa, nhanh và rẻ hơn. Luna tiết kiệm nhất, cho tác vụ khối lượng lớn.
Vậy "GPT-6 Sol" là tầng Sol của thế hệ GPT-6, còn "GPT-6.1 Sol" là bản cập nhật của nó. Trang models của OpenAI mô tả GPT-6.1 Sol cho hiệu năng gần bằng Astra với việc phức tạp mà chi phí thấp hơn. Trang giá ghi GPT-6 Astra $10/$50, hai model Sol $2/$10, GPT-6.1 Terra $1/$5 và GPT-6 Luna $0,10/$0,50.
Nên dùng GPT-6 Sol hay GPT-6.1 Sol?
Với dự án mới, chọn GPT-6.1 Sol: cùng giá $2/$10, cache hit rẻ bằng nửa ($0,10), mốc kiến thức mới hơn và điểm cao hơn trong system card của chính OpenAI. Chỉ nên ở lại GPT-6 Sol nếu bạn cần reasoning.effort: "none" (GPT-6.1 Sol không hỗ trợ), hoặc cần function calling qua Chat Completions ở mức effort đó.
GPT-6 Sol cũng là model OpenAI chỉ định thay cho gpt-5.1 và gpt-5.3-codex, hai model sẽ bị gỡ ngày 1/4/2027. Vì vậy GPT-6 Sol sẽ còn tồn tại một thời gian, và hiện chưa có ngày ngừng.
Chọn model nào cho AI agent chạy production?
Chọn Opus 5.5 khi tỷ lệ hoàn thành tác vụ đáng để trả gấp khoảng hai lần mỗi token: agent chạy nhiều bước dài, thay đổi code phức tạp, hay việc mà một câu trả lời sai tốn kém hơn tiền token. Chọn GPT-6.1 Sol khi khối lượng lớn, tác vụ được khoanh rõ phạm vi và eval cho thấy chênh lệch nhỏ. Nhiều hệ thống production dùng cả hai và định tuyến theo loại tác vụ.
- Dữ liệu có quy định: xem điều khoản dữ liệu trước benchmark. Cả hai hãng đều có BAA và zero data retention kèm điều kiện. Chạy inference chỉ ở Mỹ trên Claude tốn 1,1 lần giá, còn OpenAI cộng 10% cho xử lý theo vùng. Xem nhà cung cấp LLM ký BAA.
- Coding agent: nếu thứ bạn cần là công cụ cho developer chứ không phải API, hãy so sản phẩm agent, đừng chỉ so model. Xem các nền tảng AI dev agent 2026.
- Tầng nhỏ hơn: trước khi chọn một trong hai model flagship, hãy thử Sonnet 5.5 ($2/$10) và GPT-6.1 Terra ($1/$5). Bài các model Claude 2026 chỉ ra khi nào model nhỏ là đủ.
BeevR làm việc này thế nào
Khi khách hỏi "Opus hay Sol?", chúng tôi trả lời bằng dữ liệu của chính khách. Chúng tôi dựng bộ eval từ 200 đến 500 case thật, chạy cả hai model ở hai hoặc ba mức effort, rồi báo cáo tỷ lệ đạt, chi phí mỗi tác vụ hoàn thành và độ trễ p95. Phía sau là một interface model mỏng, nên lựa chọn chỉ là một giá trị config và đổi về sau rất rẻ. Với dự án có quy định, chúng tôi kiểm tra điều khoản lưu trữ, vùng xử lý và BAA của từng model trước khi bất kỳ dữ liệu test nào rời môi trường của khách. Khi cần, model chạy ngay trong tài khoản AWS của khách theo AWS BAA.
BeevR là đội senior do founder dẫn dắt tại Hà Nội, làm theo phạm vi cố định, giá cố định từ $10K mỗi giai đoạn, có demo chạy được mỗi thứ Sáu. Khách sở hữu code và IP ngay từ ngày đầu. Xem thêm về phát triển AI agent của chúng tôi.
Muốn so sánh model trên chính tác vụ của bạn? Đặt lịch gọi 30 phút.