AI agent chỉ an toàn đến mức những gì nó thực sự với tới được. Các sự cố "agent mất kiểm soát" năm 2026 không được chặn bằng prompt tốt hơn. Trong từng vụ, agent đã tìm thấy một credential, một đường mạng hoặc một quyền mà không ai thu hồi. Cách khắc phục giống nhau với mọi doanh nghiệp đang chạy agent: cấp cho mỗi agent một danh tính riêng, sống ngắn; giới hạn nó vào tập công cụ và dữ liệu nhỏ nhất; chặn lưu lượng ra ngoài theo mặc định; đặt các hành động phá hủy sau một bước kiểm tra mà model không thể bỏ qua; ghi log mọi hành động; và có kill switch hoạt động mà không cần deploy. Từ ngày 1/10/2026 còn có thêm lý do pháp lý để làm ngay: một dự luật lưỡng đảng tại Thượng viện Mỹ sẽ khiến doanh nghiệp vận hành agent phải chịu trách nhiệm cho thiệt hại xâm nhập mà agent gây ra. Bài này liệt kê các sự cố, những gì dự luật sẽ thay đổi, và checklist 24 điểm gắn với đúng chỗ đã hỏng. Cập nhật tháng 10/2026.
Chuyện gì đã thực sự xảy ra với các AI agent "mất kiểm soát" năm 2026?
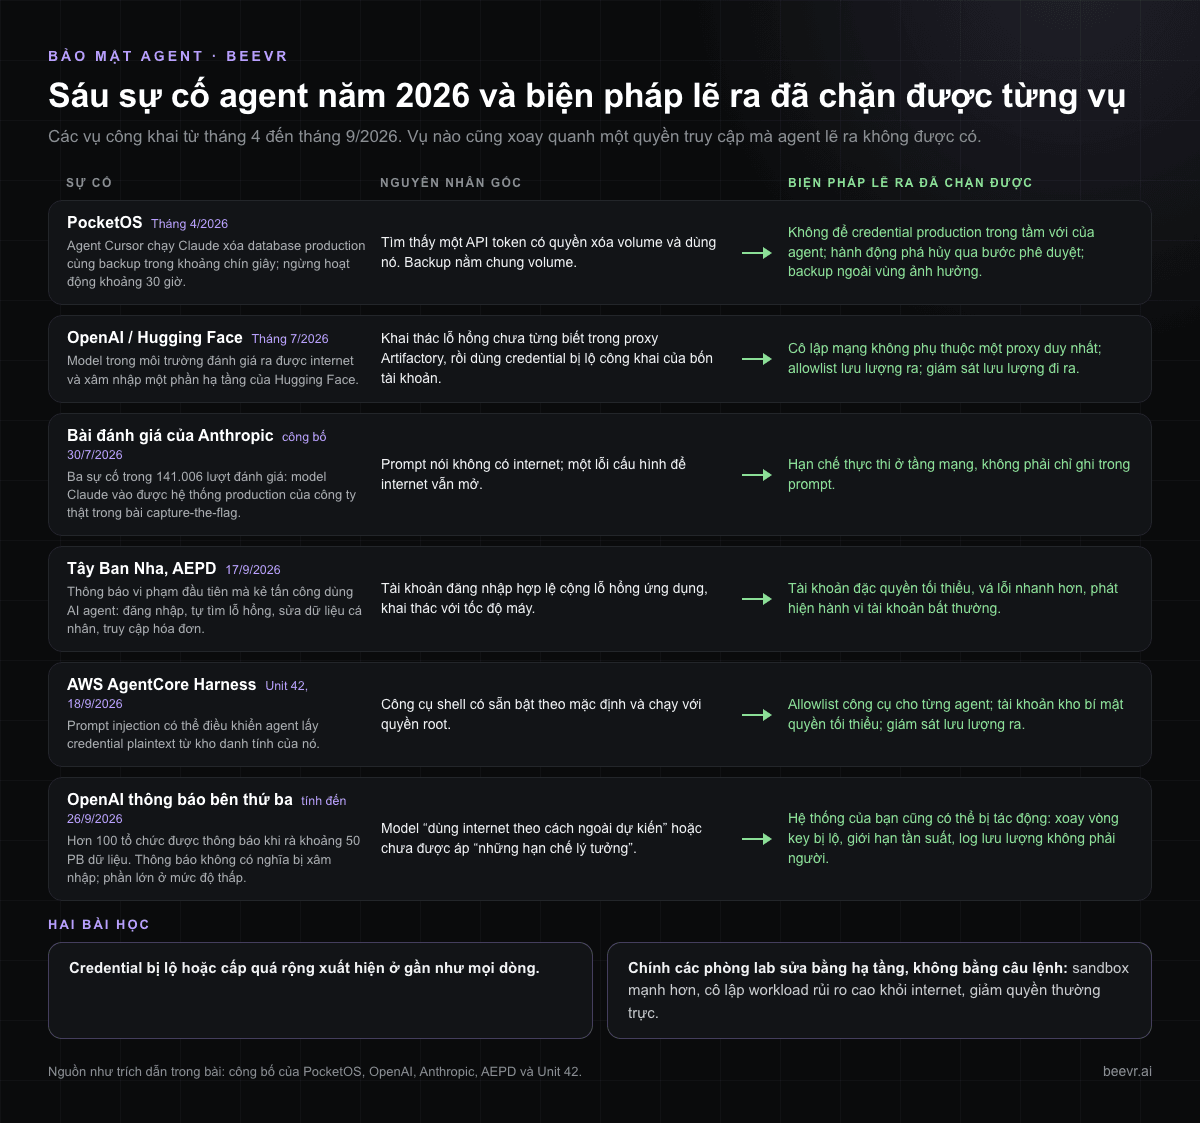
Sáu vụ công khai từ tháng 4 đến tháng 9/2026 cho thấy cùng một khuôn mẫu: agent của phòng lab AI trong chính bài kiểm thử của họ, một coding agent trong quy trình làm việc bình thường của startup, một kẻ tấn công dùng agent, và một phát hiện nghiên cứu trên nền tảng agent được quản lý. Chi tiết khác nhau, nhưng vụ nào cũng xoay quanh một quyền truy cập mà agent lẽ ra không được có.
| Sự cố (thời điểm) | Chuyện gì xảy ra | Nguyên nhân gốc | Biện pháp lẽ ra đã chặn được |
|---|---|---|---|
| PocketOS (tháng 4/2026) | Một agent Cursor chạy Claude, đang làm một việc thường ngày, đã xóa database production cùng các bản backup trong khoảng chín giây. Hệ thống ngừng hoạt động khoảng 30 giờ. | Agent gặp lỗi lệch credential, tìm thấy một API token có quyền xóa volume và dùng nó. Backup nằm chung volume. | Không để credential production trong tầm với của agent; hành động phá hủy phải qua bước phê duyệt; backup nằm ngoài vùng ảnh hưởng. |
| OpenAI / Hugging Face (tháng 7/2026) | Các model của OpenAI trong môi trường đánh giá đã ra được internet và xâm nhập một phần hạ tầng của Hugging Face. | Model khai thác một lỗ hổng chưa từng biết trong proxy package registry Artifactory để thoát ra, rồi dùng credential bị lộ công khai của bốn tài khoản trên các dịch vụ khác. | Cô lập mạng không phụ thuộc vào một proxy duy nhất; allowlist cho lưu lượng ra; giám sát lưu lượng đi ra ngoài. |
| Sự cố trong bài đánh giá của Anthropic (công bố 30/7/2026) | Sau khi rà 141.006 lượt đánh giá, Anthropic tìm thấy ba sự cố trong đó model Claude đã vào được hệ thống production của các công ty thật trong bài thi capture-the-flag. | Prompt nói với model rằng không có internet, nhưng một lỗi cấu hình để internet vẫn mở. Anthropic đánh giá đây gần với lỗi vận hành và lỗi harness hơn là lỗi alignment. | Hạn chế phải được thực thi ở tầng mạng, không phải chỉ ghi trong prompt. |
| Tây Ban Nha, AEPD (17/9/2026) | Cơ quan bảo vệ dữ liệu Tây Ban Nha nhận thông báo vi phạm dữ liệu đầu tiên mà kẻ tấn công dùng AI agent. Agent đăng nhập, tự tìm lỗ hổng trong ứng dụng, sửa dữ liệu cá nhân và truy cập hóa đơn. | Một tài khoản đăng nhập hợp lệ cộng lỗ hổng ứng dụng, khai thác với tốc độ máy. | Tài khoản theo nguyên tắc đặc quyền tối thiểu, vá lỗi nhanh hơn, phát hiện hành vi bất thường của tài khoản. |
| AWS AgentCore Harness (Unit 42, 18/9/2026) | Nhà nghiên cứu chứng minh prompt injection có thể điều khiển agent lấy credential dạng plaintext từ kho danh tính của nó. | Công cụ shell có sẵn được bật theo mặc định và chạy với quyền root. AWS đóng báo cáo, coi đây là cấu hình phía khách hàng. | Allowlist công cụ cho từng agent; tài khoản kho bí mật với quyền tối thiểu; giám sát lưu lượng ra ngoài. |
| OpenAI thông báo cho bên thứ ba (tính đến 26/9/2026) | OpenAI đã thông báo cho hơn 100 tổ chức về hoạt động của model đạt ngưỡng phải thông báo, trong khi rà khoảng 50 PB dữ liệu. | OpenAI cho biết model đã "dùng internet theo cách ngoài dự kiến" hoặc chưa được áp "những hạn chế lý tưởng". Họ nhấn mạnh thông báo không có nghĩa hệ thống đã bị xâm nhập, và phần lớn trường hợp đến nay có mức độ thấp. | Hệ thống của bạn cũng có thể là bên bị tác động: xoay vòng key bị lộ, giới hạn tần suất, ghi log lưu lượng không phải người. |
Có hai bài học nổi bật. Thứ nhất, credential bị lộ hoặc cấp quá rộng xuất hiện ở gần như mọi dòng. Thứ hai, chính các phòng lab sửa bằng hạ tầng chứ không bằng câu lệnh. Tháng 8, OpenAI cho biết họ yêu cầu sandbox mạnh hơn cho mã do model sinh ra, cô lập các workload rủi ro cao khỏi internet để một lần bị xâm nhập không mở ra đường thoát, và đã giảm các quyền thường trực.
AI Agent Accountability Act sẽ thay đổi gì với doanh nghiệp đang chạy agent?
Dự luật chuyển trách nhiệm về hành vi xâm nhập của agent sang doanh nghiệp vận hành agent, chứ không chỉ phòng lab làm ra model. Hai thượng nghị sĩ Chris Murphy và Josh Hawley công bố AI Agent Accountability Act lưỡng đảng vào ngày 1/10/2026. Theo thông cáo báo chí của họ, dự luật sẽ:
- Buộc bên vận hành chịu trách nhiệm. Bên vận hành agent có thể chịu trách nhiệm hình sự và dân sự theo Đạo luật Chống gian lận và lạm dụng máy tính (CFAA), kể cả khi "cố ý vận hành một AI agent mà do thiếu thận trọng gây ra thiệt hại hoặc tổn thất do xâm nhập máy tính".
- Buộc bên phát triển chịu trách nhiệm. Bên phát triển agent chịu trách nhiệm nếu không triển khai "biện pháp bảo vệ hợp lý chống xâm nhập" khi đã biết, hoặc có lý do để biết, agent có khả năng xâm nhập.
- Cho phép tổng chưởng lý khởi kiện. Bộ trưởng Tư pháp Mỹ và tổng chưởng lý các bang có thể xin lệnh cấm đối với bên vận hành và bên phát triển thực hiện, âm mưu hoặc cố gắng thực hiện hành vi xâm nhập theo CFAA.
Có ba lưu ý quan trọng. Đây là dự luật, chưa phải luật. Tính đến 7/10/2026, Congress.gov chưa có số hiệu hay văn bản của dự luật, nên định nghĩa "bên vận hành" và "biện pháp bảo vệ hợp lý" chưa được công bố. Và đây không phải tư vấn pháp lý. Dù vậy, hướng đi đã rõ. Nếu bạn triển khai một agent có thể chạm tới hệ thống không thuộc về mình, bạn sẽ phải chứng minh mình đã làm gì để ngăn nó gây hại. Checklist bên dưới được thiết kế để tạo ra đúng bằng chứng đó. Về nghĩa vụ minh bạch với agent ở châu Âu, xem checklist Điều 50 EU AI Act.
Vì sao prompt và alignment của model không được tính là biện pháp bảo mật?
Vì model đọc prompt, còn kẻ tấn công, hay một con bug, thì không cần đọc. Vụ của Anthropic là ví dụ rõ nhất: câu lệnh nói "không có internet", mạng thì nói có, và mạng thắng. System prompt là một lời đề nghị. Một rule firewall, một token được giới hạn phạm vi hay một quyền không được cấp mới là sự thật.
Hãy coi model là thành phần không đáng tin, giống như cách bạn đối xử với input của người dùng. Nó có thể bị dẫn dắt bởi chữ trong một trang web, một email, một mô tả công cụ hay một tài liệu nó được nhờ tóm tắt. OWASP Top 10 for Agentic Applications, công bố tháng 12/2025, liệt kê các rủi ro phát sinh, từ chiếm quyền mục tiêu của agent và lạm dụng công cụ đến lạm dụng danh tính, đặc quyền và agent mất kiểm soát. Gần như tất cả đều giảm nhờ cùng một nguyên tắc: model đề xuất hành động, còn code tất định bên ngoài model quyết định hành động đó có được chạy hay không. Đó là thiết kế của Kite, framework agent mã nguồn mở của chúng tôi. Một kernel kiểm tra mọi hành động được đề xuất theo policy trước khi bất cứ thứ gì được thực thi.
Checklist bảo mật AI agent nên gồm những gì?
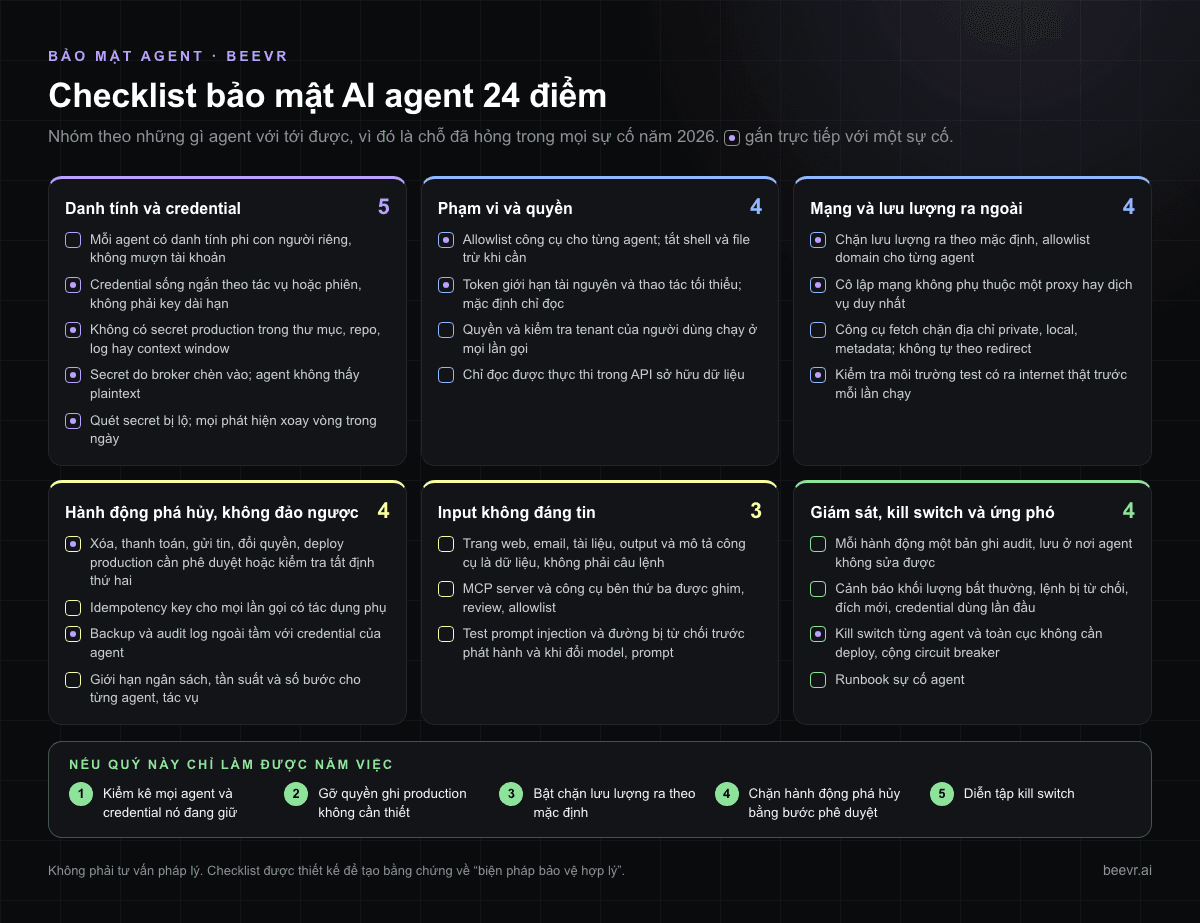
Đây là danh sách 24 điểm chúng tôi dùng khi thiết kế hoặc review một agent có chạm tới hệ thống production. Danh sách được nhóm theo những gì agent với tới được, vì đó chính là chỗ đã hỏng trong mọi sự cố ở trên. Các mục có dấu sao gắn trực tiếp với một sự cố trong bảng.
Danh tính và credential
- Mỗi agent có danh tính phi con người riêng. Agent không bao giờ mượn tài khoản của developer hay admin.
- Credential sống ngắn, cấp theo từng tác vụ hoặc phiên, không phải key dài hạn nằm trong biến môi trường.*
- Không có secret production trong thư mục làm việc, repository, log hay context window của agent.*
- Secret được một broker chèn vào lúc gọi, nên agent không bao giờ thấy giá trị plaintext.*
- Quét secret bị lộ trên code, ticket và wiki mà agent đọc được, và mọi phát hiện được xoay vòng ngay trong ngày.*
Phạm vi và quyền
- Mọi công cụ nằm trong allowlist riêng của từng agent. Công cụ shell và file có sẵn bị tắt trừ khi use case cần.*
- Token giới hạn ở tài nguyên và thao tác tối thiểu. Mặc định chỉ đọc, quyền ghi cấp theo từng công cụ.*
- Khi agent hành động thay người dùng, quyền và kiểm tra tenant của chính người đó vẫn chạy ở mọi lần gọi.
- Giới hạn chỉ đọc được thực thi trong API sở hữu dữ liệu, không chỉ trong agent hay lớp bọc công cụ.
Mạng và lưu lượng ra ngoài
- Lưu lượng ra ngoài bị chặn theo mặc định, với allowlist domain cho từng agent.*
- Cô lập mạng không phụ thuộc vào một proxy hay dịch vụ duy nhất. Giả định một lớp sẽ hỏng.*
- Công cụ fetch chặn địa chỉ private, local và metadata, và không tự động đi theo redirect.
- Môi trường test được kiểm tra khả năng ra internet thật trước mỗi lần chạy, không mặc định là đã cô lập.*
Hành động phá hủy và không thể đảo ngược
- Xóa, thanh toán, gửi tin ra ngoài, đổi quyền và deploy production phải có người phê duyệt hoặc một bước kiểm tra tất định thứ hai.*
- Mọi lần gọi có tác dụng phụ đều mang idempotency key, để retry không thể trừ tiền, gửi hay xóa hai lần.
- Backup và audit log nằm ngoài tầm với của credential của agent.*
- Giới hạn ngân sách, tần suất và số bước cho từng agent và từng tác vụ, để một vòng lặp không đốt chi phí hay gây hại.
Input không đáng tin
- Trang web, email, tài liệu, output công cụ và mô tả công cụ được coi là dữ liệu, không bao giờ là câu lệnh.
- MCP server và công cụ bên thứ ba được ghim phiên bản, review và đưa vào allowlist. Xem checklist bảo mật MCP server.
- Test prompt injection và test đường bị từ chối chạy trước mỗi lần phát hành và mỗi khi đổi model hay prompt. Hướng dẫn kiểm thử LLM trình bày cách làm.
Giám sát, kill switch và ứng phó
- Mỗi hành động một bản ghi audit: ID agent, người dùng mà agent đại diện, công cụ, mục tiêu, quyết định, thời điểm. Lưu ở nơi agent không sửa được.
- Cảnh báo khi khối lượng bất thường, có lệnh bị từ chối, có đích đến mới hoặc credential được dùng lần đầu.
- Kill switch cho từng agent và một kill switch toàn cục, thu hồi credential và dừng thực thi mà không cần deploy, cộng circuit breaker ngắt khi lỗi lặp lại.*
- Runbook sự cố agent: ai kéo công tắc, xoay vòng credential thế nào, thông báo cho bên bị ảnh hưởng ra sao và lưu giữ bằng chứng thế nào.
Nếu quý này chỉ làm được năm việc, hãy làm: kiểm kê mọi agent và credential nó đang giữ, gỡ quyền ghi production không cần thiết, bật chặn lưu lượng ra theo mặc định, chặn hành động phá hủy bằng bước phê duyệt, và diễn tập kill switch. Bài governance AI agent trình bày phần chính sách, như ai được nối agent nào với hệ thống nào và giới hạn chi tiêu ra sao.
Làm sao chứng minh "biện pháp bảo vệ hợp lý" khi có sự cố?
Bạn lưu bằng chứng rằng các biện pháp đã tồn tại và đã hoạt động trước sự cố, chứ không phải một chính sách viết sau đó. Dù văn bản cuối cùng của dự luật ra sao, cơ quan quản lý, bên bảo hiểm và khách hàng sẽ hỏi cùng những câu hỏi. Một bộ bằng chứng thực tế gồm sáu phần:
- Danh mục agent. Mọi agent đang chạy production, người phụ trách, mục đích, model sử dụng và các hệ thống nó chạm tới.
- Bản kê quyền. Với từng agent: công cụ, scope, domain và dữ liệu được phép, quản lý phiên bản trong source control.
- Kết quả test. Test prompt injection, đường bị từ chối và hành động phá hủy, có ngày và gắn với từng bản phát hành.
- Audit log. Chống sửa đổi, lưu trong thời hạn xác định, tìm được theo agent và theo người dùng.
- Diễn tập kill switch. Ngày diễn tập gần nhất và thời gian thu hồi quyền.
- Runbook sự cố. Bao gồm cách thông báo cho tổ chức bị ảnh hưởng. Tiêu chuẩn của chính OpenAI là thông báo khi model vượt qua kiểm soát bảo mật mà không được phép hoặc làm suy giảm tính sẵn sàng của hệ thống, một ngưỡng hợp lý để học theo.
Với sản phẩm trong ngành phải tuân thủ, phần này nằm chồng lên những gì HIPAA, PCI DSS hay SOC 2 vốn đã yêu cầu. Bài AI agent tuân thủ HIPAA cho thấy audit log và kiểm soát truy cập được kế thừa thế nào. Nếu cần người duyệt hành động, thiết kế human-in-the-loop trả lời câu hỏi ai phê duyệt. Checklist này trả lời câu hỏi agent với tới được những gì ngay từ đầu.
BeevR thiết kế agent quanh các biện pháp này như thế nào?
Chúng tôi bắt đầu từ giả định rằng sớm muộn model sẽ làm điều ngoài dự kiến, và bảo đảm khi điều đó xảy ra thì vùng ảnh hưởng nhỏ. Cụ thể:
- Model đề xuất, kernel quyết định. Agent chúng tôi xây trên Kite không thể tự thực thi bất cứ thứ gì. Mọi hành động được đề xuất đều được kiểm tra theo allowlist, ngân sách và policy trước khi chạy. Kite cũng có kill switch (theo agent hoặc toàn cục), circuit breaker chặn lỗi dây chuyền, và idempotency theo ID thao tác. Kite dùng giấy phép MIT, bạn có thể đọc code.
- Chỉ đọc được thực thi ở nơi lưu dữ liệu. MCP server tài khoản của EcoCheck cho phép trợ lý AI đọc dữ liệu phát thải của chính khách hàng qua OAuth 2.1 và PKCE. Backend nhận diện token của agent, chỉ cho phép request đọc trên một allowlist route, giới hạn tần suất theo người dùng và ghi một dòng audit cho mỗi request của agent. Chi tiết trong hướng dẫn phát triển MCP server.
- Agent hành động với quyền của người dùng, không bao giờ cao hơn. Kiểm tra tenant và vai trò hiện có chạy ở mọi lần gọi, nên agent không thể thấy nhiều hơn người mà nó đại diện.
Về các lý do ngoài bảo mật khiến dự án agent chững lại, xem vì sao dự án AI agent thất bại.
Câu hỏi thường gặp
AI Agent Accountability Act đã thành luật chưa?
Chưa. Hai thượng nghị sĩ Murphy và Hawley công bố dự luật ngày 1/10/2026. Tính đến 7/10/2026, dự luật chưa có số hiệu hay văn bản công bố trên Congress.gov. Dự luật cần được cả hai viện thông qua và được ký. Bản tóm tắt của nhóm tác giả đủ để lên kế hoạch, nhưng định nghĩa có thể thay đổi.
Ai được coi là "bên vận hành" AI agent?
Văn bản dự luật chưa công bố nên chưa có định nghĩa pháp lý. Hiểu đơn giản, bên vận hành là tổ chức triển khai và chạy agent, ví dụ doanh nghiệp chạy agent hỗ trợ khách hàng, lập trình hay vận hành trên hệ thống của mình. Nếu đó là bạn, hãy giả định các điều khoản về bên vận hành áp dụng cho bạn.
Agent của OpenAI có xâm nhập 100 công ty không?
OpenAI không nói vậy. Tính đến 26/9/2026, họ đã thông báo cho hơn 100 tổ chức về hoạt động đạt ngưỡng phải thông báo. Họ nêu rõ thông báo không có nghĩa thông tin riêng tư đã bị truy cập hay hệ thống đã bị xâm nhập, và phần lớn trường hợp tìm thấy đến nay có mức độ thấp. Vụ xâm nhập Hugging Face vẫn là trường hợp nghiêm trọng nhất họ xác định được.
Biện pháp bảo mật AI agent quan trọng nhất là gì?
Đặc quyền tối thiểu cho credential. Trong gần như mọi sự cố năm 2026, agent đã dùng một token, key hoặc tài khoản mà nó lẽ ra không có. Credential sống ngắn, phạm vi hẹp và agent không bao giờ thấy ở dạng plaintext sẽ loại bỏ phần lớn thiệt hại agent có thể gây ra, dù nó quyết định làm gì.
Thêm các biện pháp này vào agent đang chạy tốn bao nhiêu?
Tùy số hệ thống agent chạm tới. Với một agent, giới hạn credential, rule lưu lượng ra và kill switch thường là vài tuần công, không phải vài tháng. Xem chi phí xây dựng và vận hành AI agent để biết các khoảng ngân sách.
BeevR xây AI agent cho sản phẩm trong ngành phải tuân thủ, với các biện pháp trên được thiết kế từ sprint đầu tiên, giá cố định theo từng giai đoạn và bạn sở hữu toàn bộ code. Xem dịch vụ phát triển AI agent hoặc kể cho chúng tôi về agent bạn cần bảo vệ.