Phần lớn chuyện "Claude Opus 5.5 thụt lùi" là do API đổi, không phải model kém đi. Effort mặc định giờ là medium (Opus 5 dùng high), không tắt được thinking, chữ giữa các lần gọi tool nằm trong thinking block rỗng theo mặc định, và ép tool_choice trả lỗi 400. Hãy đặt effort rõ ràng, đọc block theo type, chạy lại golden set.
Cập nhật 13/11/2026. Ở phía OpenAI có hai model "Sol" và rất hay bị nhầm: gpt-5.6-sol, model flagship của GPT-5.6, và gpt-6-sol, bậc rẻ hơn nằm dưới GPT-6 Astra, nay đã có bản kế nhiệm gpt-6.1-sol. Các hạn chót đang buộc phải chuyển: OpenAI tắt GPT-5.1, GPT-5.3-Codex và GPT-5.4-Nano trên API ngày 01/04/2027, GPT-5 và o3 bản gốc ngày 11/12/2026, còn Anthropic khai tử Claude Sonnet 4.5 ngày 30/11/2026. Đừng chỉ đổi model ID. Hãy chốt một bộ golden test từ traffic thật, sửa các thay đổi phá vỡ API, tinh chỉnh lại prompt và effort, chạy shadow model mới trên traffic thật, rồi chuyển dần kèm phương án dự phòng. Với phần lớn ứng dụng production, việc này mất hai đến sáu tuần.
Tên model, tham số, hạn chót và giá trong bài đã được kiểm tra lại trên các trang model, deprecation và bảng giá của Anthropic, OpenAI và Google ngày 13/11/2026. Giá token cho từng kiến trúc có trong bài chi phí phát triển ứng dụng AI. Kế hoạch eval đủ để qua auditor có trong bài kiểm thử LLM cho ngành tuân thủ.
Claude Opus 5.5 có thật sự thụt lùi, hay là API đã đổi?
Chủ yếu là API và các giá trị mặc định đã đổi. Anthropic liệt kê bốn thay đổi phá vỡ và nhiều khác biệt hành vi so với Opus 5, và mỗi thay đổi đều có thể trông như chất lượng giảm nếu code của bạn vẫn giả định hành vi của Opus 5. Hãy kiểm tra các điểm này trước khi kết luận model kém đi.
| Người dùng phàn nàn | Nguyên nhân thường gặp trên Opus 5.5 | Cách sửa |
|---|---|---|
| "Câu trả lời nông hơn Opus 5" | Effort mặc định là medium; Opus 5 mặc định high | Đặt output_config.effort rõ ràng và chạy effort sweep |
| "Agent im lặng giữa các lần gọi tool" | Chữ giữa các lần gọi tool giờ trả về dạng thinking block, rỗng khi để mặc định display: "omitted" | Đặt thinking.display là "updates" (beta) hoặc "summarized" và hiển thị các thinking block không rỗng |
| "Câu trả lời bị cắt" hoặc "chi phí tăng" | Thinking luôn bật và tính vào max_tokens; ở cùng mức effort, model cũng có xu hướng nghĩ nhiều hơn mỗi lượt so với Opus 5 | Tăng max_tokens (bắt đầu từ 64k ở xhigh hoặc max), hạ effort ở chỗ chất lượng vẫn giữ được |
| "Parser lỗi" hoặc "mất chữ" | Response có thể bắt đầu bằng thinking block, nên đọc content[0].text là sai | Chọn content block theo type |
| "Nó từ chối những việc Opus 5 vẫn làm" | Một classifier sinh học giờ chạy cùng classifier an ninh mạng, trả về stop_reason: "refusal" | Xử lý refusal và cấu hình fallback (xem bên dưới) |
| "Lỗi 400 sau khi chuyển" | Tắt thinking, đặt budget thủ công, ép tool_choice, tham số sampling, prefill, phiên bản tool computer use cũ, hoặc sửa lịch sử hội thoại | Xem danh sách tham số ở phần tiếp theo |
Cũng có những đánh đổi năng lực thật, và Anthropic nói khá thẳng về một số điểm. Bài ra mắt (22/9/2026) cho thấy GPT-6 Astra dẫn trên Terminal-Bench-Science (64,6% so với 58,7%), ghi rằng các lần can thiệp của safeguard làm giảm một số điểm benchmark, và nói rằng chênh lệch benchmark đã trở thành thước đo kém tin cậy hơn cho khác biệt ngoài thực tế. Đó là lý do nên kiểm thử trên chính case của bạn thay vì tin biểu đồ ra mắt hay một chủ đề trên diễn đàn.
Những tham số API nào đã thay đổi trong Claude Opus 5.5?
Sáu nhóm thiết lập request giờ trả lỗi 400 trên claude-opus-5-5: thinking bị tắt hoặc có budget thủ công, ép tool_choice, temperature/top_p/top_k, prefill phía assistant, và các phiên bản tool computer use khác toolset mới. Effort là cách duy nhất điều khiển độ sâu suy nghĩ. Danh sách này lấy từ hướng dẫn chuyển đổi Opus 5.5 của Anthropic:
- Thinking. Không gửi trường
thinking, hoặc gửi{"type": "adaptive"}, hai cách tương đương.{"type": "disabled"}và{"type": "enabled", "budget_tokens": N}bị từ chối. - Effort.
output_config.effortnhậnlow,medium,high,xhighvàmax. Mặc định làmedium. Không cần các beta headereffort-2025-11-24vàinterleaved-thinking-2025-05-14nữa. - Hiển thị thinking.
thinking.displaymặc định là"omitted". Dùng"summarized"để nhận bản tóm tắt dễ đọc, hoặc"updates"(beta headerthinking-display-updates-2026-08-18) để chỉ nhận cập nhật tiến độ. - Tool choice. Chỉ
auto(mặc định) vànone.anyvà chỉ định một tool cụ thể bị từ chối, kể cả ở endpoint đếm token. Dùng toolstrict: truehoặc structured outputs. - Sampling. Bỏ
temperature,top_pvàtop_k. Trang deprecation của Anthropic cho biết API version2026-10-21gỡ chúng cho mọi model; các API version cũ hơn từ chối giá trị khác mặc định trên Claude 4.7 trở lên. - Prefill. Lượt assistant điền sẵn ở cuối bị từ chối, như trên Opus 4.6 trở lên. Dùng structured outputs hoặc chỉ dẫn trong system prompt.
- Thinking block. Gửi lại nguyên vẹn trong vòng lặp tool. Block gắn với model và với cuộc hội thoại: sửa system prompt, tools hoặc tin nhắn trước đó có thể làm hỏng bước kiểm tra prefix, nên hãy đổi chỉ dẫn bằng system message giữa hội thoại.
- Computer use. Khai báo
computer_toolset_20260801;computer_20251124chỉ chạy trên Amazon Bedrock. - Service tier và vùng xử lý. Không hỗ trợ Priority Tier. Suy luận chỉ tại Mỹ với
inference_geo: "us"có giá 1,1 lần. Fast mode bật bằngspeed: "fast".
Prompt caching cũng thay đổi theo hướng có lợi: đọc cache có giá $0,20 mỗi triệu token, và prompt từ 512 token trở lên đã có thể được cache.
Model nào sắp bị khai tử, và khi nào?
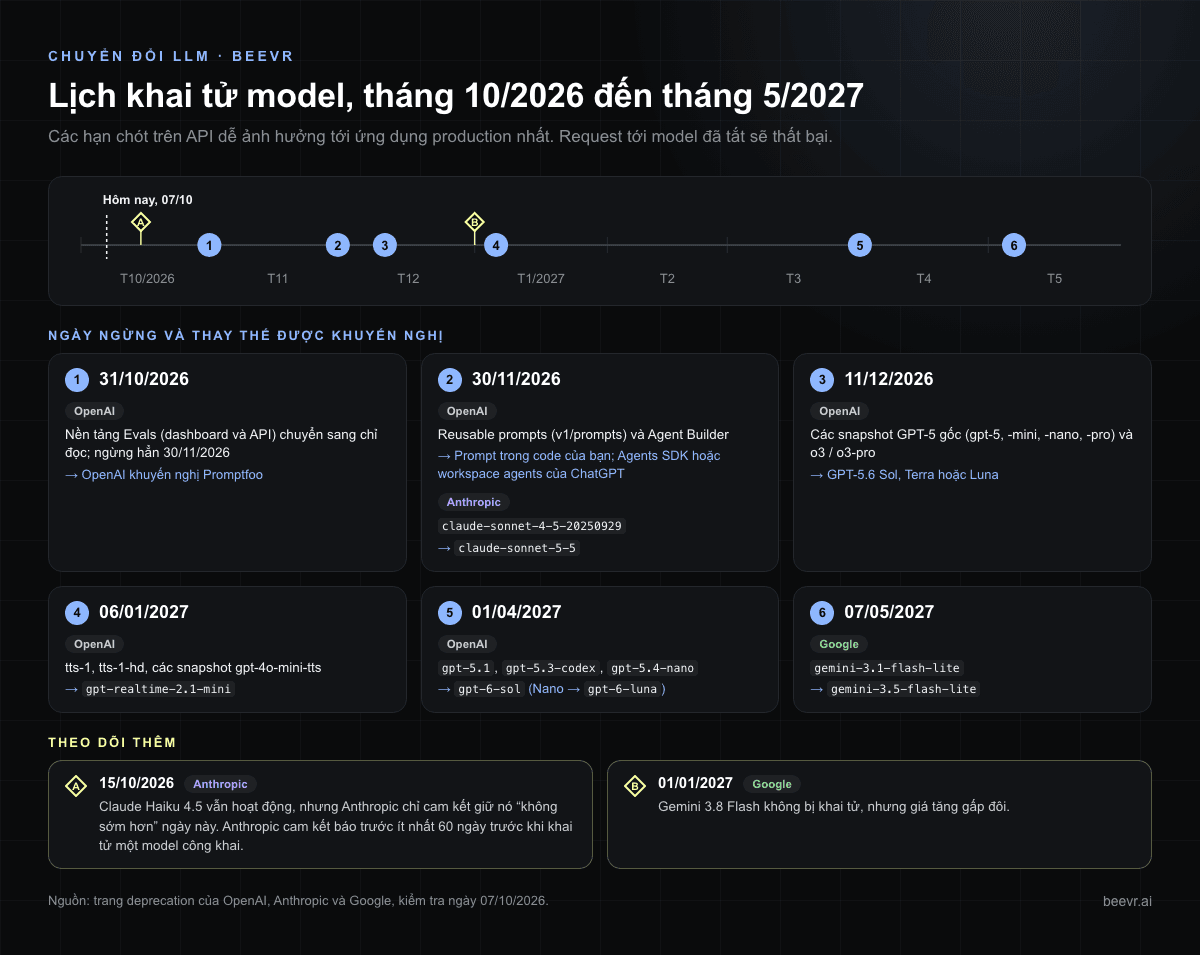
Đây là các hạn chót trên API dễ ảnh hưởng tới ứng dụng production nhất trong sáu tháng tới, theo trang deprecation của các nhà cung cấp ngày 13/11/2026:
| Ngày tắt | Nhà cung cấp | Thứ bị khai tử | Thay thế được khuyến nghị | Ngày thông báo |
|---|---|---|---|---|
| 30/11/2026 (chỉ đọc từ 31/10) | OpenAI | Nền tảng Evals (dashboard và API) | OpenAI khuyên dùng Promptfoo | 03/06/2026 |
| 30/11/2026 | OpenAI | Reusable prompts (v1/prompts) và Agent Builder | Đưa prompt vào code của bạn; Agents SDK hoặc ChatGPT Workspace Agents | 03/06/2026 |
| 30/11/2026 | Anthropic | claude-sonnet-4-5-20250929 | claude-sonnet-5-5 | 30/09/2026 |
| 11/12/2026 | OpenAI | Snapshot gpt-5 và o3 bản gốc | gpt-5.6-sol | 11/06/2026 |
| 06/01/2027 | OpenAI | tts-1 | gpt-realtime-2.1-mini | 01/10/2026 |
| 01/02/2027 | OpenAI | gpt-5.5-cyber-preview | Model cyber mạnh nhất bạn được dùng | 05/11/2026 |
| 01/04/2027 | OpenAI | gpt-5.1, gpt-5.3-codex, gpt-5.4-nano | gpt-6-sol (Nano → gpt-6-luna) | 01/10/2026 |
| 07/05/2027 (sớm nhất) | gemini-3.1-flash-lite | gemini-3.5-flash-lite | Xem trang deprecation của Gemini |
Hãy để ý thêm ba mốc. Claude Haiku 4.5 và Claude Opus 4.5 vẫn đang hoạt động, nhưng Anthropic chỉ cam kết giữ chúng "không sớm hơn" 15/10 và 24/11/2026, nên thông báo khai tử có thể đến bất cứ lúc nào; Anthropic hứa báo trước ít nhất 60 ngày trước khi khai tử một model đã phát hành công khai. Gemini 3.8 Flash không bị khai tử, nhưng giá tăng gấp đôi từ 01/01/2027, lên $1,50 đầu vào và $7,50 đầu ra mỗi triệu token. Và nếu bộ regression test vẫn nằm trên nền tảng Evals của OpenAI, hãy export ngay: nền tảng đã ở chế độ chỉ đọc và tắt hẳn ngày 30/11.
Sol, model của OpenAI, là gì?
Sol là tên một bậc trong các dòng model của OpenAI, không phải sản phẩm riêng. Trong GPT-5.6, Sol là flagship (gpt-5.6-sol), bên dưới là Terra và Luna. Trong GPT-6, flagship là Astra, còn Sol (gpt-6-sol, nay là gpt-6.1-sol) là bậc rẻ hơn mà OpenAI mô tả là hiệu năng gần Astra với chi phí thấp hơn.
| Model ID | Vai trò trong dòng model | Giá mỗi 1M token (đầu vào / đầu ra) | Các mức reasoning effort |
|---|---|---|---|
gpt-6-astra | Flagship GPT-6, mặc định OpenAI khuyên dùng | $10 / $50 | low đến max |
gpt-6.1-sol | Hiệu năng gần Astra, chi phí thấp hơn | $2 / $10 (đầu vào cache $0,10) | low đến max, không có none |
gpt-6-sol | GPT-6 Sol bản trước; thay thế GPT-5.1 và GPT-5.3-Codex | $2 / $10 (đầu vào cache $0,20) | none đến max |
gpt-6-luna | Tiết kiệm nhất, cho khối lượng lớn | $0,10 / $0,50 | none đến max |
gpt-5.6-sol | Flagship GPT-5.6; alias gpt-5.6 trỏ về đây | Niêm yết $4 / $20 (OpenAI ghi giá khuyến mãi tới 30/11/2026) | none đến max |
gpt-5.5 | Flagship trước, chưa có ngày tắt | $5 / $30 | none đến xhigh |
Tất cả đều có context window 1,05 triệu token (đầu vào tối đa 922K) và đầu ra tối đa 128K theo trang model của OpenAI. Nếu bạn tìm "Sol LLM" nhưng muốn nói một dự án mã nguồn mở trùng tên, thì đó không phải model này.
Chuyển từ GPT-5.5 sang GPT-5.6 Sol thế nào?
Đổi model sang gpt-5.6-sol, giữ mức reasoning effort của GPT-5.5 làm mốc và thử thấp hơn một bậc, thay prompt_cache_retention bằng prompt_cache_options.ttl: "30m", và rà lại chỉ dẫn về độ ngắn gọn, vì GPT-5.6 mặc định đã ngắn gọn hơn. Sau đó chạy bộ golden test trước khi chuyển traffic.
- Model ID. Dùng
gpt-5.6-sol, hoặc aliasgpt-5.6trỏ về Sol. Trên production hãy ghim ID đầy đủ để alias đổi không gây bất ngờ. - Reasoning effort. GPT-5.6 thêm mức
maxvà hỗ trợ từnoneđếnmax. Hướng dẫn prompt cho GPT-5.6 Sol của OpenAI khuyên giữ effort hiện tại của GPT-5.5 làm mốc và so với mức thấp hơn một bậc, chỉ dùnghighhoặcxhighkhi eval cho thấy có lợi, và đểmaxcho việc khó nhất, ưu tiên chất lượng. - Độ dài câu trả lời. GPT-5.6 có xu hướng ngắn gọn hơn GPT-5.5 theo mặc định. Bỏ các chỉ dẫn chung kiểu "hãy ngắn gọn" khiến câu trả lời giờ bị cụt, và dùng
text.verbositythay thế. - Cache. Thay
prompt_cache_retentionbằngprompt_cache_options.ttlđặt là"30m", và rà lại ranh giới cache cùng cách tính phí ghi cache. - Tool. Chỉ đưa các tool liên quan tới tác vụ, để model chạy song song các lần đọc độc lập, và kiểm thử riêng đầu ra của programmatic tool calling với câu trả lời cuối nếu bạn dùng tính năng này.
- Chi phí. Theo giá niêm yết, GPT-5.6 Sol rẻ hơn GPT-5.5 mỗi token ($4 / $20 so với $5 / $30). Hãy kiểm tra lại sau khi đợt giá khuyến mãi kết thúc ngày 30/11/2026.
Trước khi chốt, hãy tính cả phương án nhảy thẳng lên gpt-6.1-sol với giá $2 / $10. Cách này bỏ qua một lần chuyển đổi, nhưng bắt buộc dùng Responses API để gọi tool và không có effort none, nên phần sửa code lớn hơn. Phần tiếp theo trình bày chi tiết.
Điều gì sẽ hỏng khi chuyển sang GPT-6 Sol hoặc Claude Opus 5.5?
Cả hai nhà cung cấp đều biến những thiết lập request từng vô hại thành lỗi cứng. Chỉ đổi chuỗi model sẽ hỏng trên production. Đây là các thay đổi được liệt kê trong hướng dẫn chuyển đổi của họ ("Using GPT-6" của OpenAI và hướng dẫn Opus 5.5 của Anthropic):
| Hạng mục | GPT-6 Sol / GPT-6.1 Sol / GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|
| Tham số sampling | Bỏ temperature, top_p và top_logprobs khi reasoning effort khác none (và logprobs trên Chat Completions) | Bỏ temperature, top_p và top_k; API version 2026-10-21 từ chối chúng với lỗi 400 |
| Suy luận / thinking | Các mức effort tới max, mặc định medium. GPT-6.1 Sol và GPT-6 Astra không có none; dùng low. Thay minimal bằng low rồi so sánh | Adaptive thinking luôn bật. thinking: disabled và budget thủ công bị từ chối. Effort là cách điều khiển duy nhất, mặc định medium (Opus 5 mặc định high) |
| Gọi tool | GPT-6.1 Sol, GPT-6.1 Terra và GPT-6 Astra cần Responses API để gọi tool. Trên Chat Completions, GPT-6 Sol và Luna chỉ gọi function ở effort none | Ép tool (any hoặc chỉ định tool) bị từ chối. Dùng auto với strict tools hoặc structured outputs |
| Cấu trúc response | Thiết lập suy luận làm đổi độ dài đầu ra và độ trễ | Response có thể bắt đầu bằng thinking block, nên code đọc content[0].text sẽ hỏng. Thinking block phải được gửi lại nguyên vẹn trong vòng lặp tool |
| Prefill và cache | Thay prompt_cache_retention bằng prompt_cache_options.ttl đặt là "30m" | Prefill phía assistant bị từ chối; dùng structured outputs hoặc chỉ dẫn hệ thống |
| An toàn và từ chối | Kiểm tra từ chối trên các edge case của chính bạn | stop_reason: "refusal" kèm stop_details.category, nay có thêm "bio", có tùy chọn fallback phía server |
| Vùng xử lý | Fast mode với lưu trữ dữ liệu tại EU chạy trên GPT-6.1 Sol và GPT-6 Luna, không chạy trên GPT-6 Sol hay GPT-6 Astra | Suy luận chỉ tại Mỹ có giá 1,1 lần |
Hai trong số này gây thụt lùi âm thầm chứ không báo lỗi. Trên Opus 5.5, chữ model viết giữa các lần gọi tool giờ nằm trong thinking block, mặc định rỗng, nên ứng dụng từng stream các cập nhật tiến độ đó sẽ im lặng mà không có exception nào. Và trên GPT-6 Sol lẫn Opus 5.5, không đặt effort nghĩa là medium, có thể làm đổi độ sâu câu trả lời và độ trễ mà không cần sửa dòng code nào.
Vì sao Opus 5.5 từ chối nhiều hơn, và xử lý refusal thế nào?
Opus 5.5 chạy thêm một classifier an toàn sinh học bên cạnh classifier an ninh mạng, nên nó từ chối ở nhiều nhóm hơn Opus 5. Request bị từ chối vẫn trả HTTP 200 với stop_reason: "refusal" và stop_details.category; hãy xử lý trong code và thử lại trên model fallback, thay vì sửa câu chữ prompt cho tới khi lọt qua.
Các nhóm trong hướng dẫn refusal và fallback của Anthropic gồm "cyber", "bio", "frontier_llm" (giúp phát triển model AI cạnh tranh), "reasoning_extraction" (yêu cầu model in lại suy luận nội bộ) và "general_harms", hoặc null. Anthropic cho biết công việc lành mạnh vẫn có thể kích hoạt các classifier cyber, bio, frontier_llm và general_harms. Anthropic không công bố tỷ lệ từ chối nhầm so sánh Opus 5.5 với Opus 5, nên hãy đo trên bộ golden test của bạn.
Xử lý refusal trên production
- Rẽ nhánh theo
stop_reason. Refusal có thể đến trước khi có đầu ra hoặc giữa stream. Cả hai trường hợp đều bỏ phần đầu ra dở dang. - Cấu hình fallback. Đặt
fallbacks: "default"với beta headerserver-side-fallback-2026-07-01, API sẽ thử lại trên model mà Anthropic khuyến nghị cho nhóm đó, trong cùng một lần gọi. Hoặc chỉ định tối đa ba model fallback, dùng SDK middleware, hoặc tự viết logic retry. Fallback phía server không có trên Batches API, và Haiku 5.5 không có fallback phía server. - Sửa
reasoning_extractiontừ prompt. Prompt kiểu "in toàn bộ chuỗi suy nghĩ vào câu trả lời" sẽ bị từ chối. Hãy xin một lời giải thích ngắn hoặc bằng chứng, và đặtthinking.display: "summarized"nếu cần xem suy luận. - Dùng chương trình xác minh cho việc lưỡng dụng hợp pháp. Đội bảo mật có thể đăng ký Cyber Verification Program, tổ chức khoa học sự sống có thể đăng ký Life Sciences Verification Program; bài ra mắt của Anthropic cho biết các chương trình này nay áp dụng cho Opus 5.5.
- Dự trù chi phí cho refusal bị tính tiền. Refusal trước khi có đầu ra bị tính phí ở các nhóm
bio,frontier_llmvàreasoning_extraction, và mọi refusal đều tính vào rate limit. - Theo dõi refusal như một chỉ số. Ghi log nhóm, loại prompt và model fallback, và thêm bài kiểm tra từ chối nhầm vào bộ regression test.
Có nên tìm cách lách refusal của Opus 5.5 không?
Không. Refusal của classifier là quyết định chính sách, không phải lỗi, và mẹo prompt để lọt qua là cách sửa sai. Anthropic tính phí một số refusal chính là "để ngăn các nỗ lực lách safeguard ở quy mô lớn", mẹo chạy được hôm nay có thể hỏng ở lần cập nhật classifier tiếp theo, và ứng dụng dựa trên mẹo đó sẽ hỏng khó đoán với người dùng của bạn.
Khi một yêu cầu hợp pháp bị từ chối, các cách sửa bền vững là những cách ở trên: viết system prompt nêu rõ use case và bối cảnh thật, chuyển refusal sang model fallback, đưa việc lưỡng dụng vào chương trình xác minh, và giữ một bộ eval gồm các edge case hợp pháp để biết khi nào bản cập nhật model làm đổi tỷ lệ từ chối. Nếu đã viết lại mà yêu cầu hợp pháp vẫn bị từ chối, hướng dẫn của Anthropic khuyên liên hệ support kèm request ID.
Các model mới so sánh thế nào về chi phí và độ trễ?
Giá niêm yết mỗi triệu token (đầu vào / đầu ra) lấy từ trang model và bảng giá của các nhà cung cấp ngày 13/11/2026. Các cột tính trên 1.000 lượt dùng cùng giả định với bài chi phí: 6.000 token đầu vào và 500 token đầu ra cho một câu trả lời RAG, 60.000 token đầu vào và 3.000 token đầu ra cho một tác vụ agent. Không tính cache, và chưa tính token suy luận.
| Chuyển đổi | Giá trước → sau | Mỗi 1.000 câu trả lời RAG | Mỗi 1.000 tác vụ agent | Cần lưu ý |
|---|---|---|---|---|
| GPT-5.5 → GPT-5.6 Sol | $5 / $30 → $4 / $20 | $45,00 → $34,00 | $390 → $300 | Giá niêm yết; OpenAI ghi giá khuyến mãi tới 30/11/2026 |
| GPT-5.5 → GPT-6.1 Sol | $5 / $30 → $2 / $10 | $45,00 → $17,00 | $390 → $150 | Bắt buộc Responses API để gọi tool; không có effort none |
| GPT-5.1 → GPT-6 Sol | $1,25 / $10 → $2 / $10 | $12,50 → $17,00 | $105 → $150 | Đầu vào đắt hơn 60%. Đầu vào cache là $0,20 (Sol) hoặc $0,10 (6.1 Sol) |
| GPT-5.3-Codex → GPT-6 Sol | $1,75 / $14 → $2 / $10 | $17,50 → $17,00 | $147 → $150 | Gần như không đổi. Việc sinh nhiều đầu ra sẽ rẻ hơn |
| GPT-5.4-Nano → GPT-6 Luna | $0,20 / $1,25 → $0,10 / $0,50 | $1,83 → $0,85 | $15,75 → $7,50 | Rẻ khoảng một nửa. Kiểm tra chất lượng trên các case khó nhất |
| Claude Sonnet 4.5 → Sonnet 5.5 | $3 / $15 → $2 / $10 | $25,50 → ~$22,10 | $225 → ~$195 | Tokenizer mới dùng khoảng 1 đến 1,35 lần số token cho cùng đoạn văn (chúng tôi giả định 1,3 lần), nên tiết kiệm khoảng 13%, không phải 33% |
| Claude Opus 5 → Opus 5.5 | $5 / $25 → $4 / $20 | $42,50 → $34,00 | $375 → $300 | Anthropic cho biết Opus 5.5 rẻ hơn Opus 5 khoảng 40% trên tác vụ điển hình với thiết lập mặc định, một phần nhờ effort mặc định thấp hơn |
Có ba cái bẫy chi phí nằm ngoài giá niêm yết. Thứ nhất, Anthropic tính token thinking như token đầu ra, và trên Opus 5.5 mọi request đều có thinking vì không tắt được. Ở phía OpenAI cũng nên kiểm tra lượng token suy luận. Một tác vụ trước đây chạy không có thinking có thể sinh nhiều token đầu ra hơn dù giá thấp hơn. Thứ hai, GPT-5.5, GPT-5.6 Sol, GPT-6 Sol và GPT-6.1 Sol tính gấp 2 lần đầu vào và 1,5 lần đầu ra cho cả request khi đầu vào vượt 272K token, trong khi Claude 4.6 trở lên (trừ Haiku 5.5) tính giá chuẩn trên toàn bộ cửa sổ 1 triệu token. Thứ ba, xử lý batch rẻ một nửa ở cả hai nhà cung cấp, nên hãy chuyển eval và các việc back-office sang đó.
Không nhà cung cấp nào cam kết độ trễ cho các model này. Anthropic cho biết Opus 5.5 sinh đầu ra nhanh hơn Opus 5 trên 30%, và fast mode (tốc độ đầu ra tới 2,5 lần) có giá $8 / $40. GPT-6.1 Sol của OpenAI không có mức effort none, nên thời gian phản hồi có một mức sàn. Hãy đo độ trễ p50 và p95 trên chính prompt của bạn ở mức effort định dùng. Đừng tin biểu đồ ra mắt.
Vì sao nâng cấp model lại gây thụt lùi?
Model mới tốt hơn ở mức trung bình nhưng kém hơn ở một số case của bạn. Các nguyên nhân thường gặp:
- Prompt được tinh chỉnh cho model cũ. Các mẹo khắc phục điểm yếu cũ, như "luôn trả lời bằng JSON" hay "hãy suy nghĩ từng bước", có thể làm rối một model vốn đã làm những việc đó. Trên Opus 5.5, yêu cầu đưa suy luận vào câu trả lời còn có thể gây refusal nhóm
reasoning_extraction. - Giá trị mặc định thay đổi. Effort, độ dài và hành vi từ chối thay đổi giữa các phiên bản. Một request không đặt gì giờ cũng hành xử khác.
- Định dạng đầu ra lệch. Thay đổi nhỏ về markdown, thứ tự trường hay kiểu trích dẫn làm hỏng parser và giao diện.
- Hành vi dùng tool. Các model khác nhau ở mức độ sẵn sàng gọi tool, số lần gọi và cách xử lý lỗi tool. Agent chịu ảnh hưởng nhiều nhất.
- Số token. Tokenizer mới làm đổi khoảng trống trong context window, điểm cắt và chi phí.
- Ngân sách độ trễ. Suy nghĩ nhiều hơn có thể đẩy độ trễ p95 vượt timeout vốn chưa từng bị chạm.
Không có bộ eval, bạn sẽ phát hiện những điều này qua phàn nàn của khách hàng. Tránh điều đó chính là mục đích của phần tiếp theo.
Kế hoạch chuyển đổi dựa trên eval trông như thế nào?
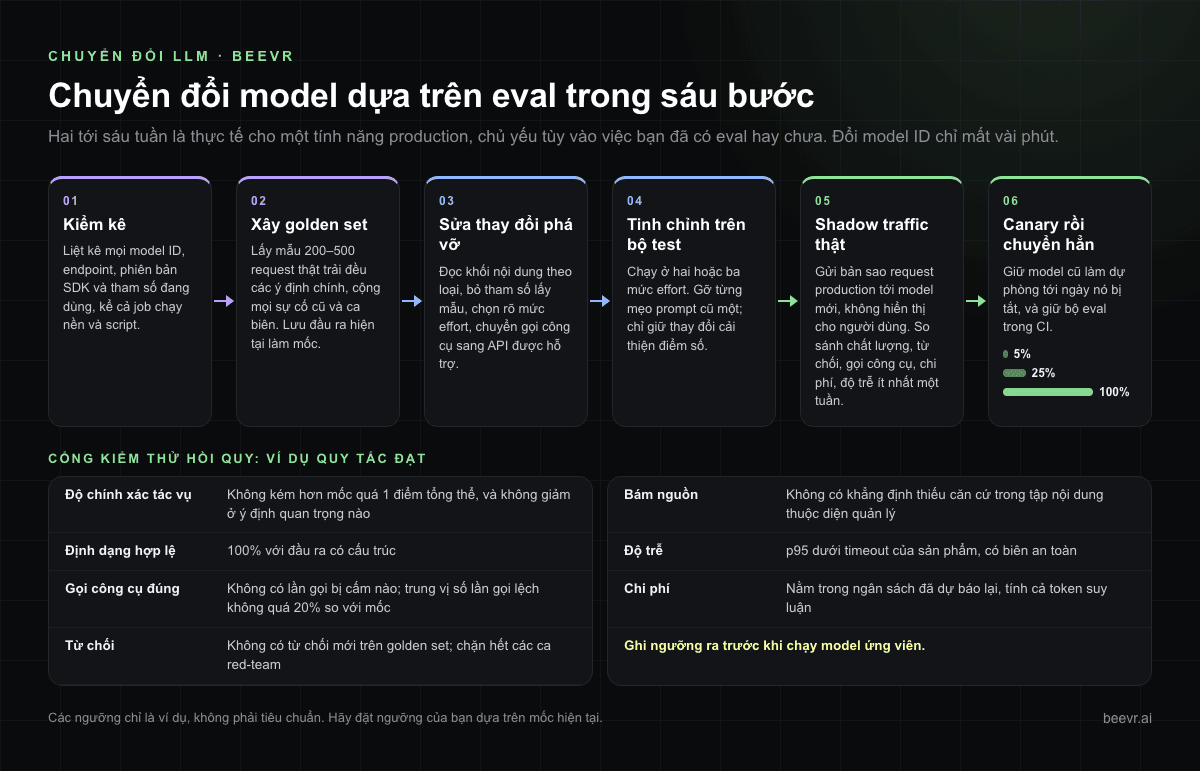
Sáu bước, theo đúng thứ tự. Hai đến sáu tuần là thực tế cho một tính năng production, chủ yếu tùy vào việc bạn đã có eval hay chưa.
- Kiểm kê. Liệt kê mọi model ID, endpoint, phiên bản SDK, header API version và tham số đang dùng. Tính cả job chạy nền và script. Console của Anthropic cho export usage theo API key và model, còn dashboard usage của OpenAI cho thấy bạn đang gọi những model nào.
- Xây golden set. Lấy mẫu 200–500 request thật trải đều các ý định chính, cộng mọi sự cố cũ và edge case đã biết. Ghi lại đầu ra của model hiện tại làm mốc và gắn nhãn thế nào là "đúng" cho từng case.
- Sửa các thay đổi phá vỡ. Đi lần lượt qua các bảng ở trên. Đọc content block theo type, bỏ tham số sampling, chọn effort rõ ràng, xử lý refusal và chuyển việc gọi tool sang API được hỗ trợ.
- Tinh chỉnh trên golden set. Chạy golden set trên model ứng viên ở hai hoặc ba mức effort. Bỏ từng mẹo prompt cũ một và chỉ giữ thay đổi làm tăng điểm.
- Chạy shadow trên traffic thật. Gửi bản sao request production sang model mới mà không hiển thị kết quả cho người dùng. So sánh điểm chất lượng, số lần từ chối, lần gọi tool, chi phí và độ trễ trong ít nhất một tuần.
- Canary rồi chuyển hẳn. Chuyển 5%, rồi 25%, rồi 100% traffic. Giữ model cũ làm dự phòng tới ngày tắt, và giữ bộ eval trong CI cho lần chuyển đổi sau.
Regression test cần bao phủ những gì?
Mỗi rủi ro một dòng, và đặt ngưỡng trước khi xem kết quả. Các ngưỡng dưới đây chỉ là ví dụ. Hãy đặt ngưỡng của bạn từ mốc ban đầu.
| Bài test | Đo gì | Ví dụ quy tắc đạt |
|---|---|---|
| Độ chính xác tác vụ | Câu trả lời hoặc hành động đúng trên golden set, chấm bằng luật, nhãn của người hoặc LLM grader đã hiệu chỉnh | Không kém hơn mốc quá 1 điểm tổng thể, và không giảm ở ý định quan trọng nào |
| Định dạng hợp lệ | JSON hoặc schema parse được, đủ trường bắt buộc | 100% trên structured outputs |
| Gọi tool đúng | Đúng tool, tham số hợp lệ, không gọi tool bị cấm, số lần gọi mỗi tác vụ | Không có lần gọi bị cấm; trung vị số lần gọi trong khoảng 20% so với mốc |
| Từ chối | Từ chối nhầm với yêu cầu hợp lệ (theo stop_details.category), bỏ lọt với prompt red-team | Không có từ chối mới trên golden set; chặn hết case red-team |
| Bám nguồn | Câu trả lời được nguồn truy xuất hỗ trợ, trích dẫn mở được | Không có khẳng định thiếu căn cứ trong tập nội dung thuộc diện quản lý |
| Độ trễ | p50 và p95 từ đầu tới cuối, tính cả tool | p95 dưới timeout của sản phẩm, còn khoảng dư |
| Chi phí | Token và tiền mỗi tác vụ, tính cả token suy luận | Nằm trong ngân sách đã dự báo lại |
Nếu ngành của bạn chịu quản lý, hãy lưu kết quả chạy, phiên bản model và ngưỡng làm bằng chứng. Đổi model đúng là loại sự kiện auditor sẽ hỏi. Kế hoạch eval cho ngành tuân thủ của chúng tôi ánh xạ các bài test này với HIPAA, PCI DSS và EU AI Act, còn bài đánh giá và quan sát AI agent trình bày phần công cụ.
Triển khai model mới an toàn trên production thế nào?
Đổi model qua cấu hình, định tuyến theo tác vụ, kiểm thử đường fallback, và theo dõi chỉ số online hai tuần sau khi chuyển. Năm thực hành sau giúp làm được điều đó:
- Đặt model sau một công tắc cấu hình, không phải thay đổi code, để rollback chỉ mất vài giây.
- Định tuyến theo tác vụ, không theo nhà cung cấp. Tác vụ dễ có thể chuyển sang model rẻ hơn như GPT-6 Luna hoặc Claude Haiku 5.5. Giữ model đắt cho những bước mà eval cho thấy thật sự cần.
- Cấu hình fallback có chủ đích. Nếu refusal hoặc sự cố chuyển cuộc hội thoại sang model khác, hãy kiểm thử đường đó. Hướng dẫn của Anthropic lưu ý model fallback thường chạy mà không có thinking block của Opus 5.5; API sẽ bỏ các block mà model đích không đọc được.
- Theo dõi chỉ số online trong hai tuần sau khi chuyển: người dùng sửa lại, thumbs-down, số lần từ chối, chuyển lên người, lỗi tool, chi phí mỗi tác vụ và độ trễ p95.
- A/B test thay đổi prompt bằng thống kê, không bằng cảm giác. Chênh hai điểm trên 50 mẫu thường chỉ là nhiễu.
Checklist chuyển đổi model gồm những gì?
Mười lăm mục kiểm tra, từ kiểm kê và golden set tới xử lý refusal, rollback và dự báo lại chi phí. Hãy tích đủ trước khi chuyển 100% traffic:
- Đã liệt kê mọi model ID, phiên bản SDK, API version và tham số đang dùng, kể cả batch job.
- Mỗi model có ngày tắt và người phụ trách trong tracker.
- Eval đã được export khỏi mọi nền tảng sắp tắt, như OpenAI Evals trước 30/11/2026.
- Có golden set 200–500 case thật, gồm edge case và sự cố cũ, đã ghi mốc.
- Đã bỏ tham số sampling, prefill, ép tool và tắt thinking ở những nơi bị từ chối.
- Phần parse response đọc block theo type, và thinking block được gửi lại nguyên vẹn.
- Đã đặt
thinking.displaynếu giao diện hiển thị tiến độ giữa các lần gọi tool. - Effort hoặc mức suy luận được đặt rõ ràng, chọn từ một lần effort sweep.
max_tokensđược tính lại cho cả thinking lẫn câu trả lời.- Đã xử lý
stop_reason: "refusal", có đường fallback đã kiểm thử. - Ngưỡng đạt được ghi lại trước khi chạy model ứng viên.
- Shadow traffic đã chạy ít nhất một tuần, có so sánh chất lượng, chi phí và độ trễ.
- Đã kiểm thử các bước canary và rollback bằng một công tắc.
- Đã dự báo lại chi phí token, tính cả thay đổi tokenizer, bậc giá context dài và thay đổi giá năm 2027.
- Bộ eval được giữ trong CI cho lần chuyển đổi sau.
Câu hỏi thường gặp
Khi nào GPT-5.1 ngừng chạy trên API?
Ngày 01/04/2027. Ngày 01/10/2026, OpenAI thông báo gpt-5.1, gpt-5.3-codex và gpt-5.4-nano sẽ bị tắt vào ngày đó, với gpt-6-sol thay cho hai model đầu và gpt-6-luna thay cho Nano. Request tới model đã tắt sẽ lỗi.
GPT-5.5 có sắp bị khai tử trên API không?
Chưa, tính đến 13/11/2026. Trang deprecation của OpenAI không ghi ngày tắt cho gpt-5.5, model có giá $5 đầu vào và $30 đầu ra mỗi triệu token. Chỉ gpt-5.5-cyber-preview có lịch tắt, vào 01/02/2027. Việc model nào xuất hiện trong ChatGPT là chuyện riêng, không liên quan tới khai tử trên API.
Là GPT-6 Sol hay GPT-5.6 Sol?
Cả hai đều có. gpt-5.6-sol là flagship của dòng GPT-5.6 và là model OpenAI chỉ định thay cho GPT-5 và o3 bản gốc. gpt-6-sol là bậc chi phí thấp của GPT-6, nằm dưới GPT-6 Astra, và thay cho GPT-5.1 cùng GPT-5.3-Codex. gpt-6.1-sol là phiên bản mới hơn của nó.
Nên chuyển sang GPT-6.1 Sol hay Claude Opus 5.5?
Chạy cả hai trên golden set và quyết định dựa trên bằng chứng. GPT-6.1 Sol giá $2 / $10 với context 1,05 triệu token. Opus 5.5 giá $4 / $20 với context 1 triệu token và thinking luôn bật. GPT-6 Astra ($10 / $50) là đối tượng so sánh cho việc khó nhất. Giá mỗi token ít quan trọng hơn chi phí mỗi tác vụ thành công, và con số đó phụ thuộc vào prompt, tool và mức effort của bạn.
Có thể bỏ qua eval nếu model mới "tốt hơn" không?
Không. Benchmark lấy trung bình trên những tác vụ không phải của bạn, và chính Anthropic cũng nhận xét chênh lệch benchmark đã trở thành thước đo kém tin cậy hơn cho khác biệt ngoài thực tế. Một golden set 200 case mất vài ngày để xây và là cách duy nhất biết ứng dụng của bạn tốt lên hay kém đi.
Chuyển đổi LLM mất bao lâu?
Đổi model ID mất vài phút. Chuyển đổi an toàn một tính năng production thường mất hai đến sáu tuần. Phần lớn thời gian dành cho xây bộ eval, tinh chỉnh prompt và effort, và chạy shadow traffic đủ lâu để tin được các con số.
BeevR giúp chuyển đổi model thế nào?
Chuyển đổi model là một phần việc có phạm vi rõ: kiểm kê, eval, sửa code và triển khai. Vì vậy nó phù hợp với giá cố định. Dịch vụ phát triển AI agent của chúng tôi tính giá theo giai đoạn, từ $10K mỗi giai đoạn, có bản demo chạy được mỗi thứ Sáu và bạn sở hữu toàn bộ code từ ngày đầu; trang giá giải thích cách xác định phạm vi từng giai đoạn. Framework agent mã nguồn mở của chúng tôi, Kite, có sẵn A/B test prompt với khoảng tin cậy thống kê trên traffic thật. Nó tồn tại vì "prompt mới có vẻ tốt hơn" không phải tiêu chí phát hành. Nếu bạn chưa chắc agent nên được xây lại hay chỉ cần chuyển đổi, bài hướng dẫn chọn framework và bài chi phí AI agent là điểm khởi đầu tốt.
BeevR là studio AI do founder dẫn dắt với đội ngũ senior tại Hà Nội. Nếu bạn sắp chạm hạn chót của một model, hãy đặt lịch gọi 30 phút và cho chúng tôi biết bạn đang chạy những model nào. Chúng tôi sẽ vạch ra các thay đổi phá vỡ và phần việc eval trước khi bạn cam kết bất cứ điều gì.