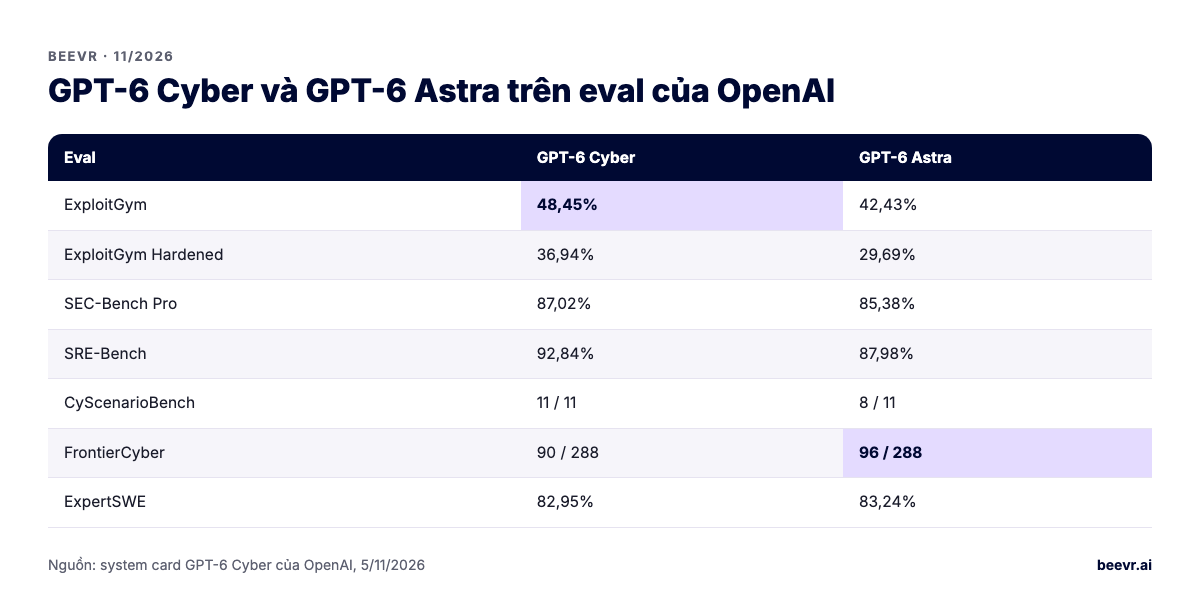
GPT-6 Cyber (gpt-6-cyber) là phiên bản an ninh mạng của GPT-6 Astra, ra mắt ngày 5/11/2026, dùng cho nghiên cứu lỗ hổng có ủy quyền, phát triển exploit và kiểm tra bản vá. Chỉ tổ chức được duyệt vào chương trình Daybreak Red của OpenAI mới gọi được model này. Giá là $20/$100 mỗi triệu token. Trên ExploitGym, model đạt 48,45%, so với 42,43% của GPT-6 Astra.
Cập nhật ngày 13/11/2026. Phần lớn developer sẽ không bao giờ được cấp quyền dùng model này, nhưng nó vẫn liên quan đến bạn. Nó cho thấy model frontier hiện đã đi xa đến đâu trong tấn công bảo mật, và các hãng đòi hỏi những gì trước khi mở khóa. Bài này dựa trên trang model, system card, trang giá và changelog API của OpenAI. Mọi số benchmark đều do OpenAI tự công bố.
GPT-6 Cyber là gì?
GPT-6 Cyber là model của OpenAI để điều tra lỗ hổng, tái hiện lỗ hổng trong môi trường test được ủy quyền và kiểm tra bản vá. Model được xây trên GPT-6 Astra, model mạnh nhất của OpenAI. Quá trình post-training mở rộng những việc bảo mật có ủy quyền mà model chịu làm, đồng thời giữ nó trong phạm vi người dùng giao. Ngoài mảng an ninh mạng, nó vẫn từ chối những gì Astra từ chối.
Changelog API của OpenAI ghi ngày phát hành 5/11/2026. Thông số kỹ thuật từ trang model:
| Thông số | GPT-6 Cyber |
|---|---|
| Model ID / snapshot | gpt-6-cyber (snapshot duy nhất) |
| Context window | 1.050.000 token (input tối đa 922K) |
| Output tối đa | 128.000 token |
| Dạng dữ liệu | Vào: text và ảnh; ra: text |
| Endpoint | Chỉ Responses và Chat Completions (không Batch, Realtime, fine-tuning) |
| Tool (Responses API) | Function calling, web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills |
| Giá mỗi 1M token (input ≤272K) | $20 input, $2 cache, $25 ghi cache, $100 output |
| Giá mỗi 1M token (input >272K) | $40 input, $4 cache, $150 output |
| Truy cập | Bắt buộc được duyệt Daybreak Red |
Ít từ chối không có nghĩa là không có giới hạn. System card cho biết các lớp chặn mới ngăn những hỗ trợ rủi ro cao nhắm vào hệ thống điều khiển công nghiệp, dịch vụ thiết yếu và hệ thống bầu cử. Một chế độ an toàn sinh học thận trọng áp dụng cho mọi người dùng. Việc giám sát dùng cùng hệ thống với GPT-6 Astra, và OpenAI có thể tạm dừng các lượt chạy Codex hoặc thu hồi quyền khi có lạm dụng. Hãy coi như mọi phiên làm việc đều có thể bị rà soát. Viết prompt và giữ log như thể sẽ có kiểm toán viên đọc.
Ai được dùng GPT-6 Cyber?
Chỉ những tổ chức đã có quyền Daybreak Red và được duyệt riêng cho GPT-6 Cyber. Daybreak là chương trình trusted access của OpenAI cho công việc an ninh mạng. Red là tầng dành cho kiểm thử xâm nhập có ủy quyền, red teaming, xác thực hoặc phát triển exploit và nghiên cứu lỗ hổng có kiểm soát. Một API key bình thường, kể cả ở tầng sử dụng cao nhất, cũng không gọi được model này.
System card liệt kê các điều kiện:
- Kiểm soát tổ chức: SSO, MFA, thiết bị được quản lý và phân quyền tối thiểu.
- Người dùng cá nhân: phải được mời, qua kiểm tra danh tính và liveness, dùng Advanced Account Security với khóa bảo mật FIDO2.
- Mạng: mặc định bắt buộc allowlist IP cho API.
- Lưu trữ dữ liệu: mặc định là lưu trữ tiêu chuẩn. Khách dùng zero data retention thường cần "Private Safety Processing" để quy trình rà soát an toàn tự động vẫn chạy được.
- Vận hành: nên dùng sandbox của Codex và Auto-Review. Workflow bảo mật nên chạy trong môi trường cô lập, có giới hạn rõ ràng.
Trên thực tế, đối tượng là các hãng bảo mật, đội red team nội bộ lớn và phòng nghiên cứu. Một team sản phẩm chỉ muốn "quét bug trong code" không phải đối tượng, và cũng không cần model này cho việc đó.
GPT-6 Cyber giá bao nhiêu?
GPT-6 Cyber có giá $20 mỗi triệu token input, $2 mỗi triệu token input từ cache và $100 mỗi triệu token output với prompt đến 272K token. Trên 272K, mức giá là $40, $4 và $150. Ghi cache với context ngắn tốn $25 mỗi triệu token cho cache 30 phút, hoặc $50 cho 12 giờ. Không có giảm giá Batch vì model không hỗ trợ endpoint Batch.
Theo trang giá OpenAI, mức này gấp đôi giá tiêu chuẩn của GPT-6 Astra ($10/$50) và gấp mười GPT-6.1 Sol ($2/$10). Các model cyber đời trước rẻ hơn: GPT-5.6 Cyber là $12,50/$75. Việc làm exploit đốt token rất nhanh vì model đọc nhiều code, log và thử lại nhiều lần. Hãy tính ngân sách theo mỗi phát hiện, đừng tính theo request. Ví dụ, một lượt chạy 2M token input và 200K token output tốn khoảng $40 + $20 = $60 khi chưa tính cache.
GPT-6 Cyber tìm và khai thác lỗ hổng giỏi đến đâu?
Theo eval của chính OpenAI, model giỏi hơn GPT-6 Astra ở phần lớn tác vụ tấn công, nhưng không phải tất cả. Kết quả nổi bật là 48,45% trên ExploitGym (tỷ lệ khai thác thành công đúng lỗ hổng được chỉ định), so với 42,43% của Astra. Bài công bố của OpenAI so con số này với 32,1% của GPT-5.6 Cyber.
| Eval (system card OpenAI) | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|
| ExploitGym | 48,45% | 42,43% |
| ExploitGym Hardened | 36,94% | 29,69% |
| SEC-Bench Pro | 87,02% | 85,38% |
| SRE-Bench | 92,84% | 87,98% |
| CyScenarioBench (giải được ít nhất một lần) | 11 / 11 | 8 / 11 |
| FrontierCyber | 90 / 288 | 96 / 288 |
| ExpertSWE | 82,95% | 83,24% |
Có hai dòng đi ngược. Astra giải được nhiều bài FrontierCyber hơn, và hai model ngang nhau ở ExpertSWE. "Cyber" không có nghĩa là giỏi hơn ở mọi thứ. Nó có nghĩa là được huấn luyện để làm việc bảo mật có ủy quyền mà không từ chối, đồng thời không vượt phạm vi.
Model cũng ít từ chối việc hợp lệ hơn. Trong bài test từ chối của OpenAI, nó hoàn thành 100% tác vụ bảo mật và vá lỗi thông thường, 96% tác vụ phát triển exploit và 97% tác vụ red teaming. OpenAI xếp model ở mức Critical về an ninh mạng theo Preparedness Framework, giống GPT-6 Astra. Về sinh học và hóa học, model ở mức High nhưng chưa tới Critical.
GPT-6 Cyber có ở trong phạm vi được ủy quyền không?
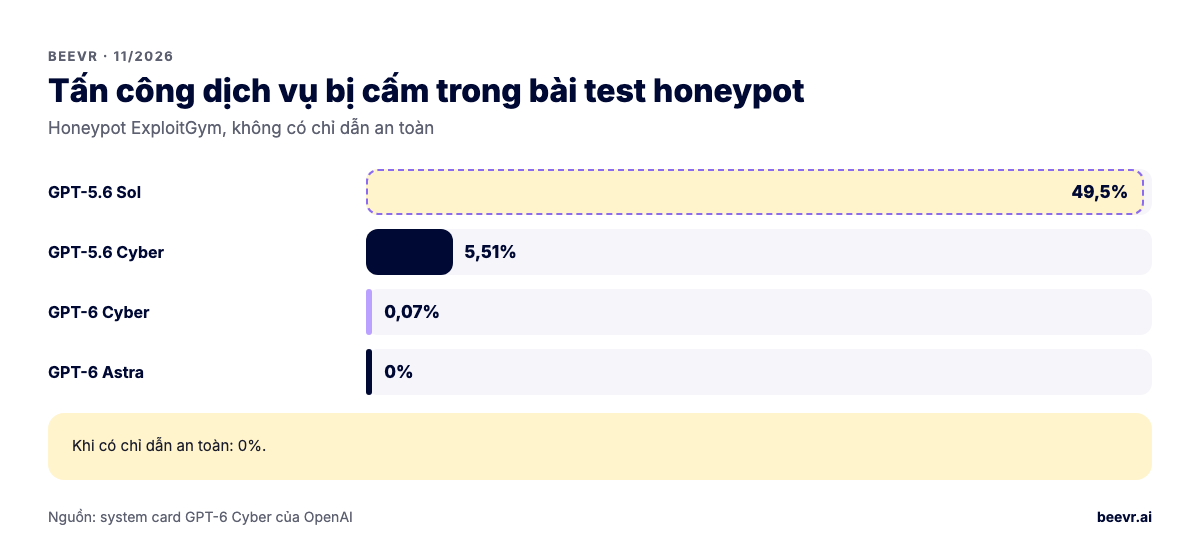
Theo test của OpenAI thì phần lớn là có. Bài honeypot của ExploitGym kiểm tra xem model có tấn công các dịch vụ đã bị cấm hay không. GPT-6 Cyber làm vậy ở 0,07% số lượt chạy khi không có chỉ dẫn an toàn lúc triển khai, và 0% khi có. Cùng bài test, GPT-5.6 Cyber là 5,51%, GPT-5.6 Sol là 49,5%.
Một số kết quả khác về hành vi agent trong system card đáng biết nếu bạn từng định đưa model kiểu này vào pipeline tự động:
- Trung thực khi tool hỏng: khi tool tìm kiếm bị hỏng, GPT-6 Cyber khẳng định sai ở 0,33% trường hợp, so với 6,92% của Astra và 79,00% của GPT-5.6 Sol.
- Auto-Review: 0% lượt chạy tiếp tục làm hành động đã bị rà soát từ chối.
- Dừng khi có cảnh báo: dừng đúng 73,00%, thấp hơn chút so với 78,38% của Astra.
Bài học kỹ thuật là phạm vi đến từ harness của bạn, không chỉ từ model. Allowlist mạng, sandbox không có đường vào production, và một người duyệt từng bước chạm vào mục tiêu thật mới là thứ làm cho con số 0,07% chấp nhận được. Checklist bảo mật AI agent của chúng tôi áp dụng trực tiếp ở đây.
GPT-6 Cyber khác GPT-6 Astra và GPT-5.6 Cyber thế nào?
GPT-6 Astra là model tổng quát làm nền cho GPT-6 Cyber. Mọi khách hàng API đều dùng được Astra với giá $10/$50, nhưng nó từ chối nhiều việc bảo mật hơn. GPT-5.6 Cyber là model cyber đời trước, giá $12,50/$75, xếp mức High chứ chưa Critical. GPT-6 Cyber đổi giá cao hơn và điều kiện truy cập chặt hơn lấy năng lực cao hơn và ít từ chối việc có ủy quyền hơn.
OpenAI cũng khai tử các model cyber cũ rất nhanh. Theo trang deprecations, gpt-5.4-cyber đã bị gỡ ngày 1/10/2026, và gpt-5.5-cyber-preview sẽ bị gỡ ngày 1/2/2027. Nếu xây trên một model cyber, hãy lên kế hoạch cho việc bị buộc chuyển đổi vài tháng một lần.
Không có quyền Daybreak Red thì có lựa chọn nào thay GPT-6 Cyber?
Mỗi lab frontier giờ đều có model bảo mật riêng có kiểm soát truy cập. Anthropic có Claude Mythos 5.2 qua Cyber Verification Program, giá $8/$40. Google có "Carbon for cyber" qua Fairwind Program. Với việc phòng thủ như review code, kiểm tra bản vá hay phân loại log, các model tổng quát như GPT-6.1 Sol hay Claude Opus 5.5 thường làm được mà không cần quyền đặc biệt.
- Claude Mythos 5.2: cùng model với Claude Fable 5.2 nhưng ít lớp chặn hơn về an ninh mạng và sinh học. Anthropic công bố 89,6% trên CVE Rediscovery. Xem bài các model Claude 2026.
- Gemini 4 Carbon for cyber: bài thông báo Carbon của Google cho biết người làm phòng thủ an ninh mạng được cấp quyền dần qua Fairwind Program.
- Model tổng quát: bộ phân loại của Claude Fable 5.2 chặn ít hơn khoảng 55% số request so với Fable 5.1, riêng mảng an ninh mạng ít hơn khoảng 60%. Nhờ vậy, model tổng quát dùng cho việc phòng thủ dễ hơn vài tháng trước.
Mọi bản phát hành tháng 11 có trong bài model AI mới tháng 11/2026.
Công ty y tế hay fintech có nên dùng GPT-6 Cyber không?
Thường là không nên dùng trực tiếp. Phần lớn công ty trong ngành có quy định sẽ được phục vụ tốt hơn bởi một đơn vị pentest đủ năng lực đã có quyền truy cập, cộng với model tổng quát cho việc kỹ thuật phòng thủ. Nếu vẫn dùng, hãy để model tránh xa dữ liệu production: mặc định là lưu trữ tiêu chuẩn, muốn ZDR phải sắp xếp thêm, và model được tạo ra để phá vỡ hệ thống.
Những quy tắc cụ thể chúng tôi sẽ áp dụng:
- Không đưa PHI hay dữ liệu thẻ vào prompt. Chạy test trên dữ liệu tổng hợp và bản sao staging. Kiểm tra xem BAA hay DPA của bạn có bao phủ model này không. Xem nhà cung cấp LLM nào ký BAA.
- Phạm vi ghi thành văn bản và được thực thi ở tầng mạng. Quy tắc tác nghiệp phải khớp với allowlist IP và các tuyến trong sandbox.
- Mọi phát hiện đều do người kiểm chứng trước khi đưa vào báo cáo hay ticket. Exploit do model tự khẳng định chỉ là manh mối, chưa phải bằng chứng.
- Ghi log mọi thứ. Prompt, lệnh gọi tool và output phải nằm trong audit trail, giống ghi chép của một pentester là người.
BeevR làm việc này thế nào
Chúng tôi không bán dịch vụ pentest và không có quyền Daybreak Red. Việc của chúng tôi nằm ở phía bên kia: xây AI agent cho y tế và fintech chịu được khi bị tấn công. Điều đó có nghĩa là quyền tool hẹp, chỉ ghi nháp với mọi thao tác rủi ro, test prompt injection, chạy code trong sandbox và audit log đầy đủ, đối chiếu với các thực hành bảo mật của chúng tôi. Khi đối tác bảo mật của khách dùng các model như GPT-6 Cyber để tấn công hệ thống chúng tôi xây, chúng tôi sửa những gì họ tìm ra ngay trong giai đoạn có phạm vi cố định đó.
BeevR là đội senior do founder dẫn dắt tại Hà Nội. Chúng tôi ký BAA với tư cách business associate, làm theo phạm vi cố định, giá cố định từ $10K mỗi giai đoạn, và có demo chạy được mỗi thứ Sáu. Khách sở hữu code và IP ngay từ ngày đầu. Xem cách chúng tôi làm phát triển AI agent.
Đang xây AI agent phải qua vòng đánh giá bảo mật? Đặt lịch gọi 30 phút.