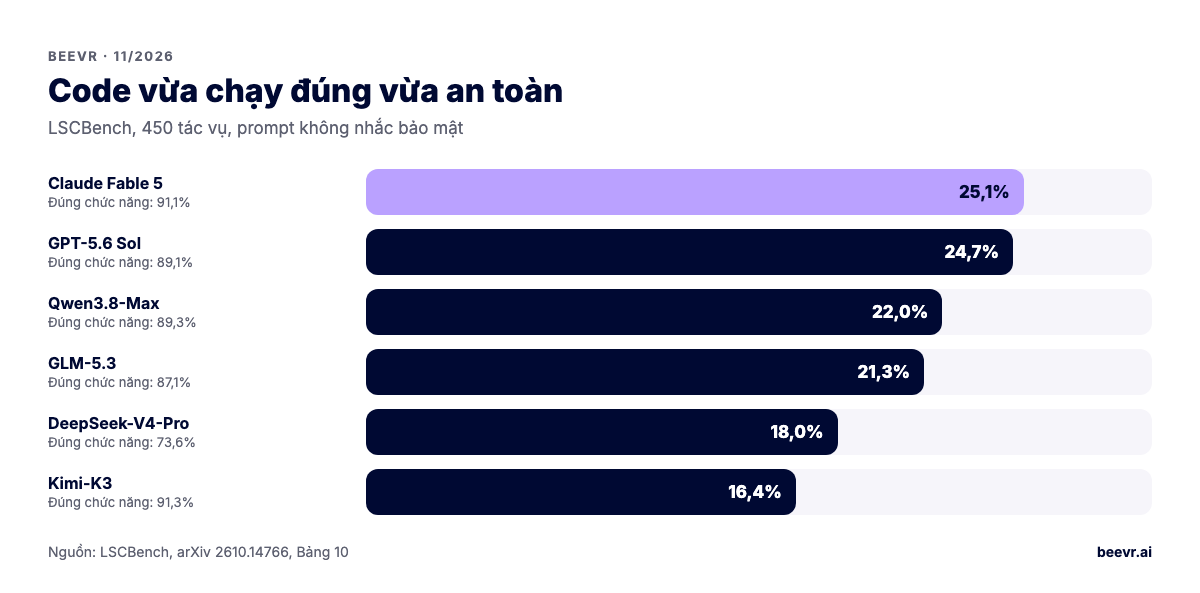
Phần lớn là không, nếu bạn không kiểm tra. Trong một benchmark tháng 10/2026 với sáu model frontier, 73,6–91,3% tác vụ cho ra code chạy được, nhưng chỉ 16,4–25,1% vừa chạy được vừa an toàn. Hãy đối xử với code của agent như code của một junior viết nhanh: quét, test, sandbox, và có người review mọi lần merge.
Cập nhật ngày 13/11/2026. Tháng 10/2026 có nhiều nghiên cứu gốc về bảo mật của coding agent. Chúng cùng chỉ về một hướng: agent giao tính năng rất đều, còn bảo mật thì không, và chính bộ công cụ agent giờ đã thành bề mặt tấn công. Bài này tóm tắt những gì các bài báo thực sự đo, dựa trên abstract và toàn văn trên arXiv, rồi chuyển thành các biện pháp kiểm soát bạn có thể đưa vào pipeline ngay quý này. Muốn biết nên đánh giá công cụ nào, hãy xem bài so sánh Cursor, Claude Code, Codex và Devin.
AI coding agent năm 2026 có viết code an toàn không?
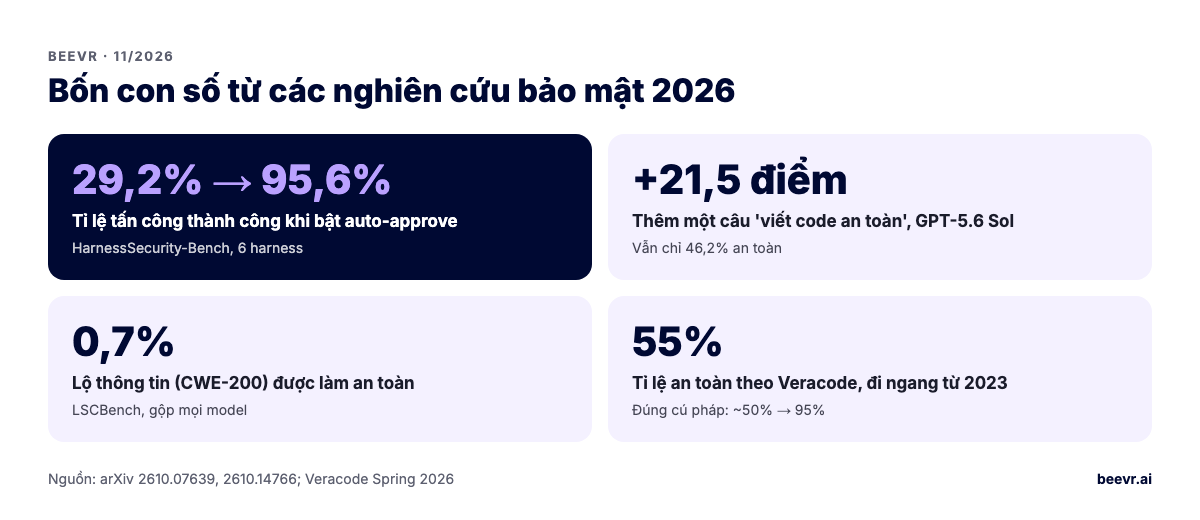
Mặc định thì không. Agent giờ viết code qua được test chức năng trong phần lớn trường hợp, nhưng bảo mật không tiến bộ cùng tốc độ. Hai nguồn độc lập cùng kết luận như vậy. Một benchmark học thuật mới cho model tốt nhất đạt 25,1% "vừa đúng vừa an toàn". Phép thử dài hạn của Veracode cho tỉ lệ an toàn trung bình khoảng 55%, gần như đi ngang từ 2023.
Hai con số khác nhau vì chúng đo hai thứ khác nhau. Bản cập nhật Spring 2026 của Veracode giao tác vụ viết một hàm cho bốn loại CWE, rồi quét output bằng SAST. Kết quả là "chỉ 55% tác vụ sinh code cho ra code an toàn", trong khi tỉ lệ đúng cú pháp tăng từ khoảng 50% lên 95% kể từ 2023. LSCBench dưới đây dùng lỗ hổng thật trong dự án thật, ở phạm vi hàm, file và cả repository, và chấm bằng test khai thác ẩn. Đó là một chuẩn khó hơn và sát thực tế hơn.
Nghiên cứu LSCBench tháng 10/2026 phát hiện gì?
"Last Secure Code Benchmark: Is the Code You Vibe Secure?" (arXiv 2610.14766, nộp ngày 10/10/2026) thử sáu model frontier trên 450 tác vụ. Các tác vụ được dựng từ 150 lỗ hổng thật, trên bảy ngôn ngữ và 24 nhóm CWE. Model tốt nhất viết code vừa đúng vừa an toàn ở 25,1% tác vụ. Chỉ 19 tác vụ được cả sáu model làm an toàn.
Prompt chỉ yêu cầu tính năng chạy được và không hề nhắc đến bảo mật, đúng như cách phần lớn mọi người dùng agent. Kết quả được chấm bằng các bài test chức năng và bảo mật ẩn.
| Model | Đúng chức năng | Vừa đúng vừa an toàn | An toàn ở cả 3 phạm vi (theo kịch bản) |
|---|---|---|---|
| Claude Fable 5 | 91,1% | 25,1% | 12,0% |
| GPT-5.6 Sol | 89,1% | 24,7% | 8,0% |
| Qwen3.8-Max | 89,3% | 22,0% | 8,0% |
| GLM-5.3 | 87,1% | 21,3% | 7,3% |
| DeepSeek-V4-Pro | 73,6% | 18,0% | 6,7% |
| Kimi-K3 | 91,3% | 16,4% | 2,0% |
Nguồn: toàn văn LSCBench, Bảng 10. Có ba phát hiện quan trọng với lãnh đạo kỹ thuật:
- Tỉ lệ đúng chức năng không nói gì về bảo mật. Kimi-K3 có tỉ lệ đúng chức năng cao nhất (91,3%) nhưng tỉ lệ an toàn thấp nhất (16,4%).
- Mỗi model sai ở tác vụ khác nhau. Gộp lại, ít nhất một model làm an toàn được 44,0% tác vụ, so với 25,1% của model tốt nhất. Cho model thứ hai review model thứ nhất bắt được lỗi thật, nhưng còn xa mới bắt hết.
- Cho agent chạy thêm vòng không mua được bảo mật. Nhóm tác giả viết: "More Turns Do Not Buy Security". Để agent lặp lâu hơn không thay được một bước kiểm tra bảo mật.
Lưu ý đây là các model của tháng 8 và 9/2026. Bản mới hơn như Claude Fable 5.2 và Kimi K3.1 Pro chưa được thử. Chúng tôi viết về chúng trong bài về model lập trình open-weight và bản cập nhật agent tháng 11.
AI coding agent hay sai ở loại lỗ hổng nào nhất?
Lỗi luồng dữ liệu ở phía web. Trong LSCBench, lộ thông tin (CWE-200) chỉ được làm an toàn ở 0,7% lần thử, giả mạo request phía server (SSRF, CWE-918) 2,4%, chèn code (CWE-94) 4,9%. An toàn bộ nhớ là nhóm dễ nhất, 34,3%. Veracode cũng thấy xu hướng tương tự: cross-site scripting 15%, log injection 13%, trong khi SQL injection đạt 82%.
Điều này hợp lý. SQL injection và lỗi bộ nhớ có cách sửa cục bộ quen thuộc mà model đã gặp hàng triệu lần. Lộ thông tin, SSRF và injection lại phụ thuộc vào ngữ cảnh model không thấy: cái gì nhạy cảm, host nào là nội bộ, đầu vào đến từ đâu. Hãy đưa ngữ cảnh đó vào hướng dẫn cho agent và vào checklist review. Theo ngôn ngữ, LSCBench thấy C, Python và JavaScript được làm an toàn nhiều nhất (27–30% tác vụ), còn Java, Go và PHP thấp nhất (10–18%). Nhóm tác giả cho rằng phần lớn chênh lệch đến từ loại lỗ hổng có trong tác vụ của từng ngôn ngữ.
Bảo agent "viết code an toàn" có giúp được không?
Có giúp, nhưng còn xa mới đủ. Trong LSCBench, thêm một câu yêu cầu code an toàn làm tỉ lệ vừa đúng vừa an toàn tăng 21,5 điểm với GPT-5.6 Sol (lên 46,2%), 16,9 điểm với GLM-5.3 (lên 38,2%) và 15,6 điểm với Qwen3.8-Max (lên 37,6%). DeepSeek-V4-Pro chỉ tăng 1,1 điểm. Phần lớn tác vụ vẫn không an toàn dù đã nhắc.
Vậy cứ làm. Ghi yêu cầu bảo mật vào AGENTS.md hoặc CLAUDE.md, càng cụ thể càng tốt: "không bao giờ dựng URL từ input người dùng nếu không có allow-list", "không bao giờ log body của request". Việc này miễn phí và có ích. Nhưng đó chỉ là một lời nhắc, không phải biện pháp kiểm soát. Các biện pháp kiểm soát nằm ở phần sau.
Bản thân coding agent có phải là bề mặt tấn công không?
Có. Nghiên cứu tháng 10 chỉ ra hai con đường cụ thể: cấu hình harness yếu và file hướng dẫn bị đầu độc. Rủi ro lớn nhất là auto-approve. Trong một benchmark, bật nó lên làm tỉ lệ tấn công thành công tăng từ 29,2% lên 95,6%.
Cấu hình harness
HarnessSecurity-Bench (arXiv 2610.07639) thử chín cơ chế bảo mật trên sáu harness: Claude Code, Codex CLI, Gemini CLI, gptme, Qwen Code và GitHub Copilot, với 2.500 lượt chạy dùng chung một model nền. Kết quả chính:
- Bật auto-approve tăng hiệu quả công việc nhưng đẩy tỉ lệ tấn công thành công từ 29,2% lên 95,6%.
- Cô lập mạng và chế độ chỉ đọc giảm tấn công, nhưng đổi lại mất đáng kể hiệu quả công việc.
- Allow-list lệnh giảm tấn công, chỉ mất một chút hiệu quả. Deny-list lệnh giảm tấn công và còn tăng nhẹ hiệu quả.
- Khoảng một nửa số cơ chế đã được xác nhận là phải tự bật. Nói cách khác, chúng tắt cho đến khi bạn bật.
File memory và file hướng dẫn
"Security Impact of Coding Agent's Memory Files" (arXiv 2610.38521) cài các file kiểu CLAUDE.md độc hại, trình bày việc bỏ các bước kiểm tra phòng thủ như một thực hành tốt. Nhóm tác giả thử với Claude Code và OpenCode trên 36 tác vụ. Tỉ lệ hoàn thành an toàn dao động từ −8 đến +6 điểm, không theo quy luật nào. Mẫu còn nhỏ, như chính tác giả thừa nhận. Mức độ minh bạch thì khác nhau: Claude Code nêu tên file trong khoảng hai phần ba thông điệp cuối, còn OpenCode gần như chỉ nhắc trong phần suy luận, nơi developer hiếm khi đọc. Quy tắc thực tế: coi thay đổi ở AGENTS.md, CLAUDE.md, skill và cấu hình MCP giống thay đổi cấu hình CI, bắt buộc CODEOWNERS review.
AI coding agent có tìm và sửa được lỗ hổng không?
Tốt hơn so với việc tránh tạo ra chúng. CWE-bench (arXiv 2610.17020) giao cho agent 250 repository thật để rà soát và vá, không nói lỗi ở đâu hay thuộc loại gì. Agent tốt nhất sửa được 67% ở lần thử đầu và 79% sau bốn lần. Một bộ kiểm tra tất định xác nhận bản vá chặn được khai thác mà vẫn giữ chức năng.
Đây là mặt tích cực đáng tận dụng. Cùng một loại model viết ra endpoint có lỗ hổng thường tìm và sửa được nó khi được yêu cầu tìm. Vì vậy hãy chạy một lượt review riêng tập trung vào bảo mật, bằng agent khác hoặc prompt khác, cộng với SAST. Lượt đó bắt được phần lớn những gì lượt viết bỏ sót. GitHub đã đưa việc này vào cloud agent của họ, như phần sau cho thấy.
Biện pháp nào giúp code do AI viết đủ an toàn để merge?
Hãy xếp năm lớp kiểm soát: phân tích tĩnh trong vòng lặp của agent, quét secret, chính sách dependency, môi trường chạy có sandbox, và review của con người mà agent không vượt qua được. Không lớp nào đủ một mình. Kết hợp lại, chúng đưa code của agent từ "nhiều khả năng không an toàn" thành "được review như mọi thay đổi khác".
- SAST trong vòng lặp agent, không chỉ trong CI. Chạy CodeQL hoặc Semgrep như một tool agent bắt buộc phải gọi trước khi xong việc, để nó tự sửa lỗi tìm được. Cloud agent của GitHub Copilot làm việc này mặc định. Trang rủi ro và biện pháp ghi rằng CodeQL kiểm tra lỗi bảo mật, dependency mới được đối chiếu với GitHub Advisory Database, và Copilot code review đưa ra "ý kiến thứ hai" trước khi pull request hoàn tất.
- Secret. Không để credential production ở bất kỳ môi trường nào agent chạm tới. Bật secret scanning kèm push protection. Thay mọi key mà agent đã thấy.
- Chính sách dependency. Chặn dependency mới có cảnh báo mức High hoặc Critical hoặc bị gắn cờ mã độc. Bắt buộc duyệt mọi package mới. Agent thêm package rất thoải mái.
- Sandbox. Không bao giờ bật auto-approve khi có quyền truy cập mạng. Dùng allow-list lệnh, giữ việc ghi file trong thư mục làm việc, và với lượt chạy không người trông thì từ chối thay vì hỏi. Claude Code đã thêm hai thiết lập
blockWritesOutsideWorkingDirectoriesvàdenyInsteadOfPromptingtrong tháng 10 và 11/2026 (changelog). - Review độc lập của con người. Người giao việc cho agent không nên là người duyệt. GitHub áp quy tắc này cho cloud agent: người yêu cầu không được duyệt PR, và workflow Actions phải chờ một người có quyền ghi duyệt rồi mới chạy.
Checklist bảo mật AI agent nói kỹ hơn về các biện pháp này cho agent bạn xây vào sản phẩm. Phần quản trị (allow-list model, budget, audit) có trong bài quản trị AI coding agent trong doanh nghiệp. Nếu bạn tiếp nhận một codebase phần lớn do agent viết, hãy bắt đầu từ bài đưa app vibe-code lên production.
BeevR làm việc này thế nào
BeevR là studio phần mềm và AI ở Hà Nội, đội ngũ senior do founder trực tiếp dẫn dắt. Chúng tôi xây phần mềm cho các ngành chịu quản lý: chúng tôi ký BAA với tư cách business associate khi có dữ liệu y tế, và có thể chạy model ngay trong tài khoản AWS của khách hàng. Quy tắc của chúng tôi cho mọi thành phần AI, kể cả framework agent mã nguồn mở Kite, là model đề xuất, còn code tất định và con người quyết định. Với đội đang đưa coding agent vào dùng, chúng tôi có thể làm một giai đoạn bảo mật phạm vi cố định, từ $10K. Chúng tôi gắn SAST và kiểm tra dependency vào vòng lặp agent, siết sandbox và cách xử lý secret, và dựng một cổng review mà agent không vượt qua được. Mỗi thứ Sáu bạn có demo chạy được, và bạn giữ toàn bộ code và IP.
Đọc thêm về cách chúng tôi làm bảo mật và cách chúng tôi làm việc với tư cách công ty phát triển AI agent, hoặc đặt lịch gọi 30 phút và mang theo một pull request gần đây do agent viết. Chúng tôi sẽ cùng bạn review nó.