Các model lập trình open-weight mạnh nhất tháng 11/2026 là Kimi K3.1 Pro (2,8T tham số), GLM-5.3, DeepSeek V4.1 Flash và V4 Pro, Qwen3.8 và Mistral Large 4. Chỉ DeepSeek cùng các bản GLM và Qwen nhỏ dùng license MIT hoặc Apache 2.0. Các bản flagship cần 600 GB đến 2,5 TB trọng số, tức tối thiểu một node 8 GPU, có khi hơn.
Cập nhật ngày 13/11/2026. Mọi con số dưới đây lấy từ model card hoặc file license trên Hugging Face của chính nhà phát triển, đọc trong hôm nay: ngày phát hành, số tham số, context window và license. Benchmark là điểm do từng hãng tự công bố, thường chạy với harness và mức effort khác nhau. Hãy dùng chúng để lập danh sách rút gọn, không phải để chọn người thắng. Nếu bạn chỉ cần một coding agent dạng dịch vụ, hãy đọc bài so sánh Cursor, Claude Code, Codex và Devin trước. Bài này dành cho đội cần trọng số model mà mình tự kiểm soát.
Model lập trình open-weight nào tốt nhất cuối năm 2026?
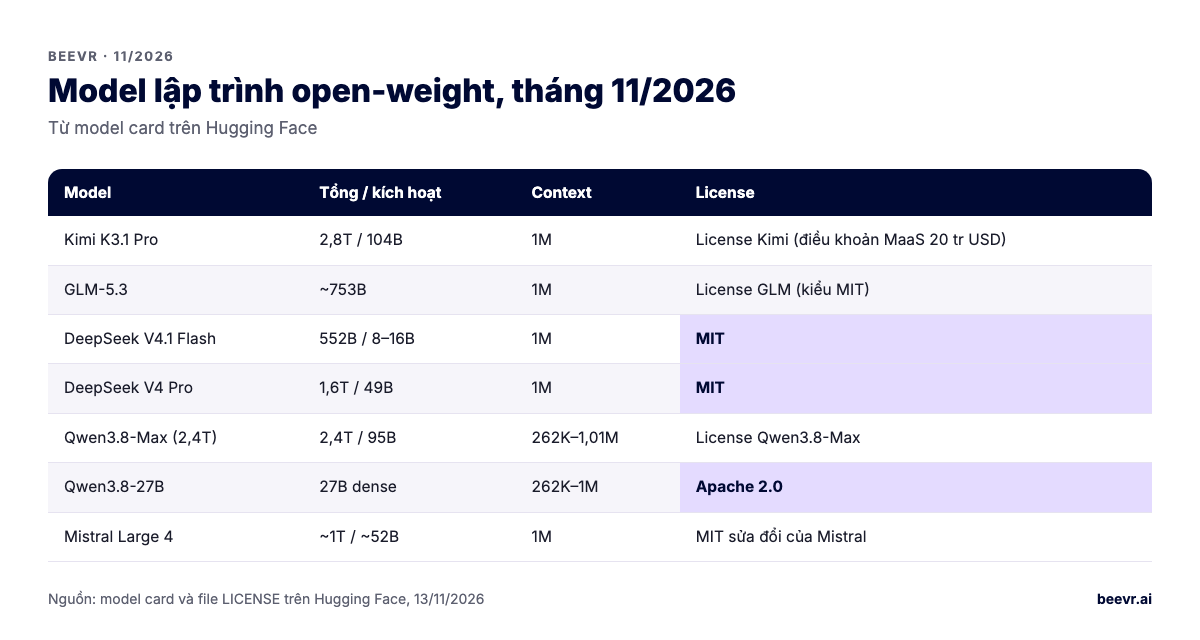
Nhóm dẫn đầu của model open-weight hiện gồm năm dòng model từ năm phòng lab. Tất cả đều là flagship mixture-of-experts với context khoảng 1 triệu token. Theo điểm coding dạng agent do các hãng tự công bố, chúng đã sát các model đóng hàng đầu. Bảng dưới liệt kê checkpoint mới nhất liên quan đến lập trình của từng hãng.
| Model (hãng) | Lên Hugging Face | Tổng / tham số kích hoạt | Context | License |
|---|---|---|---|---|
| Kimi K3.1 Pro (Moonshot AI) | 2/11/2026 | 2,8T / 104B | 1.048.576 | Kimi K3.1 Pro License (kiểu MIT, có điều khoản doanh thu) |
| GLM-5.3 (Z.ai) | 25/8/2026 | ~753B (đếm trọng số; card không nêu số kích hoạt) | 1M (config) | GLM-5.3 License (kiểu MIT, có điều khoản rà soát bảo mật) |
| GLM-5.3-Flash (Z.ai) | 25/8/2026 | 320B / 18B | Card không nêu | MIT |
| DeepSeek-V4.1-Flash-1017 | 17/10/2026 | 552B backbone / 8B–16B | 1M | MIT |
| DeepSeek-V4-Pro-0813 | 13/8/2026 | 1,6T / 49B | 1M (config) | MIT |
| Qwen3.8-2.4T-A95B (Qwen3.8-Max bản mở) | 8/8/2026 | 2,4T / 95B | 262K gốc, mở rộng tới 1,01M | Qwen3.8-Max License (có điều khoản doanh thu) |
| Qwen3.8-27B | 5/8/2026 | 27B dense | 262K gốc, mở rộng tới 1M | Apache 2.0 |
| Mistral Large 4 | 30/9/2026 | ~1T / ~52B | 1M | Mistral Ecosystem Open-Weight License (MIT sửa đổi) |
Nguồn: model card của Kimi K3.1 Pro, GLM-5.3, DeepSeek-V4.1-Flash, Qwen3.8-27B và Mistral Large 4. Ngày là ngày tạo repository trên Hugging Face.
Model open-weight nào tốt nhất cho agentic coding?
Theo số liệu các hãng tự công bố, Kimi K3.1 Pro và DeepSeek V4.1 Flash dẫn đầu về agentic coding. GLM-5.3, DeepSeek V4 Pro và Qwen3.8-Max theo sát trên các benchmark terminal cũ hơn. Khoảng cách nhỏ và mỗi hãng dùng harness khác nhau, nên hãy tự đánh giá trước khi quyết định.
Mỗi hãng công bố gì
- Kimi K3.1 Pro: 65,7 trên Terminal-Bench 4.0, so với 66,4 của Claude Opus 5.5 và 41,8 của GLM-5.3 trong cùng bảng. Model đạt thêm 75,5 trên DeepSWE v1.1 và 51,7 trên SWE Marathon v1.1. Tất cả chạy ở mức reasoning effort max.
- DeepSeek-V4.1-Flash-1017: 77,0 trên DeepSWE v1.1 và 42,3 trên Terminal-Bench 4.0. DeepSeek gọi đây là bản cập nhật nhỏ, đồng thời rút ngắn thời gian chạy và độ dài output.
- GLM-5.3: 88,2 trên Terminal Bench 2.1, 28,3 trên Terminal Bench 3.0 và 66,9 trên DeepSWE. Z.ai cho biết model đạt 84,5 trên CyberGym, và đây cũng là một lời cảnh báo: năng lực tấn công mạng của nó "phát triển nhanh hơn dự kiến".
- DeepSeek-V4-Pro-0813: 87,9 trên Terminal Bench 2.1 và 62,7 trên DeepSWE, chạy bằng harness riêng của DeepSeek.
- Qwen3.8-Max (2.4T-A95B): 86,6 trên Terminal Bench 2.1 và 67,7 trên SWE-bench Pro. Bản nhỏ Qwen3.8-27B đạt 73,0 và 61,7 trên hai bài test đó, rất tốt với một model vừa một GPU.
- Mistral Large 4: 48% trên Coding Agent Index của Artificial Analysis. Theo Mistral, con số này "gần như ngang" GLM-5.3 nhưng dùng ít hơn 47% token mỗi tác vụ.
Các bảng trên không cho biết code có an toàn hay không. Trong nghiên cứu LSCBench tháng 10/2026, Kimi K3 viết code vừa chạy đúng vừa an toàn ở 16,4% tác vụ. GLM-5.3 đạt 21,3%, Qwen3.8-Max 22,0%, DeepSeek V4 Pro 18,0%. Model đóng tốt nhất đạt 25,1%. Xem phân tích các benchmark bảo mật coding agent.
Các model này có thật sự là mã nguồn mở, dùng thương mại được không?
Chỉ DeepSeek (MIT), Qwen3.8-27B (Apache 2.0) và GLM-5.3-Flash (MIT) dùng license dễ dãi tiêu chuẩn. Bản flagship của Moonshot, Z.ai, Qwen và Mistral dùng license kiểu MIT kèm điều kiện. Phần lớn điều kiện đó chỉ áp dụng khi bạn bán lại quyền truy cập model dưới dạng dịch vụ. Hãy đọc file license, đừng đọc báo.
- Kimi K3.1 Pro: nếu bạn hoặc công ty liên kết kinh doanh "Model as a Service" với doanh thu trên 20 triệu USD trong 12 tháng, bạn cần thoả thuận riêng với Moonshot trước khi dùng thương mại.
- GLM-5.3: doanh nghiệp Model-as-a-Service doanh thu trên 10 tỷ USD phải qua rà soát bảo mật của Z.ai. Với gần như mọi công ty, license này tương đương MIT.
- Qwen3.8-Max: doanh nghiệp Model-as-a-Service hoặc "AI Work Assistant" doanh thu trên 50 triệu USD cần license riêng. Dùng nội bộ được miễn. Sản phẩm trên 100 triệu người dùng/tháng hoặc doanh thu 20 triệu USD/tháng phải hiển thị tên model. Bản nhỏ hơn Qwen3.8-Flash-Next dùng Qwen Community License, bắt buộc license riêng cho mọi doanh nghiệp Model-as-a-Service.
- Mistral Large 4: mọi doanh nghiệp Model-as-a-Service đều cần license thương mại của Mistral, bất kể quy mô.
Mọi license ở đây định nghĩa "Model as a Service" theo cách loại trừ sản phẩm cho người dùng cuối có nhúng model vào tính năng cụ thể. Một coding agent dùng trong công ty, hay một tính năng sản phẩm xây trên các model này, nhìn chung nằm ngoài điều khoản đó. Hãy nhờ luật sư xác nhận cho trường hợp của bạn.
Tự host một model lập trình open-weight cần bao nhiêu phần cứng?
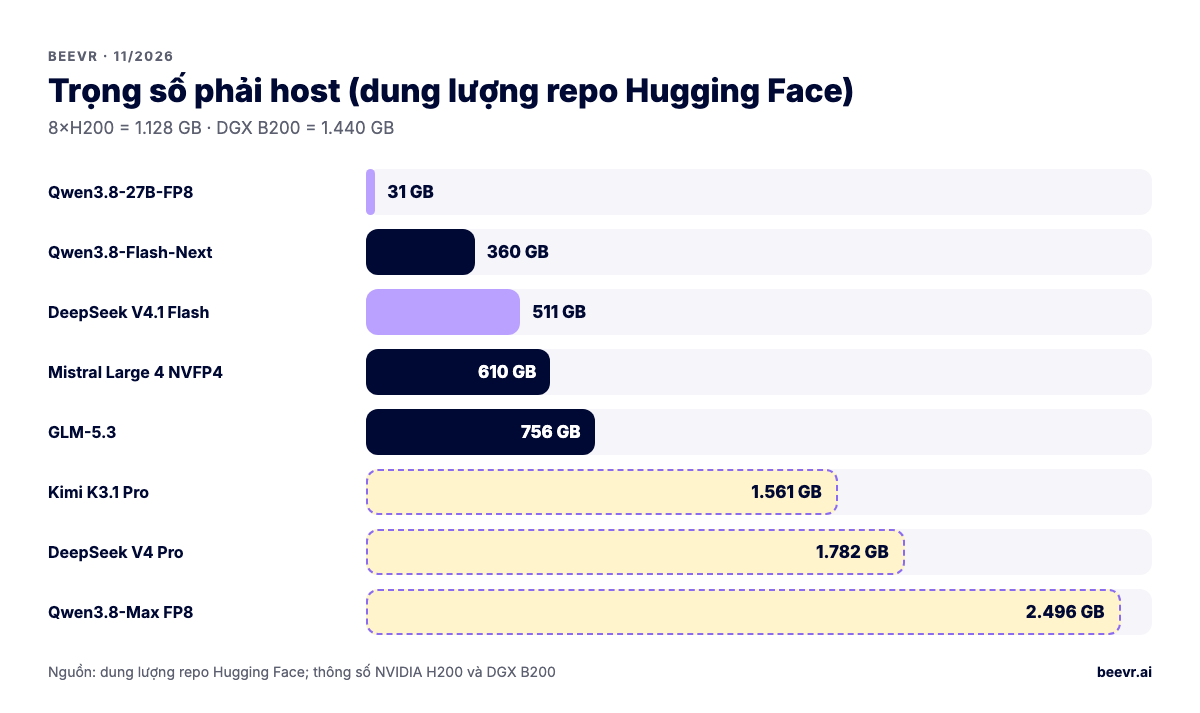
Hãy tính toàn bộ model phải nằm trong bộ nhớ GPU, không chỉ phần tham số kích hoạt. Trọng số flagship trên Hugging Face nặng từ khoảng 610 GB đến 2,5 TB. Nghĩa là tối thiểu một node 8 GPU H200 (8 × 141 GB = 1.128 GB) hoặc phần cứng cỡ B200 (một DGX B200 có 1.440 GB), và thường là hai node cho model lớn nhất. Còn cần thêm chỗ cho KV cache.
Dung lượng repository trên Hugging Face, theo số công bố (13/11/2026):
- Qwen3.8-27B-FP8: 31 GB, vừa một GPU 80 GB và còn chỗ cho context.
- Qwen3.8-Flash-Next: 360 GB
- DeepSeek-V4.1-Flash-1017: 511 GB
- Mistral Large 4 NVFP4: 610 GB (checkpoint đầy đủ 1.061 GB)
- GLM-5.3: 756 GB
- Kimi K3.1 Pro: 1.561 GB, đã được Moonshot lượng tử hoá MXFP4
- DeepSeek-V4-Pro-0813: 1.782 GB
- Qwen3.8-2.4T-A95B-FP8: 2.496 GB
Thông số phần cứng lấy từ trang H200 và DGX B200 của NVIDIA. Mọi flagship đều liệt kê vLLM và SGLang là engine phục vụ được hỗ trợ, và card của Mistral lấy ví dụ tensor parallel 8 chiều.
Vì sao tham số kích hoạt vẫn quan trọng
Model mixture-of-experts giữ mọi expert trong bộ nhớ, nhưng lượng tính toán mỗi token tỉ lệ với tham số kích hoạt. DeepSeek V4.1 Flash kích hoạt 8B–16B, còn Kimi K3.1 Pro là 104B. Nên khi trọng số đã vừa bộ nhớ, model có ít tham số kích hoạt phục vụ được nhiều token hơn hẳn trên mỗi giờ GPU. Với agent điều này quan trọng hơn chat, vì một lượt chạy agent có thể đốt hàng triệu token.
Tự host có rẻ hơn trả tiền API model đóng không?
Thường là không, trừ khi tải gần như liên tục hoặc bạn buộc phải giữ code trên phần cứng của mình. Một node chứa một model flagship tốn tiền như nhau dù bận hay rảnh. Tải của agent lại lên xuống thất thường: cao trong giờ làm, gần như bằng không vào ban đêm.
Tự host thường có lợi trong ba trường hợp:
- Bắt buộc kiểm soát dữ liệu, ví dụ source code không được ra khỏi mạng nội bộ, hoặc môi trường quốc phòng, chính phủ.
- Mức sử dụng cao, như refactor hàng loạt, sinh test trên nhiều repo, hoặc nhiều developer ở nhiều múi giờ.
- Model nhỏ là đủ. Qwen3.8-27B trên một GPU xử lý được sửa lint, dựng khung test và tìm kiếm code, còn API frontier lo việc khó.
Phần lớn các lab này cũng bán API dạng dịch vụ cho chính các model đó (Kimi, Z.ai, Qwen Cloud, Mistral). Với tải agent thất thường, đây thường là cách rẻ hơn để dùng cùng bộ trọng số. Đổi lại, code của bạn được xử lý bởi hãng đó, nên câu hỏi về dữ liệu lại quay về. Bối cảnh rộng hơn có trong bài chi phí vận hành sản phẩm AI.
Có dùng model open-weight với Claude Code, Codex hay Cursor được không?
Được một phần. Nhiều hãng đánh giá model của mình bên trong Claude Code: GLM-5.3, Qwen3.8 và Kimi K3.1 Pro đều công bố kết quả chạy bằng harness Claude Code, và Kimi có API tương thích Anthropic. Nhưng trên thực tế, các agent thương mại giới hạn model được hỗ trợ chính thức.
- Codex CLI hỗ trợ custom model provider trong cấu hình. Ollama có tài liệu hướng dẫn chạy với model local.
- Claude Code chính thức hỗ trợ model Claude qua Anthropic, Bedrock, Vertex và Foundry. Trỏ sang model khác qua gateway không phải cấu hình được hỗ trợ, nên hãy coi là thử nghiệm.
- GitHub Copilot có Kimi K3 trong danh sách model, tức đã có một model open-weight qua GitHub.
- Agent mã nguồn mở như OpenHands, Cline và Aider được thiết kế để chạy với mọi endpoint tương thích OpenAI. Đây là con đường gọn nhất cho trọng số tự host.
Nếu bạn nối model vào công cụ của riêng mình, một Model Context Protocol server giúp lớp tool giữ nguyên khi đổi model. Xem phát triển MCP server.
Nên chọn model lập trình open-weight thế nào?
Hãy bắt đầu từ ràng buộc của bạn, không phải bảng xếp hạng. Kiểm tra license trước, rồi phần cứng, rồi chấm điểm trên tác vụ của chính bạn. Hai tuần đánh giá trên 50–100 ticket thật từ repo của bạn nói nhiều hơn mọi bảng trong bài này.
- Hợp license. Nếu bán lại inference, hãy chọn MIT (DeepSeek) hoặc Apache 2.0 (Qwen3.8-27B), hoặc đàm phán với hãng.
- Hợp phần cứng. Một GPU: Qwen3.8-27B. Một node 8 GPU: DeepSeek V4.1 Flash, GLM-5.3 hoặc Mistral Large 4 NVFP4. Nhiều hơn một node: Kimi K3.1 Pro, DeepSeek V4 Pro, Qwen3.8-Max.
- Hợp tác vụ. Chấm tỉ lệ pass, thời gian review và lỗi bảo mật trên repo của bạn, bên trong đúng harness agent bạn sẽ dùng.
- Hợp an toàn. Z.ai cảnh báo GLM-5.3 có năng lực tấn công mạng mạnh. Hãy sandbox mọi agent chạy được code, dù dùng model nào. Checklist bảo mật AI agent liệt kê các biện pháp kiểm soát.
BeevR làm việc này thế nào
BeevR là studio phần mềm và AI ở Hà Nội, đội ngũ senior do founder trực tiếp dẫn dắt. Chúng tôi xây hệ thống AI production trong đó model là thành phần không đáng tin và thay được. Nghĩa là có bộ eval trước, lớp tool không phụ thuộc một nhà cung cấp, và môi trường chạy có sandbox. Với khách hàng ngành chịu quản lý, model có thể chạy ngay trong tài khoản AWS của khách. Chúng tôi có thể so sánh model open-weight và model đóng trên codebase và tác vụ của bạn trong một giai đoạn phạm vi cố định, từ $10K, mỗi thứ Sáu có demo chạy được. Bạn sở hữu code, bộ eval và kết quả.
Xem cách chúng tôi làm việc với tư cách công ty phát triển AI, hoặc đặt lịch gọi 30 phút để khoanh phạm vi một đợt đánh giá model.