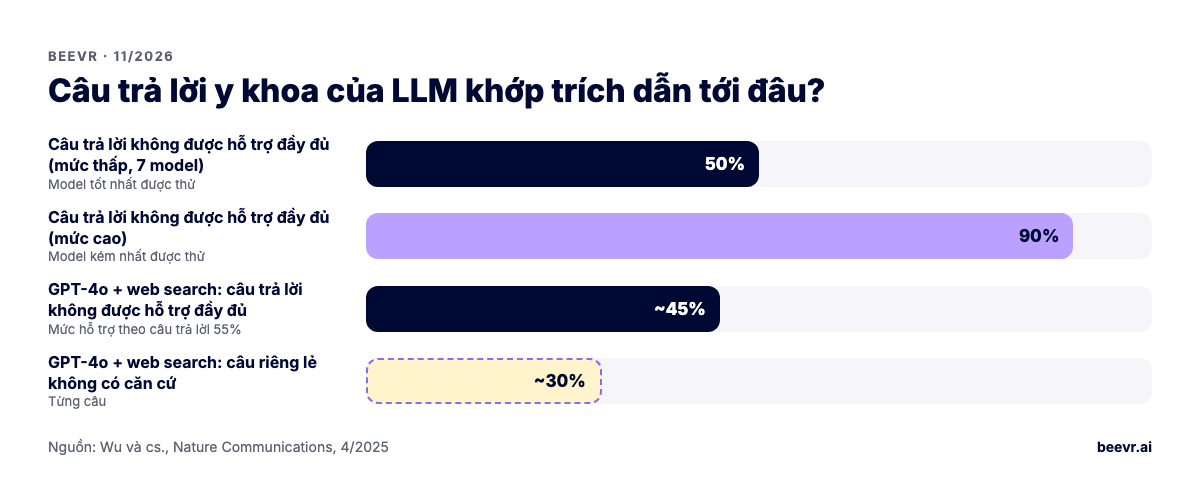
RAG trên hướng dẫn lâm sàng và chính sách nội bộ chạy tốt khi mọi câu trả lời trích đúng đoạn văn và phiên bản nó dựa vào, và hệ thống từ chối khi không có gì làm căn cứ. Thiếu điều đó, rắc rối là chắc chắn: một nghiên cứu năm 2025 trên Nature Communications cho thấy 50–90% câu trả lời y khoa của LLM không được chính trích dẫn của chúng hỗ trợ đầy đủ.
Retrieval-augmented generation là kiến trúc mặc định cho các công cụ "hỏi chính sách" và "hỏi hướng dẫn" ở bệnh viện, payer và công ty digital health. Nó trông đơn giản: chia nhỏ tài liệu, tạo embedding, lấy các kết quả đầu, để model trả lời. Trong môi trường lâm sàng, phiên bản đơn giản hỏng theo những cách cụ thể và đoán trước được: phiên bản cũ, sai nhóm bệnh nhân, trích dẫn không nói điều câu trả lời khẳng định. Bài này đi qua các lựa chọn kiến trúc quan trọng, các kiểu lỗi, cách đánh giá, và khi nào RAG là công cụ sai. Kiểm tra ngày 12/11/2026.
Khi nào RAG là kiến trúc đúng cho hướng dẫn lâm sàng và chính sách?
RAG đúng khi câu trả lời đã được viết trong tài liệu bạn kiểm soát, thay đổi theo thời gian, và clinician hay nhân viên tự kiểm được đoạn trích dẫn. Tra chính sách, điều hướng hướng dẫn, tiêu chí chi trả của payer và câu hỏi về quy trình rất hợp. Tính toán theo bệnh nhân cụ thể và liều thuốc thì không.
Phép thử là một người có thể trả lời câu hỏi bằng cách tìm đúng đoạn văn hay không. Nếu có, RAG tiết kiệm thời gian tìm và đưa ra đoạn đó. Nếu câu trả lời cần kết hợp dữ liệu bệnh nhân với quy tắc (điều kiện, chỉnh liều, điểm nguy cơ), bạn cần logic có cấu trúc hoặc một công cụ tính đã được kiểm định, có thể để model chỉ giải thích kết quả. Trộn hai thứ trong một prompt là chỗ nhiều trợ lý lâm sàng đi sai.
Nên chia nhỏ (chunk) hướng dẫn lâm sàng thế nào để truy xuất?
Chia theo cấu trúc của chính tài liệu, không theo số token cố định. Một khuyến nghị, mức độ khuyến nghị và cấp bằng chứng, nhóm đối tượng và các lưu ý phải đi cùng nhau, và mỗi chunk phải mang metadata: nguồn, phiên bản, ngày hiệu lực, đường dẫn mục, nhóm đối tượng và người phụ trách.
Những quy tắc đứng vững
- Tôn trọng tiêu đề và ranh giới khuyến nghị. Chia theo mục và khuyến nghị, chỉ chia nhỏ thêm nếu mục quá dài. Giữ đường dẫn mục ("Nhiễm khuẩn huyết > Người lớn > Thời điểm kháng sinh") trong nội dung chunk để bước truy xuất thấy được.
- Giữ điều kiện đi kèm. "Trừ phụ nữ có thai" ở đoạn kế tiếp chính là loại văn bản bị cắt mất khi chia theo kích thước cố định. Gắn chú thích và ngoại lệ vào đúng khuyến nghị mà chúng điều chỉnh.
- Coi bảng là đơn vị chính. Bảng liều và bảng tiêu chí mất nghĩa khi bị làm phẳng. Lưu từng dòng kèm tiêu đề cột, hoặc giữ cả bảng là một chunk kèm phần tóm tắt văn bản để truy xuất.
- Đánh chỉ mục định nghĩa riêng. Các thuật ngữ như "nguy cơ cao" thường chỉ được định nghĩa một lần, cách xa vài trang. Liên kết chunk định nghĩa để nó được lấy cùng.
- Dùng truy xuất lai. Kết hợp tìm theo từ khóa (tên thuốc, mã, thuật ngữ chính xác) với embedding, rồi rerank. Chỉ dùng vector search thì yếu với định danh chính xác.
Xử lý phiên bản hướng dẫn và chính sách nội bộ ghi đè thế nào?
Lưu mọi phiên bản kèm ngày hiệu lực và liên kết "thay thế cho", chỉ lấy phiên bản đang có hiệu lực tại thời điểm được hỏi, và xếp chính sách nội bộ trên hướng dẫn bên ngoài khi tổ chức đã áp dụng quy tắc riêng. Hiển thị phiên bản và ngày trong mọi câu trả lời.
Hướng dẫn cũ là lỗi âm thầm nguy hiểm nhất trong RAG lâm sàng, vì câu trả lời trông đúng và trích một tài liệu có thật. Ba kiểm soát ngăn nó:
- Sổ đăng ký phiên bản. Mỗi tài liệu có ID, phiên bản, ngày bắt đầu và kết thúc hiệu lực, người phụ trách và trạng thái (nháp, hiệu lực, hết hiệu lực). Mặc định truy xuất lọc theo trạng thái hiệu lực và ngày của câu hỏi.
- Quy tắc ưu tiên. Quyết định bằng văn bản thứ tự giữa quy trình nội bộ, chính sách payer và hướng dẫn quốc gia, rồi mã hóa nó. Khi hai nguồn đang hiệu lực mâu thuẫn, câu trả lời phải nói rõ và đưa cả hai, không âm thầm chọn một.
- Quy trình thay đổi. Khi tài liệu đổi, chia và đánh chỉ mục lại, gỡ chunk cũ, và chạy lại các câu hỏi đánh giá liên quan. Người phụ trách chính sách ký duyệt trước khi phiên bản mới có hiệu lực.
Làm sao để trích dẫn trong câu trả lời RAG lâm sàng đáng tin?
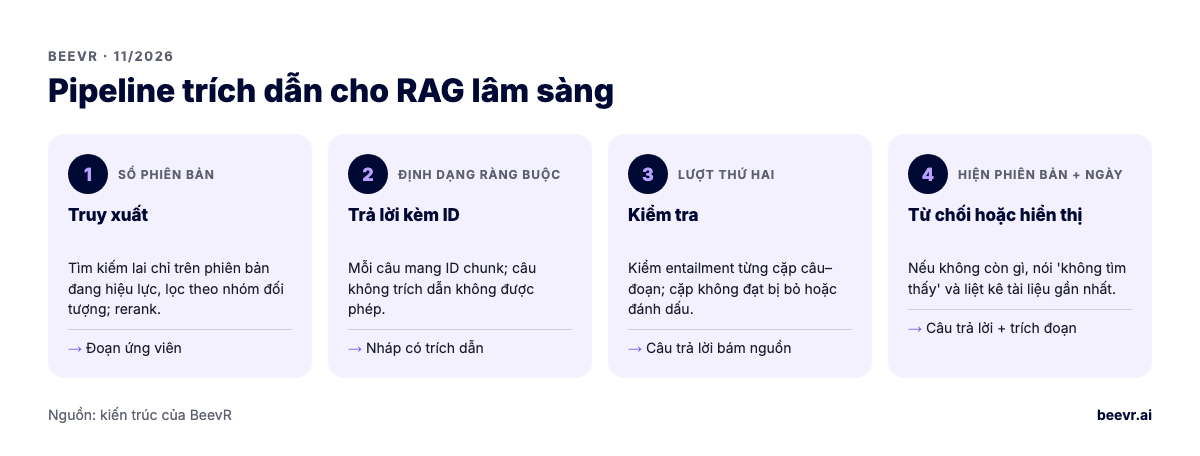
Trích dẫn ở cấp từng câu, liên kết tới đúng đoạn văn, và sau khi sinh câu trả lời thì kiểm tra mỗi đoạn được trích thực sự hỗ trợ câu đó. Bỏ hoặc đánh dấu câu không qua kiểm tra, và cho hệ thống nói "tôi không tìm thấy điều này trong chính sách hiện hành" thay vì trả lời bằng kiến thức chung của model.
Bằng chứng cho việc này rất rõ. Wu và cộng sự trên Nature Communications (tháng 4/2025) thử bảy model trên 800 câu hỏi y khoa và gần 58.000 cặp câu–nguồn. Từ 50% đến 90% câu trả lời không được nguồn trích dẫn hỗ trợ đầy đủ, và kể cả GPT-4o có web search vẫn để khoảng 30% câu riêng lẻ không có căn cứ. Truy xuất giúp ích; nó không đảm bảo câu trả lời bám nguồn.
Một pipeline trích dẫn chạy được
- Định dạng câu trả lời có ràng buộc. Mỗi câu mang một hoặc nhiều ID chunk. Câu không có ID không được xuất hiện trong câu trả lời cuối.
- Đoạn trích chính xác. Hiển thị đúng văn bản hỗ trợ khi người dùng rê chuột hoặc mở rộng, không chỉ tên tài liệu.
- Kiểm tra suy diễn (entailment). Một lượt thứ hai, bằng lời gọi model riêng hoặc một bộ phân loại nhỏ hơn, hỏi "đoạn này có hỗ trợ câu này không?" cho từng cặp. Cặp không đạt bị bỏ hoặc đánh dấu.
- Đường từ chối. Nếu độ tin cậy truy xuất thấp hoặc không đoạn nào qua kiểm tra, câu trả lời là "không tìm thấy" rõ ràng, kèm danh sách tài liệu gần nhất để người dùng tự đọc.
RAG lâm sàng thường hỏng theo những cách nào?
Các lỗi lặp lại là truy xuất trượt, phiên bản cũ, sai nhóm đối tượng, nguồn mâu thuẫn, bảng bị cắt, trích dẫn không hỗ trợ khẳng định, trả lời vượt ngoài tài liệu, và chỉ thị giấu trong tài liệu. Mỗi lỗi có một kiểm soát cụ thể.
| Kiểu lỗi | Biểu hiện | Kiểm soát |
|---|---|---|
| Truy xuất trượt | Có câu trả lời đúng nhưng không nằm trong kết quả đầu | Tìm kiếm lai, rerank, viết lại truy vấn; đo recall@k |
| Phiên bản cũ | Câu trả lời trích một quy trình đã hết hiệu lực | Sổ phiên bản có ngày hiệu lực; lọc theo trạng thái hiệu lực |
| Sai nhóm đối tượng | Đưa hướng dẫn người lớn cho câu hỏi nhi khoa | Metadata nhóm đối tượng; hỏi lại khi không rõ |
| Nguồn mâu thuẫn | Chính sách nội bộ và hướng dẫn quốc gia không khớp | Quy tắc ưu tiên bằng văn bản; đưa cả hai khi chưa giải quyết |
| Ngữ cảnh bị cắt | Bảng hoặc ngoại lệ bị tách khỏi khuyến nghị | Chia theo cấu trúc; bảng là một đơn vị |
| Trích dẫn không hỗ trợ | Trích dẫn có thật nhưng không nói điều câu văn nói | Kiểm tra entailment từng câu sau khi sinh |
| Trả lời vượt tài liệu | Model lấp chỗ trống bằng kiến thức chung | Đường từ chối; cấm câu không có trích dẫn |
| Chỉ thị bị chèn | Tài liệu chứa văn bản điều khiển model | Coi văn bản truy xuất là dữ liệu; gỡ hoặc đánh dấu chỉ thị; giới hạn công cụ |
Lỗi cuối dễ bị quên: nếu kho tài liệu có PDF được tải lên hoặc trang bên ngoài, bất kỳ cái nào cũng có thể chứa văn bản nhắm vào model. OWASP xếp prompt injection, gồm cả chèn gián tiếp qua nội dung được truy xuất, là rủi ro số một của ứng dụng LLM. Nhóm rủi ro này có trong checklist bảo mật AI agent.
Đánh giá một hệ thống RAG lâm sàng thế nào?
Xây bộ câu hỏi từ câu hỏi thật của người dùng, nhờ clinician hoặc người phụ trách chính sách viết câu trả lời tham chiếu và đoạn nguồn cho từng câu, rồi đo riêng recall truy xuất, mức bám nguồn, từ chối đúng và đúng phiên bản. Chạy bộ này mỗi khi tài liệu, prompt, model hay cấu hình truy xuất thay đổi.
- Recall@k của truy xuất. Đoạn chuẩn có nằm trong k kết quả đầu không? Nếu không, bước sinh không có cơ hội.
- Bám nguồn. Tỷ lệ câu trong câu trả lời được đoạn trích dẫn hỗ trợ.
- Đúng nội dung. Câu trả lời có khớp tham chiếu của clinician không? Chấm riêng lỗi nặng và lỗi nhẹ.
- Từ chối. Thêm những câu hỏi tài liệu không trả lời được. Đầu ra đúng là "không tìm thấy", và cần đo hệ thống nói câu đó bao thường xuyên.
- Đúng phiên bản. Câu hỏi có đáp án thay đổi giữa các phiên bản. Hệ thống phải đưa đáp án hiện hành.
Bắt đầu với 100–200 câu hỏi mỗi lĩnh vực, thêm mọi lỗi thật người dùng báo, và quản lý phiên bản bộ câu hỏi. Đây là cùng kỷ luật như mọi hệ thống LLM chịu quản lý; xem kiểm thử LLM cho ngành chịu quản lý. Trong production, ghi log truy vấn, chunk đã lấy, câu trả lời và phản hồi người dùng để lần được một câu trả lời sai về nguyên nhân.
Khi nào RAG là công cụ sai?
Khi câu trả lời phụ thuộc vào tính toán trên dữ liệu bệnh nhân, khi đã có quy tắc hỗ trợ quyết định lâm sàng được kiểm định, khi kho tài liệu quá nhỏ để cần tìm kiếm, hoặc khi đầu ra biến sản phẩm thành thiết bị y tế chịu quản lý mà không có kiểm soát tương xứng.
- Liều và điểm số. Dùng code xác định hoặc công cụ tính đã kiểm định. Model có thể giải thích kết quả và trích hướng dẫn mà quy tắc dựa vào.
- Câu hỏi có cấu trúc. "Bao nhiêu bệnh nhân quá hạn X?" là truy vấn database, không phải truy xuất văn bản.
- Kho rất nhỏ. Nếu toàn bộ bộ chính sách vừa thoải mái trong context của model, một prompt có cấu trúc tốt với toàn văn có thể tốt hơn truy xuất và bớt một kiểu lỗi. Ở quy mô lớn, truy xuất vẫn thắng về quản lý phiên bản.
- Trả lời cho bệnh nhân. Hướng dẫn lâm sàng cho bệnh nhân mang rủi ro khác và, ở một số bang, có quy định công khai; xem luật AI y tế theo từng bang.
FDA có quản lý công cụ RAG cho clinician không?
Có thể, tùy công cụ làm gì. Hướng dẫn phần mềm hỗ trợ quyết định lâm sàng của FDA, sửa đổi tháng 1/2026, giữ phần mềm cho clinician ngoài phạm vi quản lý thiết bị khi, cùng các tiêu chí khác, clinician có thể tự rà căn cứ của khuyến nghị. Trích dẫn từng câu tới đoạn nguồn là cách một công cụ RAG đáp ứng điều đó.
Hướng dẫn CDS hiện hành áp dụng các tiêu chí trong mục 520(o)(1)(E) của Đạo luật FD&C. Các nhà bình luận pháp lý như Covington lưu ý bản sửa đổi 2026 gần như im lặng về AI tạo sinh và tập trung vào công cụ cho clinician. Một công cụ RAG tóm tắt chính sách nội bộ cho nhân viên thuộc nhóm rủi ro khác hẳn một công cụ khuyến nghị điều trị cho bệnh nhân cụ thể. Hãy có ý kiến chuyên gia pháp chế trước khi ra mắt loại thứ hai.
BeevR làm việc này thế nào
Chúng tôi xây hệ thống RAG cho hướng dẫn lâm sàng và chính sách với các kiểm soát trên là mặc định: nạp tài liệu theo cấu trúc, giữ nguyên bảng, sổ phiên bản có ngày hiệu lực và quy tắc ưu tiên, truy xuất lai có rerank, trích dẫn từng câu được kiểm sau khi sinh, đường từ chối, và bộ đánh giá do clinician của bạn sở hữu chạy trong CI. PHI không vào chỉ mục trừ khi bài toán cần, và khi cần thì truy xuất lọc theo quyền của người dùng. Model có thể chạy trong chính tài khoản AWS của bạn dưới BAA với AWS, và BeevR ký BAA với vai trò business associate.
Chúng tôi là đội senior do founder dẫn dắt tại Hà Nội, 5.0 trên Clutch, và đã xây một EHR multi-tenant đang chạy tại bốn phòng khám ở Mỹ với khoảng 300 bệnh nhân mỗi ngày. Chúng tôi làm theo giai đoạn cố định, từ $10K mỗi giai đoạn, có demo chạy được mỗi thứ Sáu, và bạn sở hữu code từ ngày đầu. Xem phát triển AI agent cho y tế và kiến trúc AI agent tuân thủ HIPAA.
Nếu bạn đang lên kế hoạch một trợ lý hướng dẫn hoặc chính sách, đặt một cuộc gọi 30 phút. Mang theo hai ba tài liệu thật và mười câu hỏi thật, chúng tôi sẽ chỉ ra pipeline đơn giản sẽ hỏng ở đâu.