Kiểm thử LLM trong ngành phải tuân thủ chỉ qua được audit khi mỗi quy định bạn phải tuân theo đều gắn với một bài test có tên, và mỗi bài test để lại một bằng chứng mà người ngoài đội có thể tự kiểm tra. Điểm accuracy đơn thuần không làm được điều đó. Trên thực tế, một kế hoạch sẵn sàng cho audit gồm bốn phần: bộ dữ liệu chuẩn (golden dataset) có phiên bản, do chuyên gia nghiệp vụ gắn nhãn; cổng hồi quy trong CI cho mọi thay đổi model hoặc prompt; test tấn công và test ranh giới dữ liệu; và chấm điểm mẫu lưu lượng thật, có người duyệt. Phần lớn các đội chưa tới mức đó. Trong khảo sát State of Agent Engineering 2026 của LangChain, 94% đội có agent chạy production đã có observability, nhưng chỉ 37,3% tổng số người trả lời chạy eval online. Bài này gắn HIPAA, PCI DSS, EU AI Act và hướng dẫn ngân hàng Mỹ với từng bài test và bằng chứng cụ thể. Cập nhật tháng 10/2026.
Vì sao ngành tuân thủ cần nhiều hơn một bộ eval LLM thông thường?
Bộ eval thông thường hỏi model có tốt không. Auditor hỏi câu khác: cho tôi xem biện pháp kiểm soát, cho tôi thấy nó đã chạy, và cho tôi thấy chuyện gì xảy ra khi nó thất bại. Trả lời được những câu đó cần bằng chứng dùng được sau sự việc: phiên bản model nào đã trả lời, nó thấy dữ liệu gì, nó đã qua bộ test nào, ai duyệt các ngoại lệ, và sau đó đã thay đổi gì.
Khoảng trống này có thật. LangChain khảo sát 1.340 người làm nghề từ tháng 11 đến tháng 12/2025 và công bố kết quả tháng 6/2026. Trong các đội có agent chạy production, 94% có observability ở mức nào đó và 71,5% có tracing đầy đủ. Tính trên toàn bộ người trả lời, chỉ 52,4% chạy eval offline và 37,3% chạy eval online. Trace cho biết chuyện gì đã xảy ra. Eval cho biết kết quả đó có chấp nhận được không. Sản phẩm trong ngành tuân thủ cần cả hai, và cần ghi lại thành văn bản. Phần phân biệt chung giữa eval và observability có trong bài đánh giá và quan sát AI agent. Bài này nói về lớp tuân thủ nằm bên trên.
Năm 2026, quy định nào thực sự đòi hỏi kiểm thử LLM và agent?
Rất ít luật nhắc thẳng tới LLM. Nhưng nhiều luật đặt ra nghĩa vụ kiểm thử, ghi log và chịu trách nhiệm, áp dụng cho mọi hệ thống xử lý dữ liệu hoặc đưa ra quyết định đó. Đây là những gì áp dụng tính đến tháng 10/2026:
- EU AI Act. Nghĩa vụ minh bạch ở Điều 50 áp dụng từ 2/8/2026: người dùng phải được biết khi họ đang tương tác với hệ thống AI. Nghĩa vụ đánh dấu nội dung tổng hợp ở dạng máy đọc được theo Điều 50(2) được lùi sang 2/12/2026 theo AI Omnibus, tức Quy định (EU) 2026/1744. Cũng Omnibus này lùi nghĩa vụ cho hệ thống rủi ro cao thuộc Phụ lục III sang 2/12/2027. Các nghĩa vụ đó gồm quản lý rủi ro với kiểm thử theo chỉ số định trước (Điều 9), tự động ghi log sự kiện (Điều 12), và công bố độ chính xác, độ bền vững, an ninh mạng (Điều 15).
- HIPAA. Security Rule không nhắc tới model. Nhưng nó yêu cầu phân tích rủi ro và kiểm soát audit cho mọi hệ thống chạm vào ePHI, và một pipeline LLM là hệ thống như vậy. Câu hỏi kiểm thử được là: PHI có ở yên trong phạm vi đã có thỏa thuận BAA không. Xem quy định HIPAA 2026 và AI.
- PCI DSS v4.0.1. Mọi thành phần lưu trữ, xử lý hoặc truyền dữ liệu chủ thẻ, hoặc có thể ảnh hưởng tới an ninh của dữ liệu đó, đều thuộc phạm vi. Prompt, trace và bộ dữ liệu eval cũng tính. Câu hỏi kiểm thử được là: số thẻ (PAN) có bao giờ lọt vào model, log của model hay kho dữ liệu eval không. Chi tiết trong checklist PCI DSS và SOC 2 cho MVP fintech.
- Quản lý rủi ro mô hình ngân hàng Mỹ. Ngày 17/4/2026, Fed, OCC và FDIC thay SR 11-7 bằng hướng dẫn quản lý rủi ro mô hình sửa đổi (SR 26-2). Hướng dẫn mới áp dụng cho mô hình truyền thống và AI không tạo sinh, nhưng nói rõ AI tạo sinh và AI agent nằm ngoài phạm vi. Đồng thời, nó yêu cầu ngân hàng dùng thực hành quản trị rủi ro của mình để quyết định biện pháp kiểm soát cho các hệ thống đó. Trên thực tế, đội quản lý rủi ro mô hình của ngân hàng vẫn sẽ hỏi bằng chứng thẩm định. Chỉ là bằng chứng đó không đến từ một checklist viết cho mô hình chấm điểm tín dụng.
- Chương trình chống rửa tiền. Đề xuất quy định của FinCEN tháng 4/2026 sẽ đánh giá chương trình AML/CFT theo hiệu quả. Đề xuất liệt kê "sử dụng hiệu quả trí tuệ nhân tạo" trong các hoạt động có thể tạo ra kết quả chứng minh được hiệu quả. Đây vẫn là đề xuất (hạn góp ý đã đóng ngày 9/6/2026), nhưng nó cho thấy giám sát bằng AI sẽ được kỳ vọng đi kèm số liệu.
- NIST AI RMF. Khung này tự nguyện, nhưng chức năng MEASURE và Hồ sơ AI tạo sinh (NIST AI 600-1) cho bạn một bộ thuật ngữ mà auditor nhận ra ngay khi nói về kiểm thử, đánh giá, xác minh và thẩm định.
Bài test nào gắn với quy định nào?
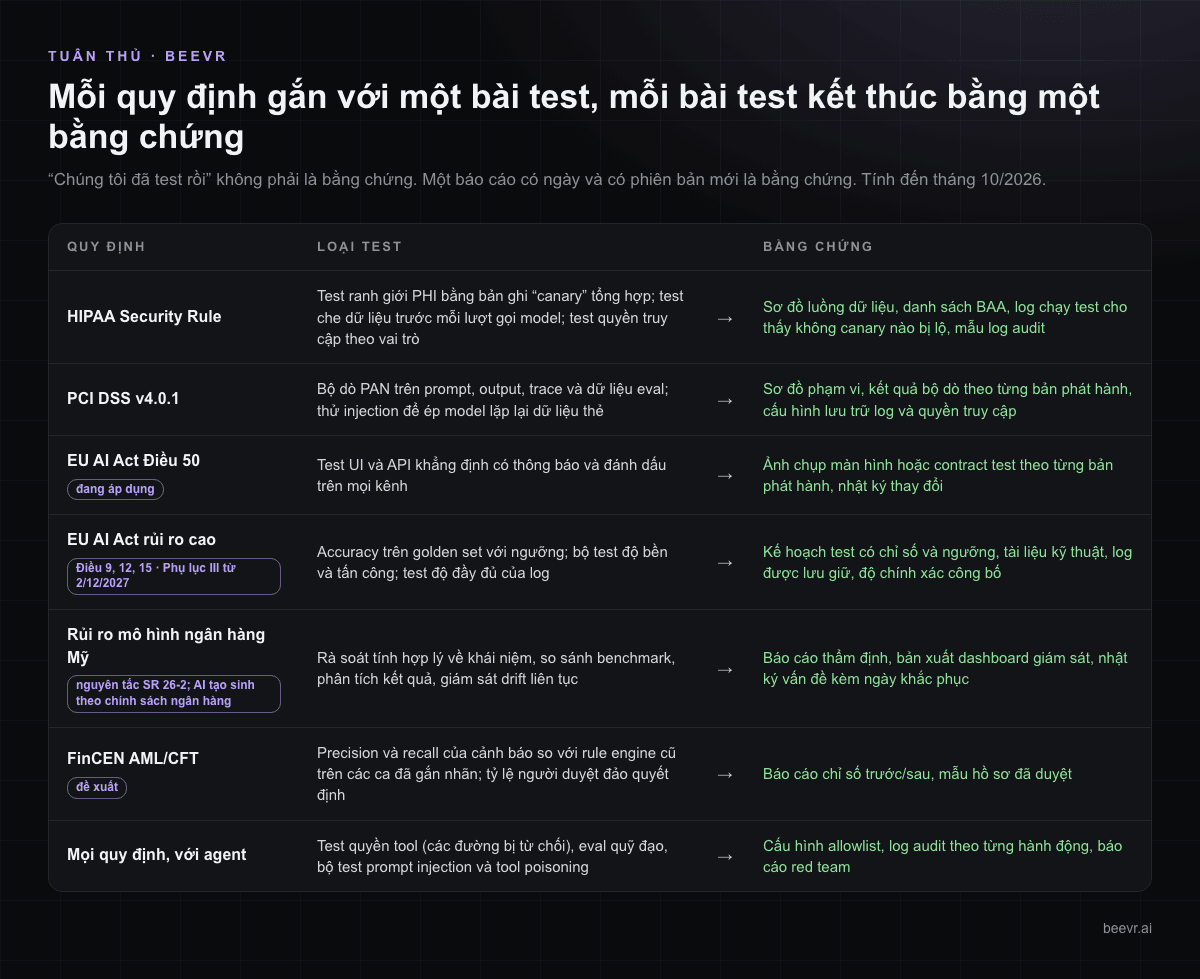
Hãy bắt đầu mỗi dự án AI trong ngành tuân thủ từ một ma trận như dưới đây. Mỗi dòng kết thúc bằng một bằng chứng, vì câu "chúng tôi đã test rồi" không phải là bằng chứng. Một báo cáo có ngày và có phiên bản mới là bằng chứng.
| Quy định | Người đánh giá hỏi gì | Loại test | Bằng chứng |
|---|---|---|---|
| HIPAA Security Rule | PHI có thể rời phạm vi được bảo vệ không? Ai đã truy cập gì? | Test ranh giới PHI bằng bản ghi "canary" tổng hợp; test che dữ liệu trước mỗi lượt gọi model; test quyền truy cập theo vai trò | Sơ đồ luồng dữ liệu, danh sách BAA, log chạy test cho thấy không canary nào bị lộ, mẫu log audit |
| PCI DSS v4.0.1 | Dữ liệu thẻ có nằm ngoài phạm vi của model không? | Bộ dò PAN trên prompt, output, trace và dữ liệu eval; thử injection để ép model lặp lại dữ liệu thẻ | Sơ đồ phạm vi, kết quả bộ dò theo từng bản phát hành, cấu hình lưu trữ log và quyền truy cập |
| EU AI Act Điều 50 (đang áp dụng) | Người dùng có được báo đang nói chuyện với AI không? Nội dung tạo sinh có được đánh dấu không? | Test UI và API khẳng định có thông báo và đánh dấu trên mọi kênh | Ảnh chụp màn hình hoặc contract test theo từng bản phát hành, nhật ký thay đổi |
| EU AI Act rủi ro cao (Điều 9, 12, 15; Phụ lục III từ 2/12/2027) | Đã test theo chỉ số định trước chưa? Sự kiện có được ghi log không? Độ chính xác đã công bố chưa? | Accuracy trên golden set với ngưỡng; bộ test độ bền và tấn công; test độ đầy đủ của log | Kế hoạch test có chỉ số và ngưỡng, tài liệu kỹ thuật, log được lưu giữ, độ chính xác công bố trong hướng dẫn sử dụng |
| Rủi ro mô hình ngân hàng Mỹ (nguyên tắc SR 26-2; AI tạo sinh theo chính sách của ngân hàng) | Mô hình có phù hợp mục đích, được phản biện độc lập và giám sát liên tục không? | Rà soát tính hợp lý về khái niệm, so sánh benchmark, phân tích kết quả, giám sát drift liên tục | Báo cáo thẩm định, bản xuất dashboard giám sát, nhật ký vấn đề kèm ngày khắc phục |
| FinCEN AML/CFT (đề xuất) | AI có làm chương trình hiệu quả hơn không? | Precision và recall của cảnh báo so với rule engine cũ trên các ca đã gắn nhãn; tỷ lệ người duyệt đảo quyết định | Báo cáo chỉ số trước/sau, mẫu hồ sơ đã duyệt |
| Mọi quy định, với agent | Agent có thể làm gì, và nó đã làm gì? | Test quyền tool (các đường bị từ chối), eval quỹ đạo (trajectory), bộ test prompt injection và tool poisoning | Cấu hình allowlist, log audit theo từng hành động, báo cáo red team |
Một kế hoạch eval LLM sẵn sàng cho audit gồm những gì?
Bảy thứ, lưu trong version control cạnh code. Thứ nào chỉ nằm trong notebook của một người thì đến ngày audit sẽ thiếu.
- Phạm vi và tuyên bố rủi ro. Hệ thống quyết định hoặc soạn thảo gì, ảnh hưởng tới ai, thất bại tệ nhất có thể xảy ra, và quy định nào áp dụng.
- Golden dataset. Các ca đại diện do chuyên gia nghiệp vụ gắn nhãn (bác sĩ, chuyên viên tuân thủ, thẩm định viên), chỉ dùng dữ liệu tổng hợp hoặc đã khử định danh. Có phiên bản, và ghi rõ ai gắn nhãn phần nào.
- Chỉ số với ngưỡng đặt trước. Độ chính xác trên các trường quan trọng, tỷ lệ khẳng định không có căn cứ, độ đúng khi từ chối, số lần lộ PHI/PAN (mục tiêu bằng 0), chi phí và độ trễ. Ngưỡng được thống nhất trước khi chạy test, không phải sau.
- Bộ test tấn công. Prompt injection, jailbreak, thử rút dữ liệu, và với agent là mô tả tool cùng output tool bị đầu độc.
- Cổng phát hành. Bộ test nào phải qua thì thay đổi model, prompt, retrieval hay tool mới được ship, và ai được phép bỏ qua một cổng thất bại (vai trò cụ thể, lý do được ghi lại).
- Giám sát production. Tỷ lệ lấy mẫu, bộ chấm online, hàng đợi người duyệt, và các ngưỡng kích hoạt báo động.
- Vòng phản hồi. Mỗi lỗi ở production trở thành một ca test mới, để cùng một lỗi không thể ship lần thứ hai.
Pipeline eval từ test offline đến production trông như thế nào?
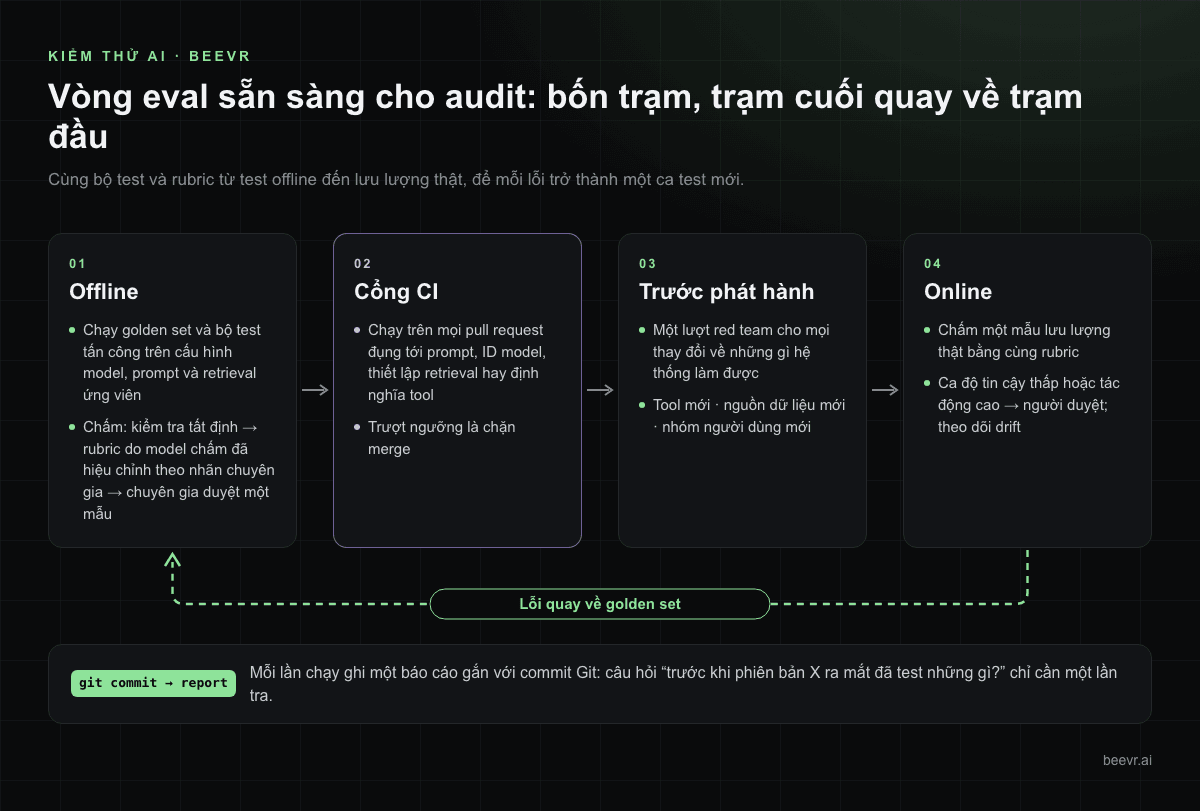
Hãy hình dung một vòng lặp gồm bốn trạm, trạm cuối quay về trạm đầu:
- Offline. Chạy golden set và bộ test tấn công trên cấu hình model, prompt và retrieval ứng viên. Chấm bằng kiểm tra tất định trước (schema, có trích dẫn, bộ dò PHI và PAN), rồi rubric do model chấm đã hiệu chỉnh theo nhãn chuyên gia, rồi chuyên gia duyệt một mẫu.
- Cổng CI. Các bộ test đó chạy trên mọi pull request đụng tới prompt, ID model, thiết lập retrieval hay định nghĩa tool. Trượt ngưỡng là chặn merge.
- Trước phát hành. Một lượt red team cho mọi thay đổi về những gì hệ thống làm được, như tool mới, nguồn dữ liệu mới hay nhóm người dùng mới.
- Online. Chấm một mẫu lưu lượng thật bằng cùng rubric, chuyển các ca độ tin cậy thấp hoặc tác động cao sang người duyệt, và theo dõi drift. Lỗi quay về golden set.
Một file kế hoạch tối giản, không phụ thuộc công cụ, trông như sau:
suite: claims-summary-v3
owner: compliance-eng
regimes: [hipaa, eu-ai-act-art50]
dataset: datasets/claims-golden@2026-10-01   # dữ liệu tổng hợp, chuyên gia gắn nhãn
gates:
  - metric: critical_field_accuracy
    threshold: ">= 0.97"
  - metric: unsupported_claim_rate
    threshold: "<= 0.01"
  - metric: phi_canary_leaks
    threshold: "== 0"
  - metric: ai_disclosure_present
    threshold: "== 1.0"
adversarial: [prompt_injection_v5, exfiltration_v2, tool_poisoning_v1]
online:
  sample_rate: 0.05
  human_review: "confidence < 0.8 or action in [deny, escalate]"
evidence_out: reports/{suite}/{git_sha}.json
Mỗi lần chạy ghi một báo cáo gắn với commit Git, nên câu hỏi "trước khi phiên bản X ra mắt đã test những gì?" trả lời được chỉ bằng một lần tra.
Làm sao kiểm thử lượt gọi tool của agent, không chỉ câu trả lời?
Với agent, phần rủi ro là hành động, nên phải test cả con đường agent đã đi chứ không chỉ văn bản cuối. Ba loại test quan trọng:
- Test quyền. Với mỗi tool, khẳng định những gì phải bị từ chối: sai vai trò, ID của tenant khác, phương thức ghi trên scope chỉ đọc, input quá cỡ. Các test này tất định và nên nằm trong CI.
- Eval quỹ đạo. So chuỗi lượt gọi tool với các đường đi mong đợi. Agent có tra chính sách trước khi soạn thư từ chối không? Có xin phê duyệt trước khi gửi không?
- Test injection và tool poisoning. Cài chỉ dẫn vào tài liệu được truy xuất và output của tool, rồi khẳng định agent phớt lờ chúng. Các benchmark đã công bố cho thấy vì sao điều này quan trọng: trong MCPTox, mô tả tool bị đầu độc thành công trung bình 36,5%.
Các test này chỉ thành bằng chứng khi runtime ghi lại mọi hành động. Trong Kite, framework agent mã nguồn mở của chúng tôi, model chỉ đề xuất hành động. Một kernel kiểm tra từng hành động theo allowlist tool, ngân sách và chính sách, rồi thực thi hoặc từ chối và ghi log, và tính năng tracing có thể ghi mọi sự kiện ra file JSON. Ở phía server, MCP server EcoCheck mà chúng tôi vận hành ghi một dòng audit cho mỗi request của agent (chủ thể, phương thức, đường dẫn, được phép hay bị từ chối). Thiết kế này có trong hướng dẫn phát triển MCP server. Những log như vậy biến một phát hiện red team thành một bài test tái lập được.
Auditor thực sự muốn xem bằng chứng gì?
Một bộ hồ sơ bằng chứng, không phải tài khoản đăng nhập dashboard. Hãy chuẩn bị sẵn trước khi ai đó hỏi:
- Kế hoạch eval và ma trận quy định–bài test, có người phụ trách và ngày tháng.
- Thẻ mô tả dữ liệu: nguồn, cách khử định danh, người gắn nhãn, lịch sử phiên bản.
- Báo cáo phát hành của N phiên bản gần nhất: đã chạy gì, ngưỡng, kết quả, các lần bỏ qua cổng và ai phê duyệt.
- Danh mục model và nhà cung cấp: ID và phiên bản model, vùng lưu trữ, điều khoản xử lý dữ liệu (BAA hoặc DPA), thiết lập lưu giữ.
- Giám sát production: các mẫu đã duyệt, biểu đồ drift, sự cố và ca test mà mỗi sự cố sinh ra.
- Hồ sơ giám sát của con người: ai duyệt gì, ở ngưỡng nào, và việc đảo quyết định được ghi lại ra sao. Bài AI có người giám sát cho ngành tuân thủ bàn về chỗ đặt con người.
- Log truy cập và hành động của agent, với thời gian lưu giữ đúng theo quy định áp dụng.
Kiến trúc riêng cho y tế (che PHI, chuỗi BAA, log chống sửa) có trong bài AI agent tuân thủ HIPAA.
Những sai lầm nào khiến eval LLM trượt audit?
Thất bại thường gặp không phải điểm thấp. Đó là thiếu hồ sơ. Những kiểu sau cần tránh:
- Đặt ngưỡng sau khi chạy. Nếu bạn chọn mức đạt sau khi đã thấy con số, đó không phải biện pháp kiểm soát.
- Dữ liệu bệnh nhân hoặc thẻ thật trong bộ eval. Việc này kéo công cụ test của bạn vào phạm vi HIPAA hoặc PCI. Hãy dùng dữ liệu tổng hợp hoặc đã khử định danh đúng cách.
- Dùng LLM làm giám khảo mà không hiệu chỉnh. Model chấm điểm dùng được nếu bạn đã đo độ đồng thuận của nó với nhãn chuyên gia. Không có số đó, nó chỉ là một ý kiến.
- Nâng cấp model âm thầm. Một alias của nhà cung cấp chuyển sang phiên bản model mới cũng là một thay đổi. Hãy ghim phiên bản và chạy cổng kiểm tra.
- Có trace nhưng không có quy tắc lưu giữ. Log đầy prompt bản thân đã là dữ liệu nhạy cảm. Hãy quyết định thời gian lưu, quyền truy cập và việc che dữ liệu ngay từ đầu.
Câu hỏi thường gặp
Kiểm thử LLM để tuân thủ HIPAA như thế nào?
Bạn kiểm thử cả hệ thống, không chỉ model. Gieo các bản ghi PHI "canary" tổng hợp và khẳng định chúng không bao giờ tới endpoint nào chưa có BAA. Test việc che dữ liệu trước mỗi lượt gọi model, kiểm tra quyền truy cập theo vai trò, và giữ log audit ai đã xem gì. Lưu kết quả test theo từng bản phát hành làm bằng chứng cho phân tích rủi ro.
EU AI Act có bắt buộc kiểm thử LLM không?
Với hệ thống rủi ro cao thì có. Từ 2/12/2027 (Phụ lục III), nhà cung cấp phải kiểm thử theo chỉ số định trước, tự động ghi log sự kiện và công bố độ chính xác. Với mọi hệ thống AI giao tiếp với con người, nghĩa vụ minh bạch ở Điều 50 đã áp dụng, và bạn nên test để chắc chắn thông báo xuất hiện trên mọi kênh.
SR 11-7 còn áp dụng cho AI tạo sinh không?
Không. SR 11-7 đã được thay bằng hướng dẫn liên cơ quan về quản lý rủi ro mô hình sửa đổi (SR 26-2) ngày 17/4/2026. Hướng dẫn mới nói rõ AI tạo sinh và AI agent nằm ngoài phạm vi, nhưng yêu cầu ngân hàng áp dụng thực hành quản trị rủi ro của mình cho các hệ thống đó. Dù vậy, hãy chuẩn bị sẵn bằng chứng theo kiểu thẩm định.
Eval offline và eval online khác nhau thế nào?
Eval offline chạy một bộ dữ liệu cố định đã gắn nhãn trước khi phát hành, để so các phiên bản trong cùng điều kiện. Eval online chấm một mẫu lưu lượng production thật sau khi phát hành, để bắt drift và các kiểu input mới. Ngành tuân thủ cần cả hai, cộng với người duyệt các ca mà bộ chấm đánh dấu.
Có dùng LLM để chấm LLM khác trong ngành tuân thủ được không?
Được, như một lớp, nếu bạn hiệu chỉnh nó. Đo độ đồng thuận của model chấm với nhãn chuyên gia trên một tập giữ riêng, ghi con số đó vào kế hoạch eval, và giữ kiểm tra tất định cùng việc chuyên gia lấy mẫu cho các trường quan trọng. Hiệu chỉnh lại mỗi khi model chấm thay đổi.
BeevR xây AI cho y tế, fintech và các lĩnh vực phải audit, với kế hoạch eval, log và điểm duyệt của con người được thiết kế từ sprint đầu tiên, giá cố định theo giai đoạn và bạn sở hữu toàn bộ code. Xem cách chúng tôi làm phát triển AI agent và AI agent tuân thủ HIPAA, hoặc kể cho chúng tôi auditor của bạn đang yêu cầu gì.