Dùng Safe Harbor khi bạn loại bỏ được cả 18 loại định danh và dữ liệu chủ yếu có cấu trúc. Dùng Expert Determination khi bài toán cần ghi chú tự do, ngày tháng hoặc địa lý. Với các lời gọi LLM thời gian thực dưới BAA, khử định danh không bắt buộc về pháp lý, nhưng token hóa định danh trước khi gửi model vẫn là cách rẻ nhất để giảm rủi ro.
Các đội xây sản phẩm với LLM gặp bài toán khử định danh từ hai phía. Một số muốn gửi văn bản lâm sàng cho model hoặc công cụ không có BAA. Số khác muốn dựng bộ dữ liệu train, eval hay phân tích từ ghi chú. Cả hai cùng vấp một vấn đề: chuẩn khử định danh của HIPAA được viết cho bảng dữ liệu, còn văn bản lâm sàng thì không phải bảng. Bài này giải thích hai phương pháp hợp pháp, vì sao văn bản tự do làm hỏng các cách làm đơn giản, pipeline token hóa và tái định danh hoạt động thế nào, và các công cụ chính so với nhau ra sao. Đối chiếu nguồn gốc ngày 12/11/2026.
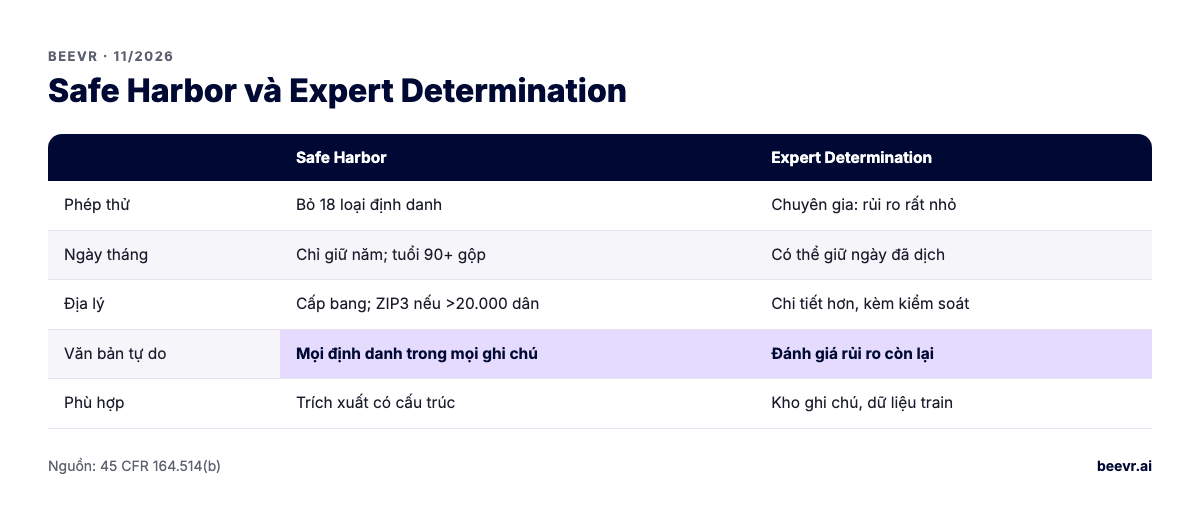
Safe Harbor và Expert Determination khác nhau thế nào?
Safe Harbor là một checklist: loại bỏ 18 loại định danh và không thực sự biết phần còn lại có thể nhận diện ai đó. Expert Determination là một phân tích rủi ro: một chuyên gia đủ năng lực ghi nhận bằng văn bản rằng rủi ro tái nhận diện là rất nhỏ, dùng phương pháp thống kê. Cả hai nằm trong 45 CFR 164.514(b).
| Safe Harbor | Expert Determination | |
|---|---|---|
| Phép thử | Bỏ 18 loại định danh; không thực sự biết có thể tái nhận diện | Chuyên gia kết luận rủi ro rất nhỏ, kể cả khi kết hợp dữ liệu khác có sẵn |
| Ngày tháng | Bỏ mọi thành phần ngày trừ năm; tuổi trên 89 gộp thành 90+ | Có thể giữ ngày đã dịch hoặc khái quát nếu rủi ro vẫn rất nhỏ |
| Địa lý | Không giữ gì dưới cấp bang, trừ 3 số đầu ZIP nếu vùng đó có trên 20.000 dân | Có thể giữ địa lý chi tiết hơn kèm kiểm soát |
| Văn bản tự do | Mọi định danh trong mọi ghi chú phải bị bỏ, kể cả "bất kỳ đặc điểm nhận dạng duy nhất nào khác" | Chuyên gia đánh giá rủi ro còn lại của kho văn bản và môi trường bên nhận |
| Hồ sơ | Quy trình và QA của bạn | Phương pháp và kết quả bằng văn bản của chuyên gia |
| Chi phí và thời gian | Thấp hơn; tự động hóa được kèm QA | Phí chuyên gia và vài tuần phân tích; làm lại khi dữ liệu hoặc mục đích đổi |
| Phù hợp | Trích xuất có cấu trúc, văn bản ngắn | Kho ghi chú lớn, dòng thời gian, dữ liệu train model |
18 định danh của Safe Harbor gồm: tên; địa lý dưới cấp bang; ngày (trừ năm) và tuổi trên 89; số điện thoại và fax; email; số an sinh xã hội; số hồ sơ bệnh án; số thành viên bảo hiểm; số tài khoản; số chứng chỉ và giấy phép; định danh phương tiện; định danh thiết bị; URL; địa chỉ IP; định danh sinh trắc; ảnh toàn mặt; và bất kỳ số, đặc điểm hay mã nhận dạng duy nhất nào khác. Chúng áp dụng cho bệnh nhân và cả người thân, chủ lao động, người cùng hộ.
Có cần khử định danh PHI trước khi gửi cho LLM không?
Không, nếu nhà cung cấp model là business associate của bạn theo BAA đã ký và bạn chỉ dùng dịch vụ được bao phủ. Bạn phải khử định danh, hoặc không gửi, khi đích đến không có BAA: endpoint model ngoài phạm vi, nền tảng eval, đơn vị gán nhãn, hay laptop của lập trình viên.
Kể cả có BAA, chuẩn minimum necessary trong 45 CFR 164.502(b) vẫn áp dụng. Một model tóm tắt xu hướng xét nghiệm không cần tên, địa chỉ hay MRN của bệnh nhân. Token hóa chúng trước lời gọi và khôi phục sau đó chỉ tốn vài mili giây, và loại bỏ phần lớn thiệt hại nếu prompt hay log bị lộ. Lưu ý văn bản đã token hóa không tự động được coi là đã khử định danh: nó chỉ được tính khi phần còn lại đạt Safe Harbor hoặc có Expert Determination. Hãy coi token hóa trước hết là một kiểm soát bảo mật.
Hãy kiểm cả quy định riêng của nhà cung cấp. Ví dụ hướng dẫn triển khai HIPAA tháng 7/2026 của OpenAI nói khách hàng không được dùng dịch vụ của họ để lưu PHI như một phần của designated record set. Điều đó quyết định nguồn dữ liệu gốc của bạn nằm ở đâu. Chúng tôi so sánh các nhà cung cấp trong bài nhà cung cấp LLM nào ký BAA năm 2026.
Vì sao văn bản tự do khó khử định danh đến vậy?
Vì định danh trong ghi chú là không giới hạn và phụ thuộc ngữ cảnh. Một ghi chú có thể nhắc tên người thân, chủ lao động, một thị trấn nhỏ, một nghề hiếm hay một sự kiện trên báo, và nhóm thứ mười tám của Safe Harbor bao gồm "bất kỳ đặc điểm nhận dạng duy nhất nào khác". Bộ phát hiện tự động bỏ sót một số, và vài lần bỏ sót trên hàng triệu ghi chú là rủi ro rất lớn.
Bán định danh cộng dồn
Kết quả kinh điển là phát hiện của Latanya Sweeney rằng 87% dân số Mỹ có khả năng bị nhận diện duy nhất chỉ từ ZIP 5 số, giới tính và ngày sinh đầy đủ. Ghi chú đầy những tổ hợp như vậy: "nam 62 tuổi, lính cứu hỏa đã nghỉ hưu ở [thị trấn], đã ghép phổi". Không token nào là định danh trực tiếp, nhưng gộp lại thì có thể.
Bộ phát hiện mang tính xác suất
Công cụ nào cũng nói vậy. Tài liệu DetectPHI của AWS Comprehend Medical ghi rằng các thực thể của họ không khớp 1:1 với danh sách Safe Harbor và khuyến nghị có người rà hoặc kiểm tra khác cho mục đích tuân thủ. Presidio nói thẳng không có gì đảm bảo nó tìm được mọi thông tin nhạy cảm. Hãy lên kế hoạch cho việc bỏ sót.
"Thực sự biết" có hiệu lực theo ngữ cảnh
Safe Harbor thất bại nếu bạn thực sự biết dữ liệu còn lại có thể nhận diện ai đó. Một ca bệnh từng lên báo, một bệnh nhân nổi tiếng, hay một thủ thuật độc nhất ở một bệnh viện nhỏ có thể không đạt kể cả khi đã bỏ đủ 18 nhóm.
LLM làm việc tái nhận diện dễ hơn
Một model mạnh có thể nối các manh mối rải rác trong hồ sơ dài nhanh hơn con người. Đó là lý do nên thận trọng hơn với văn bản tự do sẽ được chia sẻ, và là lý do các phân tích Expert Determination ngày càng tính tới những gì bên nhận có thể làm với model hiện đại.
Pipeline token hóa và tái định danh cho LLM hoạt động thế nào?
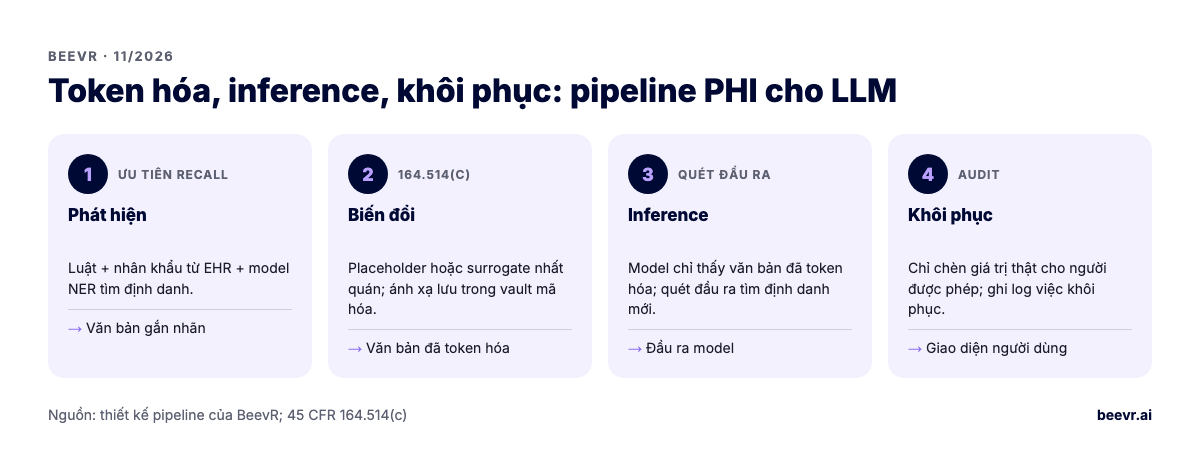
Phát hiện định danh, thay mỗi cái bằng placeholder nhất quán hoặc giá trị thay thế thực tế, giữ bảng ánh xạ trong một vault bảo mật riêng, chỉ gửi văn bản đã biến đổi cho model, rồi khôi phục định danh ở đầu ra cho người dùng được phép. Khóa ánh xạ không bao giờ được tới model hay log.
- Phát hiện. Chạy luật có cấu trúc (định dạng MRN, regex số điện thoại, nhân khẩu học đã biết của bệnh nhân từ EHR) cộng một model NER. Dùng nhân khẩu học đã biết của chính bệnh nhân trong ngữ cảnh bắt được nhiều hơn hẳn NER chung chung.
- Biến đổi. Thay bằng placeholder có kiểu ("[PATIENT_1]", "[DATE_3]") hoặc giá trị thay thế. Giá trị thay thế đọc tự nhiên và che được chỗ bỏ sót tốt hơn; tài liệu dịch vụ khử định danh của Microsoft khuyến nghị surrogate vì lý do đó. Giữ thay thế nhất quán trong một tài liệu để model theo được ai là ai.
- Vault. Lưu bảng ánh xạ có mã hóa, theo từng request hoặc từng bộ dữ liệu, với vòng đời ngắn cho inference. Theo 164.514(c), mã tái định danh không được sinh ra từ thông tin của cá nhân, và cơ chế không được tiết lộ hay dùng cho mục đích khác.
- Inference. Model chỉ thấy văn bản đã biến đổi. Yêu cầu nó giữ nguyên placeholder, và kiểm tra đầu ra không chứa định danh mới.
- Khôi phục. Chỉ chèn lại giá trị thật trong giao diện của người dùng được phép. Ghi log sự kiện khôi phục.
Hai cái bẫy. Dịch ngày (date shifting) giữ được khoảng cách thời gian nhưng không phải Safe Harbor, vì ngày trừ năm phải bị bỏ; nó có thể dùng được dưới Expert Determination. Và đầu ra cũng có thể rò: nếu model diễn đạt lại thành "con gái của [PATIENT_1], y tá ở bệnh viện quận", bước khôi phục không được là lớp kiểm tra duy nhất. Hãy quét cả đầu ra lẫn đầu vào. Các kiểm soát xung quanh có trong bài kiến trúc AI agent tuân thủ HIPAA.
Nên so sánh những công cụ khử định danh nào?
Lọc danh sách theo nơi dữ liệu của bạn nằm. Presidio nếu muốn mã nguồn mở chạy ở đâu cũng được và tùy biến được. AWS Comprehend Medical hoặc Azure Health Data Services nếu hệ thống của bạn ở cloud đó và muốn dịch vụ được quản lý, đủ điều kiện HIPAA. Test tất cả trên chính ghi chú của bạn; độ chính xác đã công bố không chuyển được giữa các văn phong ghi chú.
| Công cụ | Loại | Chức năng | Ghi chú |
|---|---|---|---|
| Presidio | Mã nguồn mở; ban đầu của Microsoft, nay do cộng đồng Data Privacy Stack duy trì | Phát hiện (analyzer), ẩn danh, che ảnh, dữ liệu có cấu trúc | Tùy biến recognizer hoàn toàn; bạn tự host; nói rõ không đảm bảo tìm hết |
| AWS Comprehend Medical (DetectPHI) | API được quản lý | Phát hiện thực thể PHI kèm điểm tin cậy | Chỉ phát hiện; bạn tự xây bước thay thế; thực thể không khớp 1:1 với Safe Harbor |
| Azure Health Data Services de-identification | API được quản lý | Tag, redact, surrogate; 27 loại thực thể gồm 18 định danh HIPAA | Surrogate nhất quán trong một batch job; giới hạn 50 KB mỗi request; tính phí theo MB |
| LLM đa dụng làm bộ phát hiện | Model dùng prompt | Phát hiện hoặc viết lại | Giỏi ngữ cảnh, recall khó đoán; cần cùng quy trình eval và BAA nếu thấy PHI |
Chi tiết lấy từ tổng quan dịch vụ khử định danh của Microsoft cùng các trang AWS và Presidio ở trên. Trong thực tế, pipeline mạnh nhất kết hợp một lớp xác định dựa trên nhân khẩu học đã biết của bệnh nhân, một model NER được quản lý hoặc mã nguồn mở, và một lần quét cuối ở đầu ra.
Làm sao đo được khử định danh đã đủ tốt?
Đo recall theo từng loại định danh trên một mẫu ghi chú đã gán nhãn của chính bạn, vì bỏ sót một cái tên nghiêm trọng hơn che nhầm một tên thuốc. Báo số lần bỏ sót trên 1.000 ghi chú, rà tay từng lần, và lặp lại mỗi khi mẫu ghi chú, nguồn hay công cụ thay đổi.
- Bộ chuẩn. Hai người gán nhãn đánh dấu mọi định danh trong vài trăm ghi chú lấy từ từng hệ thống nguồn và loại ghi chú.
- Ưu tiên recall. Theo dõi recall riêng cho tên, ngày, địa điểm, mã số và "khác". Precision ít quan trọng hơn với quyền riêng tư nhưng ảnh hưởng tính hữu dụng.
- Kiểm rò rỉ. Xem cái gì bị bỏ sót. Sót tên đường trong phần tiền sử xã hội khác với sót MRN.
- Hữu dụng về sau. Kiểm văn bản đã khử định danh vẫn dùng được cho việc cần làm, như chất lượng tóm tắt hay độ chính xác trích xuất.
Đây cũng là thói quen đánh giá chúng tôi khuyên cho mọi model trong môi trường chịu quản lý; xem kiểm thử LLM cho ngành chịu quản lý.
Khi nào nên trả tiền cho Expert Determination?
Khi bạn sẽ chia sẻ hoặc lưu giữ bộ dữ liệu văn bản tự do lớn, cần ngày tháng hoặc địa lý chi tiết, định train hoặc fine-tune model trên văn bản lâm sàng, hoặc sẽ đưa dữ liệu ra ngoài tổ chức. Với inference tạm thời dưới BAA, token hóa cộng minimum necessary thường là đủ.
Mời chuyên gia sớm. Họ sẽ hỏi ai nhận dữ liệu, bên nhận có kiểm soát gì, bên nhận có thể nối với dữ liệu nào khác, và bạn giám sát ra sao. Câu trả lời thường làm thay đổi thiết kế pipeline, ví dụ giữ dữ liệu trong môi trường có kiểm soát thay vì gửi đi một file. Ghi lại kết luận, phạm vi và thời hạn của nó, và coi nguồn dữ liệu hay mục đích mới là lý do để xem lại.
BeevR làm việc này thế nào
Chúng tôi xây lớp khử định danh và token hóa như một phần của hệ thống AI y tế: lớp xác định lấy dữ liệu nhân khẩu từ EHR, bộ phát hiện được quản lý hoặc mã nguồn mở, surrogate nhất quán, vault mã hóa vòng đời ngắn, quét đầu ra, và bộ eval chuẩn chạy trong CI để một thay đổi mẫu ghi chú không lặng lẽ làm giảm recall. Với bộ dữ liệu train hay phân tích, chúng tôi làm cùng chuyên gia khử định danh mà bạn chọn thay vì tự nhận đưa ra kết luận. Model có thể chạy trong chính tài khoản AWS của bạn dưới BAA với AWS, và BeevR ký BAA với vai trò business associate.
Chúng tôi là đội senior do founder dẫn dắt tại Hà Nội, 5.0 trên Clutch, và đã xây một EHR multi-tenant đang chạy tại bốn phòng khám ở Mỹ với khoảng 300 bệnh nhân mỗi ngày. Chúng tôi làm theo giai đoạn cố định, từ $10K mỗi giai đoạn, và bạn sở hữu code từ ngày đầu. Xem phát triển AI agent cho y tế và cách chúng tôi làm bảo mật.
Nếu bạn đang quyết định pipeline LLM nên thấy bao nhiêu PHI, đặt một cuộc gọi 30 phút. Mang theo một mẫu định dạng ghi chú và bài toán của bạn, chúng tôi sẽ phác pipeline và chỉ ra điểm yếu của nó.