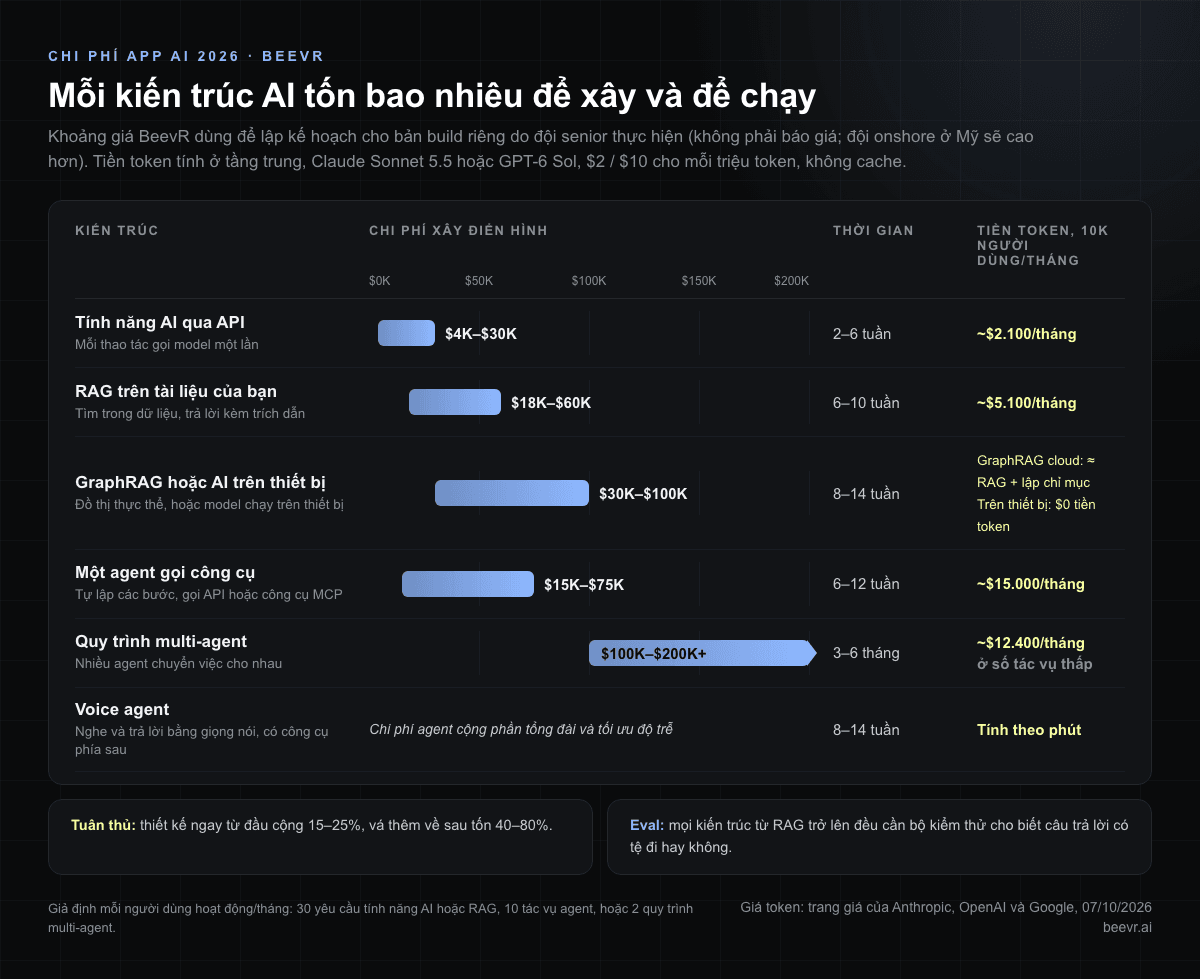
Xây một ứng dụng AI năm 2026 tốn khoảng $4.000–$30.000 khi AI chỉ là một tính năng gọi API model, $18.000–$60.000 cho hệ RAG trả lời trên tài liệu của chính bạn, $15.000–$75.000 cho một agent biết gọi công cụ, và từ $100.000 trở lên cho nền tảng multi-agent. Khoản chênh lớn hơn nằm ở hóa đơn hằng tháng: theo bảng giá niêm yết tháng 10/2026, cùng 1.000 yêu cầu của người dùng có thể tốn $0,35 trên model rẻ nhất của các hãng lớn, hoặc $1.240 ở cấu hình đắt nhất trong bài. Kiến trúc, chứ không phải model, quyết định bạn rơi vào đầu nào của khoảng đó.
Bài này đưa ra chi phí xây và chi phí chạy theo từng kiến trúc, dùng giá token lấy từ trang giá chính thức của Anthropic, OpenAI và Google ngày 07/10/2026. Nếu bạn cần giá gói MVP, xem trang chi phí MVP giá cố định. Riêng về agent, đọc chi phí xây dựng AI agent. Về hóa đơn vận hành dài hạn, xem chi phí vận hành AI vượt chi phí xây.
Xây một ứng dụng AI năm 2026 tốn bao nhiêu?
Chủ yếu phụ thuộc vào việc bạn cần kiến trúc nào trong sáu loại dưới đây. Đây là khoảng giá BeevR dùng để lập kế hoạch cho một bản build riêng do đội senior thực hiện. Đây không phải báo giá, và đội onshore ở Mỹ sẽ cao hơn. Cột chi phí chạy dùng tầng model giá trung bình (Claude Sonnet 5.5 hoặc GPT-6 Sol, cùng $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra), không dùng cache, theo mức sử dụng nêu ở phần sau.
| Kiến trúc | Là gì | Chi phí xây điển hình | Thời gian điển hình | Tiền token với 10.000 người dùng/tháng (tầng trung, không cache) |
|---|---|---|---|---|
| Tính năng AI qua API | Mỗi thao tác gọi model một lần: tóm tắt, phân loại, trích xuất, soạn nháp | $4K–$30K | 2–6 tuần | ~$2.100/tháng |
| RAG trên tài liệu của bạn | Tìm trong dữ liệu của bạn rồi trả lời kèm trích dẫn | $18K–$60K | 6–10 tuần | ~$5.100/tháng |
| GraphRAG hoặc AI trên thiết bị | Đồ thị thực thể trên dữ liệu, hoặc model chạy ngay trong trình duyệt/thiết bị người dùng | $30K–$100K | 8–14 tuần | GraphRAG trên cloud: gần như RAG cộng chi phí lập chỉ mục; trên thiết bị: $0 tiền token |
| Một agent gọi công cụ | Model tự lập các bước và gọi API hoặc công cụ MCP của bạn | $15K–$75K | 6–12 tuần | ~$15.000/tháng |
| Quy trình multi-agent | Nhiều agent chuyển việc cho nhau trong một quy trình dài | $100K–$200K+ | 3–6 tháng | ~$12.400/tháng ở số tác vụ thấp |
| Voice agent | Nghe giọng nói, trả lời bằng giọng nói, thường có công cụ phía sau | Chi phí agent cộng phần tổng đài và tối ưu độ trễ | 8–14 tuần | Tính theo phút (xem phần Câu hỏi thường gặp) |
Có hai quy luật đúng cho cả bảng. Thứ nhất, dữ liệu thuộc ngành bị quản lý làm thay đổi chi phí xây nhiều hơn chính kiến trúc. Trang chi phí MVP của chúng tôi ghi rõ: thiết kế tuân thủ ngay từ đầu cộng thêm 15–25%, còn vá thêm về sau tốn 40–80%. Thứ hai, mọi kiến trúc từ dòng thứ hai trở xuống đều cần eval: một bộ kiểm thử cho biết câu trả lời có tệ đi sau khi bạn đổi model hay đổi prompt hay không. Đội nào bỏ qua eval sẽ trả giá về sau, và đó là một trong những lý do vì sao dự án AI agent thất bại.
Giá token của các model AI chính tháng 10/2026 là bao nhiêu?
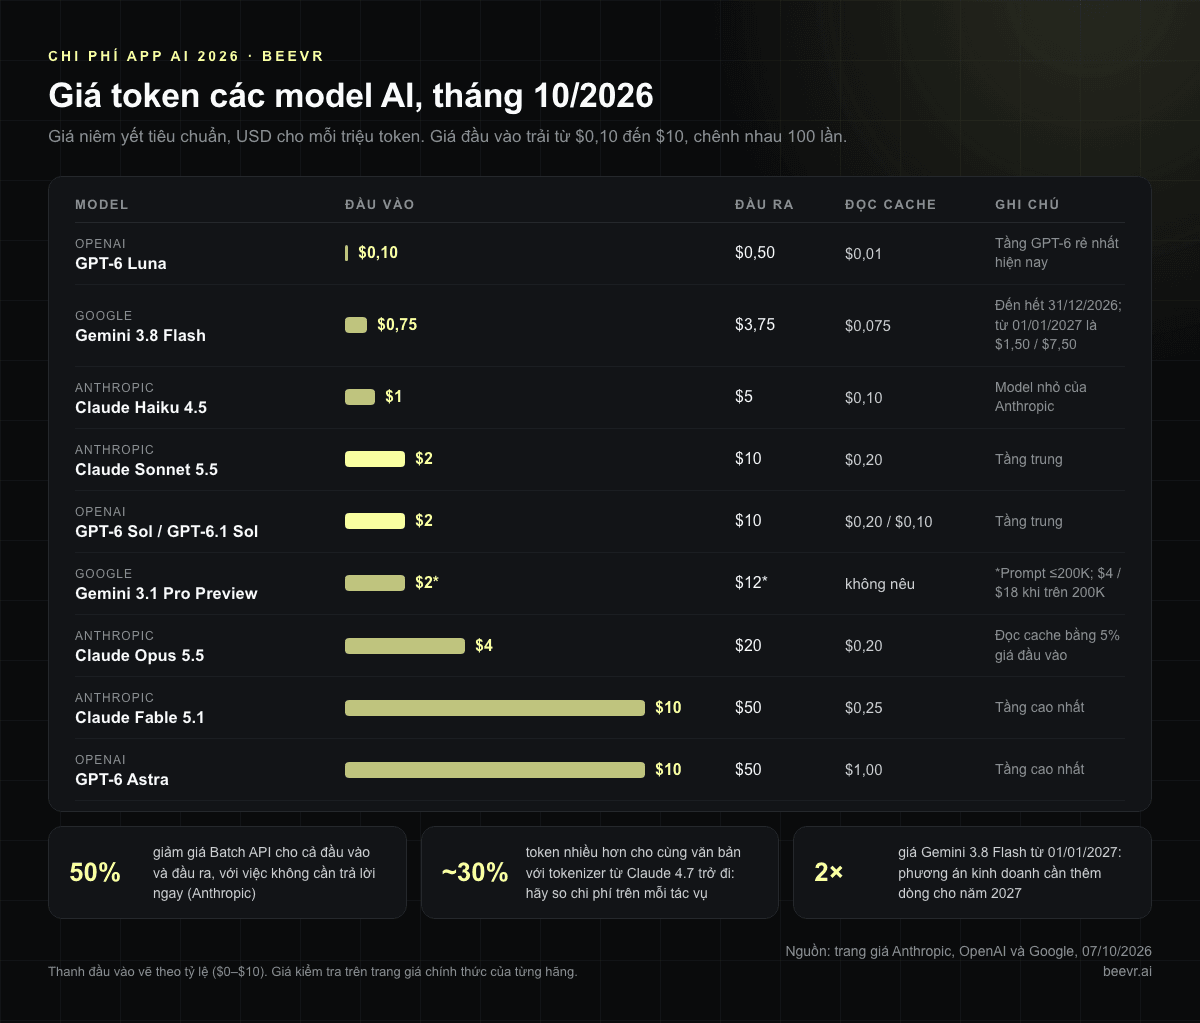
Giá model hàng đầu hiện trải từ $0,10 đến $10 cho mỗi triệu token đầu vào, chênh nhau 100 lần. Đây là giá niêm yết tiêu chuẩn cho mỗi triệu token, kiểm tra trên trang giá chính thức của từng hãng ngày 07/10/2026:
| Model | Đầu vào | Đầu ra | Đầu vào đã cache / đọc cache | Ghi chú |
|---|---|---|---|---|
| OpenAI GPT-6 Luna | $0,10 | $0,50 | $0,01 | Tầng GPT-6 rẻ nhất hiện nay |
| Google Gemini 3.8 Flash | $0,75 | $3,75 | $0,075 | Giá này đến hết 31/12/2026; từ 01/01/2027 là $1,50 / $7,50 |
| Anthropic Claude Haiku 4.5 | $1 | $5 | $0,10 | Model nhỏ của Anthropic |
| Anthropic Claude Sonnet 5.5 | $2 | $10 | $0,20 | Tầng trung |
| OpenAI GPT-6 Sol / GPT-6.1 Sol | $2 | $10 | $0,20 / $0,10 | Tầng trung |
| Google Gemini 3.1 Pro Preview | $2 (prompt ≤200K) | $12 (prompt ≤200K) | không nêu ở đây | $4 / $18 khi prompt trên 200K token |
| Anthropic Claude Opus 5.5 | $4 | $20 | $0,20 | Đọc cache chỉ bằng 5% giá đầu vào |
| Anthropic Claude Fable 5.1 | $10 | $50 | $0,25 | Tầng cao nhất |
| OpenAI GPT-6 Astra | $10 | $50 | $1,00 | Tầng cao nhất |
Ba chi tiết làm thay đổi hóa đơn thực tế nhiều hơn con số trên bảng. Xử lý theo lô (batch) giảm một nửa giá cho những việc không cần trả lời ngay (Anthropic niêm yết giảm 50% cho cả đầu vào và đầu ra qua Batch API). Anthropic cũng ghi chú rằng Claude 4.7 trở đi dùng tokenizer mới, sinh ra nhiều hơn khoảng 30% token cho cùng một đoạn văn bản, nên hãy so chi phí trên mỗi tác vụ chứ đừng so giá trên mỗi token. Và Gemini 3.8 Flash tăng gấp đôi từ 01/01/2027, nên phương án kinh doanh dựa trên giá Flash hiện tại cần thêm một dòng cho năm 2027.
Chạy một ứng dụng AI tốn bao nhiêu cho mỗi 1.000 yêu cầu?
Từ dưới $1 đến hơn $1.000, tùy kiến trúc và model. Bảng dưới nhân giá niêm yết ở trên với số token điển hình cho mỗi yêu cầu: 1.500 token vào và 400 token ra cho một tính năng AI đơn giản, 6.000 và 500 cho một câu trả lời RAG, 60.000 và 3.000 cho một tác vụ agent (khoảng tám lần gọi model khi ngữ cảnh lớn dần), và 250.000 và 12.000 cho một quy trình multi-agent. Chưa áp dụng cache hay giảm giá batch.
| Mỗi 1.000 yêu cầu | GPT-6 Luna | Gemini 3.8 Flash (giá 2026) | Sonnet 5.5 / GPT-6 Sol | Opus 5.5 |
|---|---|---|---|---|
| Tính năng AI | $0,35 | $2,63 | $7,00 | $14,00 |
| Câu trả lời RAG | $0,85 | $6,38 | $17,00 | $34,00 |
| Tác vụ agent đơn | $7,50 | $56,25 | $150,00 | $300,00 |
| Quy trình multi-agent | $31,00 | $232,50 | $620,00 | $1.240,00 |
Số token của bạn sẽ khác, nên hãy thay bằng số đo từ log thật. Điều cần thấy là hình dạng của bảng: trên cùng một model, một tác vụ agent tốn gấp khoảng 20 lần một câu trả lời RAG, vì agent phải đọc lại ngữ cảnh ngày càng dài ở mỗi bước.
Mỗi kiến trúc tốn bao nhiêu với 1.000, 10.000 và 100.000 người dùng?
Tiền token hằng tháng tăng theo số người dùng, nên một lựa chọn thiết kế trông nhỏ ở 1.000 người dùng sẽ thành một khoản ngang quỹ lương ở 100.000. Giả định: mỗi người dùng hoạt động gửi 30 yêu cầu tính năng AI hoặc RAG mỗi tháng, hoặc 10 tác vụ agent, hoặc 2 quy trình multi-agent; tầng trung ($2 / $10); không cache.
| Tiền token hằng tháng | 1.000 người dùng | 10.000 người dùng | 100.000 người dùng |
|---|---|---|---|
| Tính năng AI (30 yêu cầu/người) | $210 | $2.100 | $21.000 |
| Chat RAG (30 câu trả lời/người) | $510 | $5.100 | $51.000 |
| Agent đơn (10 tác vụ/người) | $1.500 | $15.000 | $150.000 |
| Multi-agent (2 quy trình/người) | $1.240 | $12.400 | $124.000 |
Token chỉ là một phần chi phí vận hành. Hosting, lưu trữ vector, giám sát, chạy eval và người duyệt cộng thêm ở trên, và bài chi phí vận hành AI của chúng tôi phân tích các khoản đó.
Vì sao cùng một ứng dụng AI có thể đắt hoặc rẻ gấp 10 lần tùy thiết kế?
Năm đòn bẩy dưới đây thay đổi hóa đơn token nhiều hơn việc đổi nhà cung cấp:
- Định tuyến model. Gửi yêu cầu dễ (phân loại, trích xuất, trả lời ngắn) cho model $0,10–$1, chỉ gửi phần suy luận khó cho model $2–$4. Bảng mỗi 1.000 yêu cầu cho thấy chênh lệch 40 lần giữa Luna và Opus 5.5 trên cùng một tác vụ.
- Prompt caching. Nếu 4.000 trong 6.000 token đầu vào của một yêu cầu RAG là system prompt và chỉ dẫn cố định, cache chúng trên Sonnet 5.5 ($0,20 cho mỗi triệu token đọc cache) giảm chi phí từ $17,00 xuống khoảng $9,80 cho mỗi 1.000 câu trả lời. Với agent có 80% ngữ cảnh được cache, chi phí giảm từ $150 xuống khoảng $64. Ghi cache tốn thêm (bằng 1,25 lần giá đầu vào với cache 5 phút của Anthropic), nên cache chỉ có lợi khi một phần prompt được dùng lại nhiều lần, không có lợi cho prompt dùng một lần.
- Dùng batch cho mọi thứ không cần trả lời ngay. Xử lý tài liệu ban đêm, tạo báo cáo và chạy eval có thể chạy với nửa giá qua batch API, ví dụ của Anthropic.
- Kỷ luật ngữ cảnh. Agent đắt vì mỗi bước gửi lại toàn bộ lịch sử. Truy xuất ít hơn nhưng trúng hơn, tóm tắt các bước cũ và giới hạn số bước mỗi tác vụ. Giới hạn số bước còn là một biện pháp an toàn, không chỉ để tiết kiệm.
- Đưa việc ra khỏi cloud. Model nhỏ chạy trong trình duyệt của người dùng không có hóa đơn token. Dự án mã nguồn mở Nebula của chúng tôi chạy model chat và embedding đa ngôn ngữ ngay trong trình duyệt bằng WebGPU và WebAssembly, không dữ liệu nào rời khỏi thiết bị. Đổi lại là model nhỏ hơn và công xây nhiều hơn, nên AI trên thiết bị nằm ở khoảng chi phí xây cao hơn.
Điều gì quyết định chi phí xây một ứng dụng AI?
Gọi model là phần rẻ. Tiền nằm ở mọi thứ xung quanh nó:
- Chuẩn bị dữ liệu. Làm sạch, chia đoạn và phân quyền cho tài liệu mà hệ RAG đọc thường là đầu việc lớn nhất. PDF lộn xộn và biểu mẫu scan tốn hơn nhiều so với cơ sở dữ liệu sạch.
- Eval và guardrail. Bộ kiểm thử có nhãn, chấm điểm tự động, luồng từ chối và dự phòng, giới hạn những gì model được làm. Thiếu chúng, bạn không thể đổi model an toàn khi giá giảm.
- Tích hợp và công cụ. Mỗi hệ thống agent được gọi cần một API hoặc công cụ MCP, phân quyền hẹp, cơ chế thử lại không trừ tiền hai lần, và ghi log.
- Người duyệt. Với quyết định ảnh hưởng đến tiền, sức khỏe hoặc quyền lợi pháp lý, cần một người phê duyệt trước khi hành động được thực thi. Đó là cả một quy trình phải xây, không phải một ô đánh dấu. Xem AI có người giám sát trong ngành bị quản lý.
- Tuân thủ. HIPAA, PCI DSS hay quy định AI tại từng nước cộng thêm nhật ký kiểm toán, lựa chọn nơi lưu dữ liệu và hợp đồng với nhà cung cấp. Ví dụ, Luật Trí tuệ nhân tạo của Việt Nam yêu cầu nhà cung cấp tự phân loại hệ thống trước khi đưa vào sử dụng, và hệ thống rủi ro cao phải có cơ chế giám sát của con người cùng nhật ký hoạt động.
- Độ trễ. Tính năng giọng nói và thời gian thực cần streaming, xử lý ngắt lời và chọn model cẩn thận. Phản hồi dưới một giây tốn công kỹ thuật.
Làm sao ước tính chi phí ứng dụng AI trước khi xây?
Hãy đi qua checklist này trước khi xin báo giá. Studio nào đáng thuê cũng sẽ hỏi bạn đúng những câu này.
- Gọi tên kiến trúc. Tính năng, RAG, GraphRAG, trên thiết bị, agent đơn, multi-agent hay voice. Nếu chưa chọn được, hãy làm một bản demo để tìm ra.
- Đếm token mỗi yêu cầu. Ghi log vài chục yêu cầu thật trên bản prototype và đo token vào, token ra. Đừng đoán.
- Nhân với mức dùng thực tế. Số yêu cầu mỗi người dùng mỗi tháng × số người dùng hoạt động × giá, cho ít nhất hai tầng model.
- Tính luôn hóa đơn năm 2027. Ghi lại giá khuyến mãi sắp hết (Gemini 3.8 Flash tăng gấp đôi từ 01/01/2027) và model bạn phụ thuộc có thể bị ngừng.
- Lên kế hoạch định tuyến và cache từ ngày đầu. Quyết định yêu cầu nào đi model rẻ, phần prompt nào đủ ổn định để cache.
- Đưa eval thành một dòng ngân sách. Bộ kiểm thử, chấm điểm và chạy lại mỗi khi đổi model hoặc prompt.
- Quyết định dữ liệu được đi đâu. Vùng xử lý của nhà cung cấp (Anthropic tính 1,1 lần giá nếu chỉ suy luận tại Mỹ), phương án chạy trên thiết bị và các hợp đồng ngành của bạn yêu cầu.
- Đặt trần chi phí cho mỗi người dùng. Mức trần cứng cho mỗi tài khoản mỗi tháng bảo vệ bạn khỏi vòng lặp mất kiểm soát hoặc người dùng lạm dụng.
- Đòi giá cố định cho từng giai đoạn. Ước tính theo giờ cho một dự án AI không cho bạn mức trần nào.
$4K, $18K và $38K mua được gì trong một ứng dụng AI?
BeevR công khai ba gói giá cố định, và kiến trúc AI quyết định gói nào phù hợp. Theo trang giá của chúng tôi: Pitch Demo $4K (khoảng 10 ngày) gồm một luồng nghiệp vụ cốt lõi chạy trên hạ tầng thật. Investor MVP $18K (khoảng 6 tuần) gồm 3–5 luồng cốt lõi, có đăng nhập và phân quyền theo vai trò, được kiểm thử để vượt qua thẩm định của nhà đầu tư. Flagship Sprint $38K (khoảng 10 tuần) gồm 5–8 luồng, bộ kiểm thử đầy đủ, kiểm thử tải, triển khai và rollback tự động, cùng khả năng quan sát hệ thống đầy đủ.
Quy tắc kinh nghiệm: một tính năng AI hoặc một luồng RAG vừa với khuôn khổ Pitch Demo. Sản phẩm có lõi là RAG hoặc một agent, cộng phần ứng dụng xung quanh, vừa với Investor MVP. Multi-agent, voice, AI trên thiết bị và dữ liệu ngành bị quản lý thường cần Flagship Sprint hoặc kế hoạch chia giai đoạn. Mức phù hợp chính xác tùy phạm vi, nên hãy xem đây là điểm khởi đầu để trao đổi, không phải báo giá.
BeevR đã xây gì cho thấy những đánh đổi chi phí này?
Chúng tôi để công việc AI của mình có thể kiểm tra được, nên bạn tự xem được cách chúng tôi xử lý các đòn bẩy chi phí và an toàn ở trên:
- Kite, framework agent mã nguồn mở (MIT) của chúng tôi, coi LLM là thành phần không đáng tin. Một kernel kiểm tra mọi hành động model đề xuất, có kill switch và cơ chế thử lại idempotent, còn phần truy xuất là tìm kiếm lai BM25 cộng vector có rerank. Các dự án phát triển AI agent của chúng tôi xây trên nền này.
- Nebula (Apache-2.0) là GraphRAG chạy trên thiết bị: đồ thị thực thể và model chat chạy trong trình duyệt, không có hóa đơn token và không dữ liệu nào rời khỏi máy.
- Một MCP server đang chạy production. Chính beevr.ai cung cấp MCP server chỉ đọc, một A2A agent và JSON API công khai cho AI agent, liệt kê trong llms.txt.
- AI cho ngành bị quản lý. Che dữ liệu PHI, hạ tầng có BAA, nhật ký kiểm toán chống sửa đổi và người duyệt trong các dự án AI agent tuân thủ HIPAA.
- Sản phẩm đã giao. Một nền tảng AI đánh giá tương đương sinh học đọc PDF lâm sàng và dự đoán các chỉ số dược động học trên AWS theo chuẩn HIPAA, và một nền tảng kết nối B2B dùng AI. Xem thêm tại các câu chuyện dự án.
Câu hỏi thường gặp
Xây một chatbot AI đơn giản năm 2026 tốn bao nhiêu?
Chatbot trả lời từ tài liệu của chính bạn là một ứng dụng RAG: dự trù $18.000–$60.000 cho bản production, ít hơn cho bản demo. Ở tầng model trung, tiền token khoảng $17 cho mỗi 1.000 câu trả lời trước khi cache, hoặc dưới $1 cho mỗi 1.000 câu trên GPT-6 Luna nếu chất lượng vẫn đạt trên bộ eval của bạn.
Thêm AI vào ứng dụng có sẵn có rẻ hơn xây ứng dụng AI mới không?
Thường là có, khi AI chỉ là một tính năng gọi API model: khoảng $4.000–$30.000, vì đăng nhập, dữ liệu và giao diện đã có sẵn. Chi phí tăng trở lại khi tính năng cần dữ liệu mà ứng dụng chưa từng được thiết kế để mở ra, hoặc cần hành động thay người dùng.
Voice AI agent tốn bao nhiêu mỗi phút?
Trên gpt-realtime-2.1 của OpenAI ($32 cho mỗi triệu token âm thanh đầu vào, $64 cho mỗi triệu token âm thanh đầu ra), âm thanh được tính 1 token cho mỗi 100 ms giọng người dùng và 1 token cho mỗi 50 ms giọng model. Tức là khoảng $0,02 cho mỗi phút người gọi nói và $0,08 cho mỗi phút agent nói, chưa tính lịch sử hội thoại bị tính lại ở mỗi lượt, công cụ và cước tổng đài. Bản mini rẻ bằng khoảng một phần ba.
Model mã nguồn mở có rẻ hơn model qua API không?
Tính theo token, tự host có thể rẻ hơn khi lưu lượng lớn và đều. Dưới mức đó, GPU, vận hành và eval thường tốn hơn tiền token API, và các tầng API $0,10 cho mỗi triệu token đã thu hẹp khoảng cách. Chạy model nhỏ ngay trên thiết bị người dùng là trường hợp model mở thắng rõ cả về chi phí lẫn quyền riêng tư.
Giá token AI có tiếp tục giảm không?
Xu hướng chung của đa số tầng là giảm, nhưng không theo đường thẳng. Có giá tăng khi khuyến mãi hết hạn, như Gemini 3.8 Flash từ 01/01/2027. Hãy thiết kế để có thể đổi model phía sau một bộ eval, và tính lại hóa đơn mỗi quý.
BeevR là studio AI do founder dẫn dắt, đội ngũ senior, đặt tại Hà Nội. Chúng tôi làm giá cố định theo từng giai đoạn, bạn sở hữu code và IP từ ngày đầu, và chúng tôi xây AI cho các ngành bị quản lý. So sánh các gói trên trang chi phí MVP, hoặc kể cho chúng tôi bạn đang xây gì. Chúng tôi sẽ cùng bạn gọi tên kiến trúc, ước tính hóa đơn token hằng tháng và đưa ra một con số cố định cho phần xây.