Có, bạn làm được AI agent theo giá cố định, nếu cố định đúng thứ: phạm vi (tác vụ, công cụ, tích hợp), một bộ eval đã gán nhãn, và ngưỡng đạt mà agent phải vượt trên bộ đó. Không cố định từng câu trả lời của model. Hãy định giá discovery riêng, rồi xây theo từng giai đoạn, mỗi giai đoạn kết thúc bằng một cổng eval đo được.
Founder và CTO hay nghe rằng làm AI "không thể giá cố định vì LLM khó đoán". Câu đó chỉ đúng một nửa. Từng câu trả lời thì khó đoán. Hiệu năng đo trên một bộ test cố định thì không, và bạn ký hợp đồng được dựa trên nó. Bài này đi qua những gì một dự án AI agent giá cố định nên gồm và không gồm, cách viết tài liệu phạm vi, cách đặt tiêu chí nghiệm thu, cách xử lý thay đổi yêu cầu, và cách bên làm giữ giá cố định một cách trung thực khi bản thân model vẫn còn bất định.
Phát triển AI agent có làm giá cố định được không?
Được, với một agent được định nghĩa rõ: biết trước tập tác vụ, biết trước các công cụ và hệ thống nó được chạm vào, và có cách đo thành công đã thống nhất. Giá cố định không còn hợp khi mục tiêu vẫn là nghiên cứu mở ("xem AI làm được gì với dữ liệu của mình") hoặc khi chưa biết sẽ tích hợp với gì. Những việc đó nên làm trước, dưới dạng một giai đoạn discovery ngắn.
LLM là non-deterministic, và chính hướng dẫn eval của OpenAI nói thẳng: "Generative AI is variable." Vì thế các thực hành eval của OpenAI khuyên dựng test từ tác vụ thật, chấm điểm tự động có đối chiếu với đánh giá của người, và chạy lại liên tục khi hệ thống thay đổi. Hợp đồng giá cố định dùng đúng công cụ đó. Thứ được giao không phải là "agent luôn trả lời đúng", mà là "agent đạt các điểm số này trên bộ test này, với các guardrail này".
Một dự án AI agent giá cố định gồm những gì?
Phạm vi giá cố định tốt gồm các workflow của agent, tích hợp công cụ, guardrail và bước phê duyệt, bộ eval và hạ tầng chấm điểm, observability và kiểm soát chi phí, triển khai lên cloud của bạn, và tài liệu. Phí sử dụng model, tích hợp mới thêm giữa chừng và việc chỉnh prompt không giới hạn sau nghiệm thu thường không nằm trong giá.
| Thường có trong giá | Thường không có (hoặc tính riêng) |
|---|---|
| Các workflow được nêu tên, có đầu vào và đầu ra | Workflow hoặc tác vụ mới thêm sau khi chốt |
| Tích hợp với các hệ thống được nêu tên qua API chính thức | Tích hợp với hệ thống không có API, hoặc khách không cấp được quyền |
| Guardrail: hành động được phép, bước phê duyệt, hạn mức chi tiêu hoặc giá trị | Thay đổi chính sách phê duyệt của khách giữa chừng |
| Bộ eval, test set đã gán nhãn, chấm điểm và báo cáo đạt | Gán nhãn bộ dữ liệu lớn mới ngoài phần đã thống nhất |
| Observability: trace mọi lần gọi model và công cụ, audit log, dashboard chi phí | Giấy phép công cụ monitoring bên thứ ba |
| Triển khai lên tài khoản cloud của khách, infrastructure as code | Phí cloud, API model và SaaS khi vận hành (khách trả trực tiếp) |
| Runbook, bàn giao và thời gian bảo hành lỗi | Hỗ trợ liên tục và tính năng mới sau bảo hành (retainer) |
Hai mục gây tranh cãi nhiều nhất. Thứ nhất là chi phí model. Khoản này nên tính vào tài khoản của chính bạn, để bạn thấy trực tiếp và bên làm không có lý do đội giá. Thứ hai là yêu cầu "cho nó thông minh hơn" sau nghiệm thu. Đó là việc mới, tính giá như một change request hoặc retainer.
Viết tài liệu phạm vi cho AI agent thế nào?
Viết theo danh sách công việc, không theo danh sách tính năng. Với mỗi công việc, ghi rõ điều kiện kích hoạt, đầu vào, các công cụ agent được gọi, hành động nó được tự làm, hành động cần người, đầu ra, và cách chấm điểm thành công. Sau đó liệt kê hệ thống, dữ liệu và quyền truy cập mà khách cung cấp, kèm ngày cung cấp.
Checklist tài liệu phạm vi
- Công việc. Ví dụ: "Khớp hoá đơn nhà cung cấp với đơn mua hàng; đánh dấu chênh lệch trên 2% để người duyệt."
- Công cụ và quyền. Từng API agent được gọi, đọc hay ghi, với đúng quyền cần thiết. Dùng API chính thức và quyền hẹp nhất, không bao giờ dùng chung tài khoản admin.
- Mức tự chủ. Việc agent tự làm, việc nó soạn sẵn để người duyệt, và việc nó không bao giờ được làm. Hướng dẫn của Anthropic về xây agent hiệu quả cảnh báo rằng tự chủ đi kèm chi phí cao hơn và nguy cơ lỗi cộng dồn. Vì vậy bước phê duyệt phải nằm trong phạm vi ngay từ đầu, không để sang giai đoạn sau.
- Dữ liệu. Agent thấy những bản ghi nào, bao nhiêu, lưu bao lâu, có dữ liệu chịu quản lý (PHI, dữ liệu thẻ) hay không.
- Đánh giá. Kích thước và nguồn của test set, ai gán nhãn, các chỉ số và ngưỡng.
- Mục tiêu phi chức năng. Độ trễ, chi phí mỗi tác vụ, độ sẵn sàng, ngôn ngữ.
- Phụ thuộc phía khách. Tài khoản sandbox, API key, dữ liệu mẫu và một người duyệt được nêu tên, mỗi thứ có ngày.
- Ngoài phạm vi. Ghi ra rõ ràng. Đây là dòng giữ cho giá được cố định.
Hãy bắt đầu bằng thiết kế đơn giản nhất mà vẫn qua được eval. Lời khuyên của Anthropic cũng vậy: bắt đầu từ giải pháp đơn giản nhất và chỉ thêm độ phức tạp khi thật sự cần. Nhiều khi một workflow xác định với một hai lần gọi model thắng một agent tự do cả về chi phí, độ tin cậy lẫn giá.
Đặt tiêu chí nghiệm thu thế nào khi output của LLM không xác định?
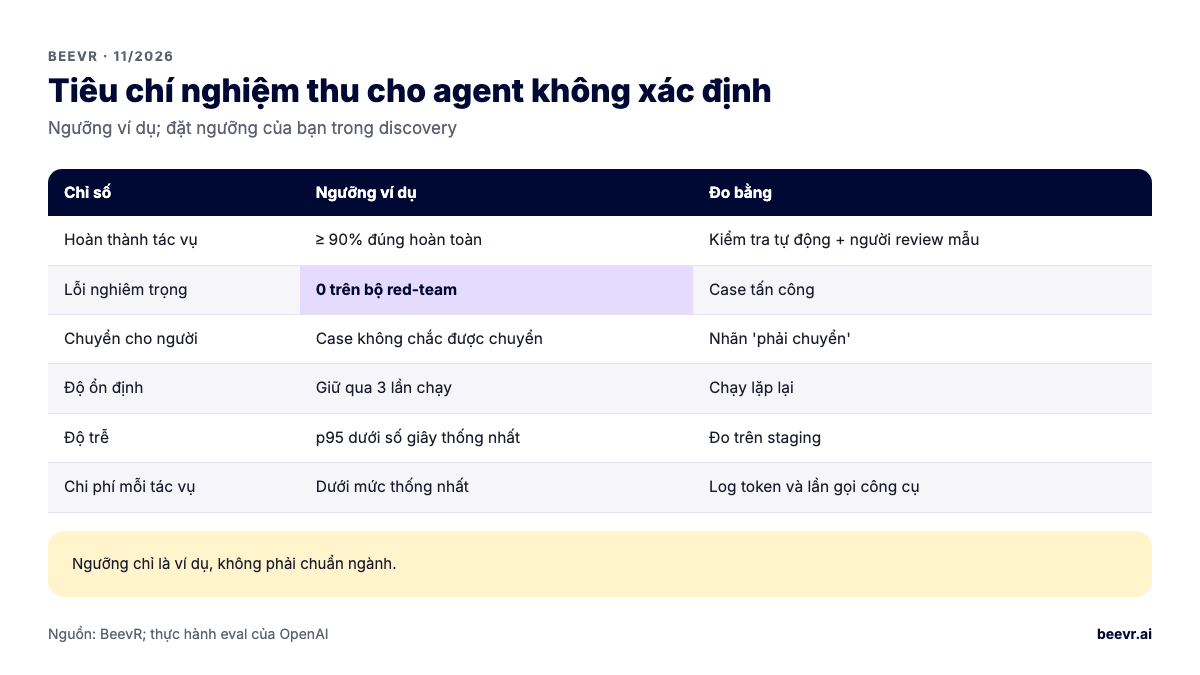
Nghiệm thu agent trên một test set đã gán nhãn và được đóng băng, có ngưỡng cho từng chỉ số, chạy nhiều lần để tính đến dao động, cộng một danh sách các hành động không an toàn mà agent không được phạm lần nào. Nếu agent đạt mọi ngưỡng trên bộ đã thống nhất, mốc đó được nghiệm thu, kể cả khi sau này có một cuộc hội thoại riêng lẻ bị sai.
| Chỉ số | Ngưỡng ví dụ (đặt theo từng dự án) | Cách đo |
|---|---|---|
| Hoàn thành tác vụ | ≥ 90% test case đúng hoàn toàn | Kiểm tra tự động cộng người review một mẫu |
| Lỗi nghiêm trọng | 0 trên bộ red-team (ví dụ một hành động ngoài danh sách cho phép) | Các case tấn công viết trong discovery |
| Chất lượng chuyển cho người | Case không chắc chắn được chuyển cho người, không đoán bừa | Các case gán nhãn "phải chuyển" |
| Độ ổn định | Tỷ lệ đạt giữ trong biên độ thống nhất qua 3 lần chạy | Chạy lặp lại cùng một bộ |
| Độ trễ | p95 dưới số giây đã thống nhất | Đo trên môi trường staging |
| Chi phí mỗi tác vụ | Dưới mức thống nhất theo giá niêm yết của model đã pin | Log token và lần gọi công cụ |
Các con số trên là ví dụ, không phải chuẩn ngành. Hãy đặt con số của bạn trong discovery, dựa trên chất lượng của quy trình thủ công hiện tại. Đóng băng test set khi mốc bắt đầu. Bên nào muốn thêm case thì đưa vào bộ của mốc sau, để mục tiêu không bị dời giữa chừng. Với dự án chịu quản lý, xem bài kiểm thử LLM cho ngành chịu quản lý. Cách theo dõi agent sau khi chạy thật có trong bài đánh giá và quan sát AI agent.
Thay đổi yêu cầu trong dự án AI giá cố định nên xử lý thế nào?
Mọi thay đổi về công việc, công cụ, tích hợp, nguồn dữ liệu hay ngưỡng đều là change request, có giá và tác động tiến độ bằng văn bản, được duyệt trước khi làm. Việc chỉnh prompt và logic để đạt các ngưỡng đã thống nhất là trách nhiệm của bên làm và không bao giờ là change request.
Cách chia này giữ cả hai bên trung thực. Khách không thể thêm tích hợp mới miễn phí bằng cách gọi nó là "tinh chỉnh". Bên làm không thể tính thêm tiền vì không đạt ngưỡng mà mình đã nhận. Thêm hai quy tắc nữa:
- Nhà cung cấp model thay đổi model. Pin phiên bản model. Nếu nhà cung cấp ngừng model giữa dự án, bên làm chạy lại eval trên model thay thế và tự chịu một lượng tinh chỉnh cố định đã thống nhất. Phần vượt quá chia sẻ qua change request.
- Phụ thuộc phía khách bị trễ. Nếu quyền sandbox hoặc dữ liệu gán nhãn đến muộn, tiến độ lùi đúng bằng khoảng đó. Giá chỉ đổi khi sự chậm trễ buộc đội phải dừng rồi khởi động lại.
Dự án AI agent giá cố định nên có những mốc nào?
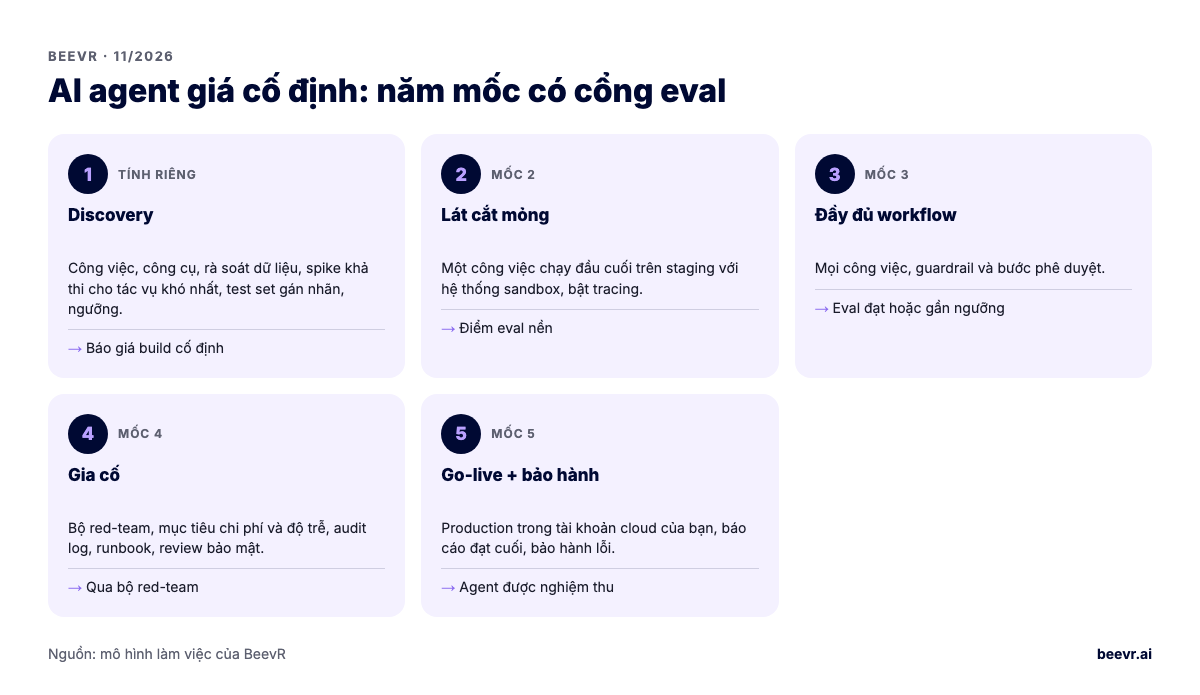
Dùng bốn đến năm mốc, mỗi mốc kết thúc bằng thứ bạn chạy và chấm điểm được: discovery và bộ eval, một lát cắt mỏng chạy từ đầu đến cuối, đầy đủ workflow kèm guardrail, gia cố cho production, và go-live kèm bảo hành. Thanh toán theo mốc, không theo giờ.
- Discovery (cố định, tính riêng). Danh sách công việc, công cụ, rà soát dữ liệu, một spike khả thi cho tác vụ khó nhất, test set gán nhãn đầu tiên, các ngưỡng, và báo giá cố định cho phần build.
- Lát cắt mỏng. Một công việc chạy từ đầu đến cuối trên staging với hệ thống thật (sandbox), có tracing. Báo cáo điểm eval nền.
- Đầy đủ workflow. Mọi công việc, guardrail và bước phê duyệt. Eval đạt hoặc gần đạt ngưỡng.
- Gia cố. Bộ red-team, mục tiêu chi phí và độ trễ, audit log, runbook, review bảo mật.
- Go-live và bảo hành. Triển khai production trong tài khoản của bạn, báo cáo đạt cuối cùng, thời gian bảo hành lỗi.
Demo chạy được mỗi tuần giữ cho các mốc trung thực: vấn đề lộ ra sớm, không đợi tới buổi ra mắt cuối. Bài từ pilot lên production nói về những gì thay đổi giữa mốc 2 và mốc 4.
Bên làm giữ giá cố định trung thực thế nào khi LLM còn bất định?
Bằng cách giảm bất định trước khi báo giá: một giai đoạn discovery có trả phí với spike khả thi cho tác vụ khó nhất, một điểm eval nền, và chỉ báo giá build khi đã biết cả hai. Bên nào báo giá cố định cho agent mà chưa thử phần khó thì hoặc đang độn giá rất nhiều, hoặc đang đoán.
Hãy hỏi bên làm cách họ xử lý bốn rủi ro. Khả thi: tác vụ khó nhất đã được thử trên dữ liệu của bạn trước khi báo giá chưa? Chi phí vận hành: có trần cứng về token và số lần gọi công cụ mỗi tác vụ, được cài trong code không? Vòng lặp agentic có thể nhân chi phí lên nhiều lần, như bài chi phí vận hành AI phân tích. Trôi hành vi: phiên bản model có được pin và eval có chạy lại mỗi lần thay đổi không? Quản trị: thiết kế có ánh xạ vào một khung được công nhận như NIST AI Risk Management Framework và Generative AI Profile của nó (NIST AI 600-1), để đội quản trị rủi ro của bạn review được không?
Khi nào giá cố định là ý tồi cho một AI agent?
Khi bạn chưa mô tả được các công việc, khi thước đo thành công là "nhìn thấy thì sẽ biết", khi các hệ thống lõi không có quyền truy cập API, hoặc khi dự án thực chất là nghiên cứu xem bài toán có giải được không. Hãy làm discovery có giới hạn thời gian hoặc một spike tính theo giờ trước, rồi mới cố định giá cho phần build.
Giá cố định cũng là ý tồi khi một sản phẩm có sẵn đã làm đủ tốt. Mua thường rẻ hơn. Xem bài tự xây hay mua AI agent và so sánh chung giá cố định hay tính theo giờ.
BeevR làm việc này thế nào
Chúng tôi là đội senior do founder trực tiếp dẫn dắt ở Hà Nội, xây AI agent theo phạm vi cố định, giá cố định theo giai đoạn, từ $10K mỗi giai đoạn. Discovery cho ra danh sách công việc, spike khả thi cho tác vụ khó nhất, test set gán nhãn và các ngưỡng, rồi mới có báo giá cố định cho phần build. Mỗi mốc kết thúc bằng một báo cáo eval mà bạn tự chạy lại được, và bạn xem demo chạy được mỗi thứ Sáu. Agent gọi hệ thống của bạn qua API chính thức với quyền giới hạn. Hành động có hệ quả phải qua bước người duyệt, và mọi lần gọi model và công cụ đều vào audit log. Chi phí model chạy trên tài khoản của chính bạn. Với khách y tế, model có thể chạy trong tài khoản AWS của bạn dưới BAA của AWS (Amazon Bedrock có trong danh sách HIPAA Eligible Services của AWS), và chúng tôi ký BAA với tư cách business associate.
Bạn sở hữu source code, prompt, bộ eval và IP từ ngày đầu, không có phí theo người dùng. Chúng tôi được 5.0 trên Clutch. Xem trang phát triển AI agent hoặc các khung chi phí trong bài AI agent tốn bao nhiêu.
Đang có ý tưởng agent? Đặt lịch gọi 30 phút. Chúng tôi sẽ cùng bạn viết bản phạm vi đầu tiên và nói thật liệu đã nên làm giá cố định hay chưa.