Đánh giá AI scribe ambient theo thứ tự: bỏ sót trước, bịa nội dung sau, thời gian tiết kiệm cuối cùng. Một nghiên cứu lớn ghi nhận khoảng 1,5% câu trong ghi chú bị bịa và 3,5% câu bị bỏ sót, còn một thử nghiệm ngẫu nhiên năm 2025 cho thấy bác sĩ vẫn gặp lỗi đáng kể "thỉnh thoảng". Người ký ghi chú chịu trách nhiệm, nên quy trình đánh giá phải chứng minh họ bắt được lỗi.
AI scribe ambient giờ là ứng dụng AI tạo sinh được triển khai rộng nhất trong khám chữa bệnh ở Mỹ. Epic ra sản phẩm riêng từ tháng 2/2026, Microsoft gộp DAX vào Dragon Copilot năm 2025, và phần lớn hệ thống y tế đang ở vòng so sánh nhà cung cấp thứ hai hoặc thứ ba. Câu hỏi khó đã chuyển từ "có tiết kiệm thời gian không?" sang "làm sao biết nó đủ an toàn, và ai chịu trách nhiệm khi nó không an toàn?". Bài này đi qua những gì các nghiên cứu thực sự đo, các chỉ số quan trọng, cách tự chạy đánh giá, và trách nhiệm pháp lý nằm ở đâu. Dữ kiện được kiểm tra ngày 12/11/2026.
Các nghiên cứu đã công bố nói gì về tỷ lệ lỗi của AI scribe ambient?
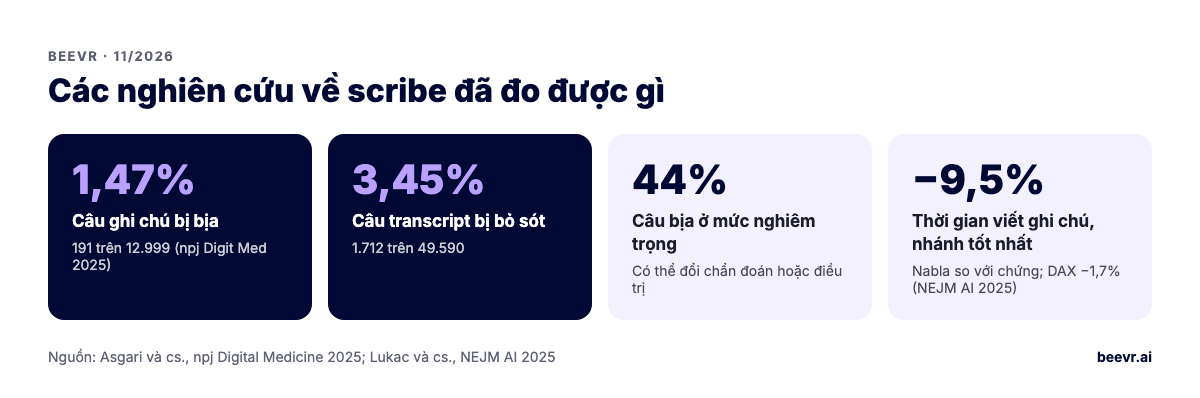
Bằng chứng tốt nhất cho thấy tỷ lệ lỗi thấp nhưng có thật, và bỏ sót phổ biến hơn bịa đặt. Trong một nghiên cứu trên npj Digital Medicine năm 2025 với 12.999 câu ghi chú được bác sĩ gán nhãn, 1,47% bị bịa và 3,45% câu trong transcript bị bỏ sót; 44% số câu bịa được xếp mức nghiêm trọng.
Ba nguồn nên đọc kỹ trước mọi buổi gặp nhà cung cấp:
- Asgari và cộng sự, npj Digital Medicine, tháng 5/2025. Một khung đánh giá an toàn lâm sàng và tỷ lệ bịa của ghi chú do LLM tạo. 191 câu bịa trên 12.999 câu; 1.712 câu bị bỏ sót trên 49.590 câu transcript; 84 trong 191 câu bịa (44%) là "nghiêm trọng", tức có thể đổi chẩn đoán hoặc điều trị nếu không sửa. Nhóm tác giả làm cho một công ty scribe và dùng model thời GPT-4, nên hãy coi con số tuyệt đối là mốc tham chiếu, không phải benchmark cho sản phẩm hôm nay. Phần giá trị nhất là phương pháp.
- Lukac và cộng sự, NEJM AI, tháng 11/2025. Một thử nghiệm ngẫu nhiên ba nhánh với 238 bác sĩ ngoại trú tại UCLA Health, so sánh Microsoft DAX Copilot, Nabla và nhóm chứng. Nabla giảm thời gian viết ghi chú 9,5% so với nhóm chứng (có ý nghĩa thống kê); DAX giảm 1,7% (không có ý nghĩa). Bác sĩ chấm lỗi đáng kể về lâm sàng ở mức 2,7–2,8 trên thang 5, nghĩa là "thỉnh thoảng". Có một biến cố nhẹ: phần tư vấn bị bỏ khỏi kế hoạch điều trị.
- Kaiser Permanente, 2025. The Permanente Medical Group cho biết 7.260 bác sĩ đã dùng scribe ambient trong khoảng 2,58 triệu lượt khám từ tháng 10/2023 đến tháng 12/2024, tiết kiệm ước tính 15.791 giờ. Phần rà độ chính xác của họ nhỏ, dựa trên một mẫu transcript.
Cả ba cho cùng một bức tranh. Thời gian tiết kiệm ở mức vừa phải và tập trung ở người dùng nhiều. Lỗi không phổ biến nhưng không hiếm, và loại hay gặp nhất là thiếu thông tin chứ không phải bịa thông tin. Điều đó quan trọng, vì người rà đang bận khó phát hiện cái bị thiếu hơn nhiều so với một con số sai.
Nên dùng chỉ số nào để đánh giá AI scribe?
Đo bốn thứ: tỷ lệ bỏ sót nghiêm trọng, tỷ lệ bịa nghiêm trọng, khối lượng chỉnh sửa, và thời gian viết ghi chú tính cả thời gian sửa. Báo cáo theo từng ghi chú và từng câu, tách theo chuyên khoa và loại lượt khám, và đừng bao giờ chấp nhận một con số "độ chính xác" duy nhất.
| Chỉ số | Cách đo | Vì sao quan trọng | Bẫy thường gặp |
|---|---|---|---|
| Tỷ lệ bỏ sót (nặng / nhẹ) | Người gán nhãn đánh dấu dữ kiện lâm sàng có trong transcript nhưng thiếu trong ghi chú | Loại lỗi phổ biến nhất trong các nghiên cứu | Nhà cung cấp chỉ báo tỷ lệ bịa |
| Tỷ lệ bịa (nặng / nhẹ) | Câu trong ghi chú không có căn cứ trong transcript | Tạo trực tiếp dữ liệu sai trong hồ sơ | Tính cả thay đổi văn phong là lỗi, hoặc bỏ qua phủ định bị đảo |
| Lỗi gán người nói | Câu gán nhầm người nói; đảo đại từ, đảo phủ định | Được ghi nhận trong thử nghiệm UCLA; dễ bỏ qua | Không có trong hầu hết bảng điểm của nhà cung cấp |
| Khối lượng chỉnh sửa | Số ký tự hoặc mục bị đổi giữa nháp và bản ký | Thước đo gián tiếp cho công sức rà thật | Gần như không sửa có thể nghĩa là bác sĩ đã thôi đọc |
| Thời gian viết ghi chú | Thời gian từ audit log EHR, gồm cả lúc sửa | Cơ sở của bài toán kinh doanh | Thử nghiệm UCLA lưu ý chỉ số của họ không tính thời gian sửa |
| Hiệu năng theo nhóm | Tất cả chỉ số trên theo ngôn ngữ, giọng, chuyên khoa, độ dài lượt khám | Lỗi không phân bố đều | Thử nghiệm chỉ với bác sĩ hào hứng, nói tiếng Anh |
Hãy định nghĩa "nghiêm trọng" trước khi bắt đầu. Định nghĩa của bài npj là mặc định tốt: lỗi nghiêm trọng nếu, khi không sửa, nó có thể đổi chẩn đoán hoặc điều trị. Viết ra, huấn luyện người gán nhãn trên hai mươi ví dụ, và đo mức đồng thuận giữa họ. Thiếu bước đó, hai người rà sẽ bất đồng ở khoảng một phần ba ca ranh giới và con số của bạn không còn nhiều ý nghĩa.
Các hệ thống y tế chạy đánh giá AI scribe như thế nào?
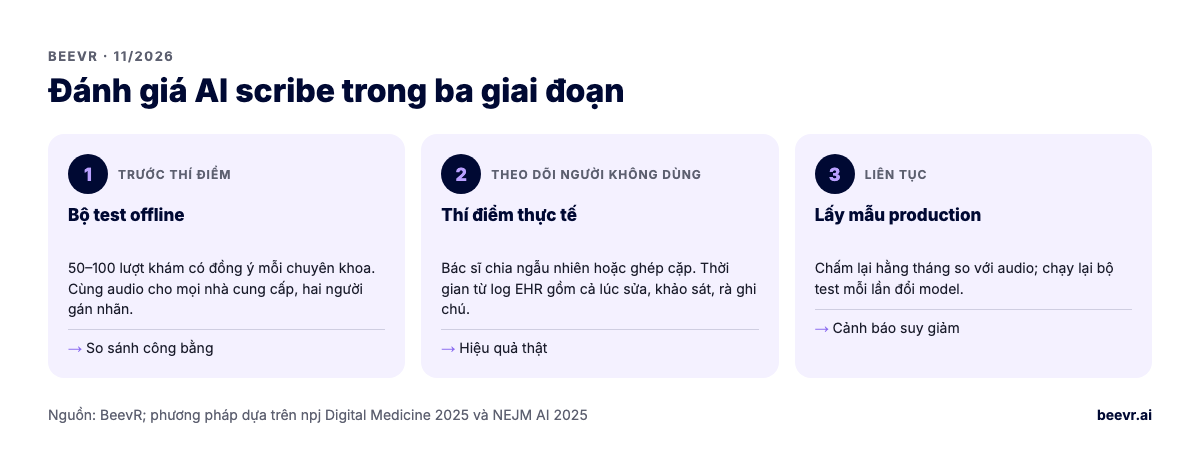
Những nơi làm tốt chạy ba giai đoạn: kiểm thử offline trên các lượt khám đã ghi âm có đồng ý với nhãn chuẩn; thí điểm thực tế có nhóm đối chứng; và lấy mẫu liên tục sau go-live. Mỗi giai đoạn trả lời một câu hỏi khác nhau, và bỏ qua giai đoạn đầu là sai lầm phổ biến nhất.
Giai đoạn 1: bộ test offline
Thu 50–100 lượt khám có đồng ý cho mỗi chuyên khoa chính, kèm transcript và ghi chú do chính bác sĩ viết làm tham chiếu. Chạy mọi nhà cung cấp ứng viên trên cùng audio. Hai người gán nhãn đã được huấn luyện chấm từng bản nháp theo bỏ sót, bịa và lỗi gán người nói với một bộ phân loại cố định. Đây là giai đoạn duy nhất so sánh nhà cung cấp công bằng, vì đầu vào giống hệt nhau. Đây cũng là lúc cố ý thử ca khó: có phiên dịch, người nhà nói chen, audio kém, lượt khám dài, và thuật ngữ chuyên khoa.
Giai đoạn 2: thí điểm thực tế
Chia ngẫu nhiên hoặc ghép cặp bác sĩ vào nhóm dùng và nhóm chứng, như thử nghiệm UCLA, rồi đo thời gian viết ghi chú từ audit log EHR, khảo sát kiệt sức, và một mẫu ghi chú được rà. Theo dõi mức sử dụng: trong thử nghiệm đó khoảng 15% bác sĩ được cấp scribe chưa từng dùng, và tỷ lệ dùng chỉ khoảng một phần ba số lượt khám đủ điều kiện. Thí điểm chỉ báo kết quả từ người dùng nhiệt tình sẽ thổi phồng lợi ích.
Giai đoạn 3: giám sát production
Sau go-live, mỗi tháng lấy một số ghi chú cố định cho từng nhóm bác sĩ, chấm lại so với audio, và theo dõi xu hướng. Chạy lại bộ test offline mỗi khi nhà cung cấp đổi model, việc có thể xảy ra mà không báo nhiều. Hãy ghi vào hợp đồng cách họ thông báo cho bạn. Cách xây các bộ test này có trong bài kiểm thử LLM cho ngành chịu quản lý.
Ai chịu trách nhiệm khi AI scribe mắc lỗi?
Trên thực tế là bác sĩ ký ghi chú. CMS nói khi bạn dùng scribe, kể cả công nghệ AI, bạn phải ký để xác thực ghi chú, và các hội đồng y khoa bang coi bác sĩ chịu trách nhiệm về cách họ dùng AI. Hợp đồng nhà cung cấp thường giới hạn trách nhiệm của họ, nên hệ thống y tế gánh rủi ro vận hành.
Ba nguồn định khung:
- Quy định chữ ký của CMS. Tài liệu yêu cầu chữ ký Medicare tháng 7/2025 ghi rằng khi một scribe, kể cả công nghệ trí tuệ nhân tạo, ghi hồ sơ thay bạn, bạn phải ký để xác thực; scribe không ký.
- Hội đồng y khoa bang. Chính sách năm 2024 của FSMB về AI trong thực hành lâm sàng nói bác sĩ là người chịu trách nhiệm cuối cùng về việc dùng AI. Đây là hướng dẫn, không phải luật, nhưng các hội đồng có dùng.
- Luật bang. Một số bang đã có quy định riêng. Ví dụ Texas SB 1188 yêu cầu người hành nghề dùng AI trong chẩn đoán phải rà hồ sơ do AI tạo. Chúng tôi theo dõi trong bài luật AI y tế theo từng bang.
Hệ quả thực tế: quy trình đánh giá của bạn cũng là một kiểm soát trách nhiệm pháp lý. Nếu bạn chứng minh được đã đo tỷ lệ lỗi, đào tạo bác sĩ về các loại lỗi thường gặp, thiết kế màn hình rà để làm lộ chúng, và giám sát sau khi ra mắt, vị thế của bạn tốt hơn nhiều so với một tổ chức bật công cụ lên rồi tin nó. Hãy yêu cầu nhà cung cấp ghi rõ bằng văn bản điều khoản bồi hoàn, nghĩa vụ báo lỗi và thông báo đổi model.
Quy trình rà soát nên trông thế nào để bắt được lỗi?
Thiết kế màn hình rà quanh đúng các lỗi bạn đã đo. Hiển thị transcript nguồn cạnh từng mục, tô nổi câu có căn cứ yếu, buộc người rà chú ý vào assessment và plan, và đánh dấu phủ định và thay đổi thuốc để xem lại lần hai.
- Liên kết nguồn. Bấm vào bất kỳ câu nào để nghe hoặc đọc đoạn transcript sinh ra nó. Câu không có nguồn được tô nổi.
- Gợi ý bỏ sót. Danh sách những mục đã được nói trong transcript nhưng không có trong ghi chú ("thay đổi thuốc nhắc ở phút 06:12 không có trong plan"). Bỏ sót là vô hình nếu không có gì chỉ ra.
- Từ khóa rủi ro cao. Phủ định, bên trái/phải, liều và dị ứng được làm nổi, vì chỉ một từ bị đảo là lỗi nghiêm trọng.
- Lưu cả bản nháp và bản đã ký. Phần khác nhau là tín hiệu liên tục tốt nhất về chất lượng model.
Đây là bài toán thiết kế human-in-the-loop nhiều hơn là bài toán AI. Một bước rà mà bác sĩ bấm qua trong ba giây không phải là kiểm soát.
Nên tự xây AI scribe ambient hay mua?
Với phần lớn hệ thống y tế và phòng khám, hãy mua. Các sản phẩm hàng đầu tích hợp với EHR lớn và có quy mô bạn khó theo kịp. Chỉ tự xây khi cần chuyên khoa hoặc ngôn ngữ mà sản phẩm xử lý kém, EHR không được hỗ trợ, scribe nằm trong sản phẩm của chính bạn, hoặc audio và model phải nằm trong tài khoản cloud của bạn.
Nếu tự xây, phần khó không phải là model. Đó là diarization (ai nói gì), thuật ngữ y khoa trong phòng ồn, mẫu ghi chú theo chuyên khoa, ghi ngược vào EHR dưới dạng nháp chưa ký, và bộ đánh giá ở trên. AWS liệt kê Transcribe (gồm HealthScribe) và Bedrock là dịch vụ đủ điều kiện HIPAA, cho phép audio, chuyển giọng nói và model ngôn ngữ chạy dưới một BAA. Kể cả khi mua, bạn vẫn cần năng lực đánh giá; đó là cách duy nhất để so nhà cung cấp và nhận ra khi một bản cập nhật model làm mọi thứ tệ hơn. Bài kiến trúc AI agent tuân thủ HIPAA nói về các kiểm soát xung quanh.
Nên hỏi nhà cung cấp AI scribe những gì trước khi ký?
Hỏi tỷ lệ bỏ sót và bịa của họ kèm định nghĩa và cỡ bộ test, kết quả theo chuyên khoa và ngôn ngữ, cách họ báo khi đổi model, họ giữ dữ liệu gì và bao lâu, dữ liệu của bạn có được dùng để train model không, và họ nhận trách nhiệm tới đâu.
- BAA đã ký, và danh sách nhà thầu phụ chạm vào audio.
- Thời gian giữ audio và transcript, và xóa khi được yêu cầu.
- Dữ liệu khách hàng có dùng để train model không, kèm quyền từ chối ghi trong hợp đồng.
- Chỉ số lỗi có định nghĩa; có sẵn sàng chạy trên bộ test offline của bạn không.
- Báo trước khi đổi model và cách cố định phiên bản hoặc test trước khi triển khai.
- Báo cáo sự cố an toàn: bạn báo lỗi thế nào và họ phản hồi ra sao.
Hướng dẫn của Joint Commission và Coalition for Health AI ban hành tháng 9/2025 yêu cầu tổ chức giám sát chất lượng AI liên tục và báo cáo sự cố an toàn AI. Những câu hỏi trên là cách để làm được điều đó.
BeevR làm việc này thế nào
Chúng tôi thường tham gia ở một trong hai điểm. Hệ thống y tế và công ty digital health nhờ chúng tôi xây bộ đánh giá: bộ test có đồng ý, công cụ gán nhãn với bộ phân loại lỗi cố định, chấm tự động ở chỗ đáng tin, và dashboard theo chuyên khoa và nhà cung cấp. Công ty sản phẩm nhờ chúng tôi xây tính năng scribe hoặc hồ sơ ngay trong nền tảng của họ, với nháp có liên kết nguồn, gợi ý bỏ sót, ghi ngược vào EHR dạng nháp chưa ký, và cùng bộ đánh giá đó chạy trong CI. Model có thể chạy trong chính tài khoản AWS của bạn dưới BAA với AWS, và BeevR ký BAA với vai trò business associate.
Chúng tôi là đội senior do founder dẫn dắt tại Hà Nội, 5.0 trên Clutch, và đã xây một EHR multi-tenant đang chạy tại bốn phòng khám ở Mỹ với khoảng 300 bệnh nhân mỗi ngày. Chúng tôi làm theo giai đoạn cố định, từ $10K mỗi giai đoạn, có demo chạy được mỗi thứ Sáu, và bạn sở hữu code từ ngày đầu. Xem phát triển AI agent cho y tế và tích hợp EHR.
Nếu bạn đang lên kế hoạch so sánh scribe hoặc đưa AI hồ sơ vào sản phẩm, đặt một cuộc gọi 30 phút. Chúng tôi sẽ rà kế hoạch đánh giá của bạn và chỉ ra chỗ nó sẽ cho con số gây hiểu lầm.