Bulk FHIR ($export) là công cụ đúng cho các lần trích xuất định kỳ theo cohort phục vụ phân tích, báo cáo chất lượng và bộ đánh giá AI. Nó là công cụ sai cho việc đồng bộ data warehouse gần thời gian thực. Hãy chuẩn bị cho job bất đồng bộ tính bằng giờ, file NDJSON có hạn (14 ngày ở Epic), các EHR lớn chỉ hỗ trợ Group, và một bước khử định danh trước mọi việc dùng cho AI.
Dữ liệu cấp quần thể bỗng có mặt trong mọi roadmap. Đội AI cần bộ dữ liệu huấn luyện và đánh giá, payer có các API Provider Access và Payer-to-Payer theo CMS-0057-F tới hạn từ 01/01/2027, còn các chương trình chất lượng và value-based care cần trích xuất theo cohort. HL7 Bulk Data Access IG, còn gọi là Flat FHIR, hiện ở v3.0.0 (STU 3). Nhưng điều đặc tả cho phép và điều từng EHR triển khai là hai chuyện khác nhau. Bài này đi qua giao thức, giới hạn của vendor, các yếu tố quyết định hiệu năng và chi phí, và cách khử định danh trước khi dữ liệu tới model.
Bulk FHIR export là gì?
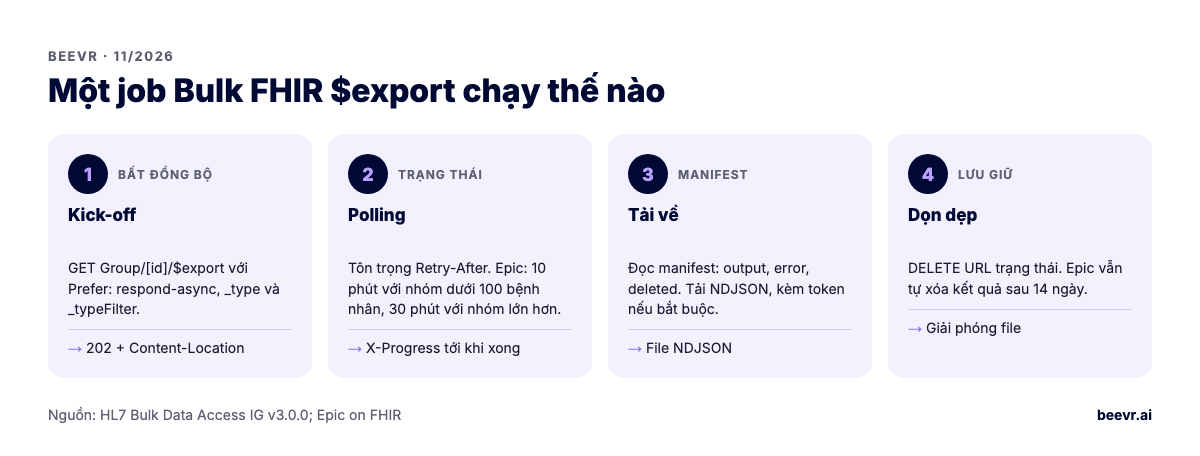
Đó là một thao tác FHIR bất đồng bộ ($export) trả về lượng lớn dữ liệu cho cả hệ thống, một nhóm hoặc một tập bệnh nhân, dưới dạng file JSON phân tách theo dòng (NDJSON). Bạn khởi động job, polling một URL trạng thái, rồi tải các file được liệt kê trong manifest.
Luồng theo đặc tả export:
- Kick-off tại
[base]/$export,[base]/Patient/$exporthoặc[base]/Group/[id]/$exportvới headerPrefer: respond-async. Thành công trả về202 Acceptedkèm headerContent-Locationtrỏ tới endpoint trạng thái. - Polling trạng thái. Khi đang chạy, server trả 202 kèm
X-ProgressvàRetry-Aftertùy chọn. Hãy tôn trọngRetry-After. - Đọc manifest khi hoàn tất:
transactionTime,requiresAccessToken, và các mảng fileoutput,deleted,error. - Tải các file NDJSON (server bắt buộc hỗ trợ NDJSON). Nếu
requiresAccessTokenlà true, request tải file cần được bảo vệ bằng access token giống như lúc kick-off. - Dọn dẹp bằng lệnh DELETE tới URL trạng thái, server có thể coi đó là tín hiệu được phép xóa file.
Phân quyền nên theo SMART Backend Services, với scope bao trùm mọi loại resource được export.
Bulk Data v3.0.0 có gì mới?
STU 3 thêm manifest từng phần (allowPartialManifests) để server trả file trước khi cả job xong, đầu ra sắp theo từng instance resource (organizeOutputBy), tham số _until đi cặp với _since, một Group profile cho cohort theo đặc điểm, và đưa _typeFilter ra khỏi nhóm thử nghiệm.
Theo change log của IG, STU 2 đã thêm kick-off bằng POST với Parameters resource, _elements, bộ lọc patient và includeAssociatedData. Nhóm Argonaut đang đặc tả $bulk-submit và $bulk-publish cho bản phát hành sau. Đừng xây trên tính năng v3 khi EHR nguồn chưa công bố hỗ trợ; đa số EHR production triển khai các phiên bản cũ hơn, như phần tiếp theo cho thấy.
Epic và Oracle Health thực sự hỗ trợ những gì?
Ít hơn đặc tả. Epic chỉ hỗ trợ Group export (dựa trên v1.0.1 cộng một số tính năng mới hơn) và không hỗ trợ _since. Oracle Health hỗ trợ Group export (v1.0.1 cộng một số tham số v2) và Patient export (v2.0.0) nhưng bắt buộc có danh sách ID bệnh nhân. Cả hai đều chạy export trên hệ thống vận hành của bên cung cấp dịch vụ y tế.
| Epic | Oracle Health (Millennium) | |
|---|---|---|
| Mức export | Chỉ Group | Group và Patient (Patient cần danh sách ID, không có "mọi bệnh nhân") |
| Phiên bản đặc tả | 1.0.1 cộng một số tính năng mới hơn | Group: 1.0.1 cộng một số tham số thử nghiệm của v2.0.0; Patient: 2.0.0 |
Tăng dần (_since) | Không hỗ trợ | Không ghi trên trang bulk |
| Bộ lọc | _type, _typeFilter, includeAssociatedData | Tham số không hỗ trợ trả 422, trừ khi gửi Prefer: handling=lenient |
| Thời gian giữ kết quả | 14 ngày, sau đó xóa | Không ghi trên trang bulk |
| Hướng dẫn polling | Mỗi 10 phút với nhóm dưới 100 bệnh nhân, mỗi 30 phút với nhóm lớn hơn | 429 khi gửi quá nhiều request |
| Ai định nghĩa nhóm | Health system (bạn nhận Group FHIR ID từ họ) | Health system, trong Ignite Management Tooling |
Nguồn: hướng dẫn bulk data của Epic và tài liệu Bulk Data Access của Oracle. Epic nói thẳng về độ phù hợp: họ xếp đồng bộ data warehouse, nạp định kỳ lượng lớn dữ liệu lâm sàng và nạp dữ liệu tăng dần vào nhóm use case không phù hợp, và cho biết kết quả không tăng dần, không lấy được gì cho tới khi cả job xong.
Bulk FHIR có hợp cho dữ liệu huấn luyện và đánh giá AI không?
Với bộ đánh giá và dữ liệu fine-tune trong phạm vi một cohort, có, sau khi khử định danh và có cơ sở pháp lý rõ ràng. Với kho dữ liệu huấn luyện làm mới liên tục trên toàn health system, thường là không: mô hình trích xuất, giới hạn của vendor và tải lên hệ thống vận hành khiến nó không phù hợp.
Những chỗ bulk phát huy cho AI:
- Bộ đánh giá: một cohort cố định, có phiên bản (ví dụ 2.000 lượt khám có kết cục đã biết) export một lần, khử định danh, đóng băng và dùng lại cho mọi thay đổi model và prompt. Xem kiểm thử LLM cho ngành chịu quản lý.
- Index truy hồi cho một quần thể xác định: bệnh nhân của một chương trình quản lý chăm sóc, làm mới theo lịch mà health system đồng ý.
- Bảng đặc trưng cho model dự báo rủi ro, nơi độ mới hằng tuần hay hằng tháng là chấp nhận được.
Những chỗ không hợp: hỗ trợ quyết định thời gian thực (dùng API native của EHR hoặc CDS Hooks), data lake toàn doanh nghiệp (hãy hỏi về lựa chọn data warehouse của vendor EHR), và mọi thứ cần cập nhật trong vài phút.
Khử định danh dữ liệu FHIR trước khi tới model thế nào?
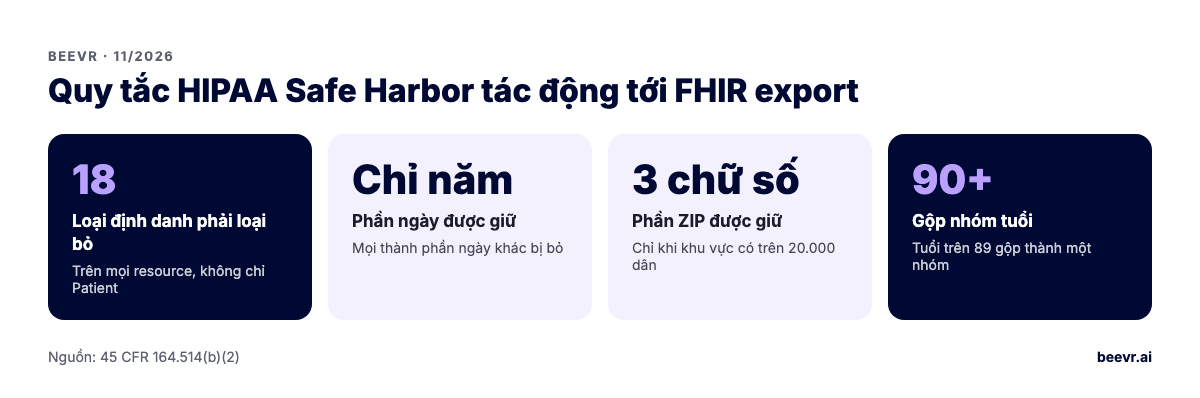
Dùng một trong hai phương pháp của HIPAA. Safe Harbor loại bỏ 18 loại định danh, gồm mọi thành phần ngày trừ năm, và mọi chữ số ZIP trừ ba chữ số đầu (ba chữ số đó cũng phải bỏ nếu khu vực có từ 20.000 dân trở xuống). Expert Determination cần một chuyên gia đủ năng lực ghi nhận rằng rủi ro tái định danh là "rất nhỏ". Văn bản tự do cần xử lý thêm trong cả hai trường hợp.
Quy định nằm ở 45 CFR 164.514. Các bẫy riêng của FHIR:
- Định danh có ở khắp nơi, không chỉ trong Patient:
Encounter.identifier, metadata củaDocumentReference, mã thành viên trongCoverage, định danh thiết bị, và URL trongAttachment.url. - Ngày tháng là nguồn tái định danh. Safe Harbor bỏ mọi thành phần ngày trừ năm. Nếu model cần khoảng thời gian, hãy cân nhắc dịch ngày theo từng bệnh nhân dưới Expert Determination.
- Tuổi trên 89 phải gộp thành nhóm 90 trở lên theo Safe Harbor.
- Ghi chú lâm sàng (
DocumentReference,Binary) chứa tên, địa chỉ và ngày trong văn bản tự do. Lọc theo luật sẽ sót; hãy đo tỷ lệ sót trên một mẫu có gán nhãn. - Tham chiếu giữ liên kết. Thay ID resource một cách nhất quán (hash có khóa, khóa do covered entity giữ) để đồ thị dữ liệu còn nguyên mà không lộ ID gốc. Theo 164.514(c), mã tái định danh không được suy ra từ thông tin của cá nhân.
- Điều kiện "biết thực tế" vẫn áp dụng: Safe Harbor không còn giá trị nếu bạn biết dữ liệu còn lại có thể định danh ai đó.
Nếu mục đích là nghiên cứu, y tế công cộng hay vận hành và bạn cần ZIP hoặc ngày, một limited data set kèm thỏa thuận sử dụng dữ liệu có thể hợp hơn khử định danh hoàn toàn.
Biến NDJSON thành bảng phân tích thế nào?
Đổ NDJSON thô nguyên trạng vào object storage, rồi làm phẳng thành bảng dạng cột bằng các view definition được khai báo và có phiên bản. ViewDefinition của SQL on FHIR v2 đang trở thành chuẩn cho việc này; bản build liên tục của đặc tả SQL on FHIR đang ở 2.1.0-pre.
Một pipeline đứng vững
- Vùng raw: NDJSON như khi nhận, phân vùng theo
transactionTimecủa lần export, mã hóa, chỉ role của pipeline được truy cập. - Validate: kiểm tra profile (US Core nếu áp dụng), đếm theo loại resource so với manifest, và đọc các file
errorchứ không bỏ qua. - Vùng đã khử định danh: một account hay project riêng, chỉ job khử định danh được ghi vào.
- Bảng phẳng: ViewDefinition cho Patient, Encounter, Condition, Observation…, lưu dạng Parquet, phiên bản definition ghi trong metadata của bảng.
- Lineage: mỗi dòng truy ngược được về job export, file và resource ID (hoặc bí danh của nó).
Điều gì quyết định hiệu năng và chi phí của Bulk FHIR?
Quy mô quần thể, số loại resource, khoảng thời gian và tải của hệ thống nguồn quyết định thời gian chạy. Chi phí của bạn đến từ lưu trữ, compute để làm phẳng và khử định danh, và thời gian kỹ sư cho mỗi health system. Lọc hẹp sẽ giảm tất cả.
- Lọc ngay từ nguồn: Epic khuyên dùng
_typevà_typeFilterbất cứ khi nào có thể để giảm thời gian phản hồi và dung lượng lưu trữ. Ở Epic, Binary mặc định không được trả và chỉ lấy được qua_type. - Polling lịch sự: theo
Retry-Aftervà hướng dẫn của vendor; polling dồn dập sẽ gặp 429 và mất thiện cảm. - Lên lịch cùng khách hàng: export chạy trên database vận hành. Hãy thống nhất khung giờ.
- Không có
_since? Thiết kế cho điều đó: khi thiếu export tăng dần, giữ cohort nhỏ và ổn định, và tự so sánh các bản trích xuất đầy đủ ở phía bạn thay vì xử lý lại toàn bộ ở hạ nguồn. - Kiểm tra chế độ lenient: trên Oracle Health,
Prefer: handling=lenientlặng lẽ bỏ tham số không hỗ trợ. Hãy xác minh bộ lọc thực sự được áp dụng. - Tải trước khi hết hạn: ở Epic bạn có 14 ngày kể từ kick-off để job xong và tải về.
Đặc tả cũng cho phép server trả 429 để chặn export mới khi một export khác đang chạy, nên đừng chạy song song nhiều job cho cùng một client khi chưa kiểm tra chính sách của server. Về chi phí vận hành lớp AI phía trên, xem chi phí vận hành sản phẩm AI.
Những sai lầm phổ biến nhất với Bulk FHIR là gì?
Dùng bulk như cơ chế đồng bộ, cho rằng server nào cũng hỗ trợ _since và export cấp Patient, bỏ qua các mảng error và deleted, giữ file PHI quá mục đích sử dụng, và gửi bản export thô cho nhà cung cấp model khi không có BAA hay chưa khử định danh.
Cũng hay gặp: quên rằng thành viên của Group do health system kiểm soát và có thể đổi giữa các lần chạy, và không lưu transactionTime, thứ bạn cần cho mọi logic tăng dần về sau. Về quản trị phần AI dùng dữ liệu này, xem AI agent tuân thủ HIPAA và HIPAA Security Rule và AI năm 2026.
BeevR làm việc này thế nào
Chúng tôi xây client bulk export trên SMART Backend Services, đổ NDJSON vào kho lưu trữ mã hóa, kiểm soát truy cập, đối chiếu với manifest, khử định danh ở một vùng riêng với rủi ro còn sót trên ghi chú được đo đạc, và làm phẳng bằng view definition có phiên bản để mọi con số trên dashboard hay trong bộ đánh giá đều truy ngược được về file nguồn. Chúng tôi thống nhất cohort và lịch với từng health system, và nói thẳng khi bulk là công cụ sai. BeevR ký BAA với tư cách business associate, model có thể chạy trong chính tài khoản AWS của bạn theo AWS BAA, và bạn sở hữu source code và IP từ ngày đầu.
Đội senior do founder dẫn dắt ở Hà Nội đang vận hành một EHR multi-tenant ở bốn phòng khám tại Mỹ với khoảng 300 bệnh nhân mỗi ngày, có demo chạy được mỗi thứ Sáu và các giai đoạn phạm vi cố định, giá cố định từ $10K mỗi giai đoạn. Xem dịch vụ tích hợp EHR và phát triển AI agent cho y tế.
Đang xây pipeline phân tích hay AI trên dữ liệu EHR? Đặt lịch gọi 30 phút, chúng tôi sẽ đối chiếu use case của bạn với những gì EHR nguồn thực sự hỗ trợ.