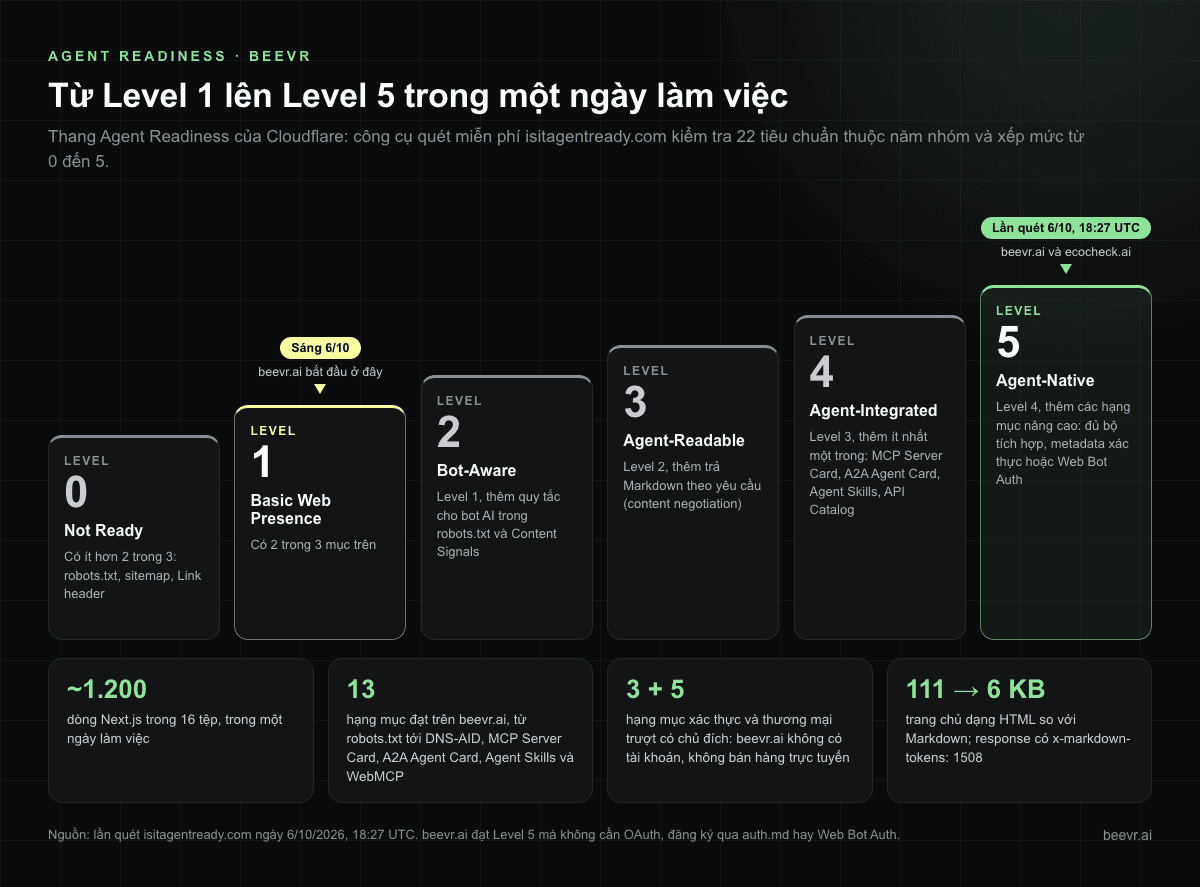
Website sẵn sàng cho AI agent là website mà agent tìm thấy, đọc được và dùng được mà không phải cào (scrape) HTML. Cụ thể: robots.txt có quy tắc cho bot AI và Content Signals, có Link header, có bản Markdown của từng trang, và có tệp mô tả máy đọc được cho các công cụ thật như MCP server, A2A agent hay JSON API. Ngày 6/10/2026, chúng tôi đưa beevr.ai từ Level 1 lên Level 5 ("Agent-Native"), mức cao nhất trên thang Agent Readiness của Cloudflare, trong một ngày làm việc. Phần thay đổi chính là khoảng 1.200 dòng Next.js trong 16 tệp. Bài này trình bày từng hạng mục, cách chúng tôi làm, công sức bỏ ra, lỗi Next.js gặp phải và những gì chúng tôi cố ý bỏ qua. Mọi endpoint đều đang chạy thật, bạn có thể tự kiểm chứng bằng curl. Cập nhật tháng 10/2026.
"Sẵn sàng cho agent" nghĩa là gì, và đo bằng cách nào?
AI agent giờ đã tự tìm kiếm, so sánh và hành động thay người dùng. Trợ lý của một khách hàng có thể lập danh sách các studio phần mềm, đọc bảng giá và soạn sẵn email hỏi thông tin trước khi người đó mở trình duyệt. Cào HTML thì chậm, tốn token và hay sai. Website sẵn sàng cho agent cung cấp ba thứ: quyền (agent được làm gì với nội dung), nội dung dễ đọc (Markdown, thay vì 100 KB markup) và công cụ dùng được (endpoint có cấu trúc, kèm mô tả công khai).
Cloudflare ra mắt điểm Agent Readiness và công cụ quét miễn phí isitagentready.com vào tháng 4/2026. Công cụ kiểm tra 22 tiêu chuẩn thuộc năm nhóm (khả năng được phát hiện, khả năng truy cập nội dung, kiểm soát bot, phát hiện API/xác thực/MCP, và thương mại) rồi xếp mức:
| Mức | Tên | Yêu cầu |
|---|---|---|
| 0 | Not Ready | Có ít hơn 2 trong 3: robots.txt, sitemap, Link header |
| 1 | Basic Web Presence | Có 2 trong 3 mục trên |
| 2 | Bot-Aware | Level 1, thêm quy tắc cho bot AI trong robots.txt và Content Signals |
| 3 | Agent-Readable | Level 2, thêm trả Markdown theo yêu cầu (content negotiation) |
| 4 | Agent-Integrated | Level 3, thêm ít nhất một trong: MCP Server Card, A2A Agent Card, Agent Skills, API Catalog |
| 5 | Agent-Native | Level 4, thêm các hạng mục nâng cao: đủ bộ tích hợp, metadata xác thực hoặc Web Bot Auth |
Bạn có thể quét bằng dòng lệnh. Kết quả là JSON gồm mức hiện tại, trạng thái từng hạng mục và điều kiện để lên mức tiếp theo:
curl -s -X POST https://isitagentready.com/api/scan \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://beevr.ai"}'
beevr.ai bắt đầu từ đâu, và giờ ở mức nào?
Sáng 6/10/2026, beevr.ai ở Level 1. robots.txt, sitemap và quy tắc cho crawler AI đạt. Content Signals, Link header, Markdown và mọi hạng mục phát hiện đều trượt. Sản phẩm anh em EcoCheck, nền tảng kiểm kê khí nhà kính, cũng vậy.
Lần quét cho bài viết này (6/10/2026, 18:27 UTC) cho thấy cả hai site ở Level 5, Agent-Native, không còn mức nào cao hơn:
- beevr.ai: đạt 13 hạng mục, từ robots.txt và Link header đến DNS-AID, Markdown, MCP Server Card, A2A Agent Card, Agent Skills và WebMCP. Ba hạng mục xác thực trượt có chủ đích, năm hạng mục thương mại cũng vậy.
- ecocheck.ai: tương tự, thêm OAuth discovery và protected-resource metadata, vì EcoCheck có tài khoản khách hàng thật. Các hạng mục thương mại được đánh dấu "không áp dụng".
Điều quan trọng là thứ nằm sau điểm số. Mọi tệp chúng tôi công bố đều mô tả một endpoint chạy thật, trả về đúng dịch vụ, bảng giá, case study và bài viết mà website đang hiển thị. Tệp mô tả trỏ vào một endpoint không tồn tại sẽ làm hỏng mọi agent định dùng nó.
Agent biết website cho phép gì và cung cấp gì bằng cách nào?
Agent biết mình được làm gì qua robots.txt và Content Signals, và biết website cung cấp gì qua Link header, API catalog, AI catalog và bản ghi DNS. Trên beevr.ai, tất cả những mục này gộp lại mất chưa tới một ngày.
robots.txt kèm Content Signals. robots.txt vốn quy định crawler nào được tải gì. Content Signals bổ sung việc crawler được làm gì với nội dung: search (lập chỉ mục và dẫn link), ai-input (dùng làm căn cứ cho câu trả lời AI) và ai-train (dùng để huấn luyện). Chúng tôi chọn "yes" cả ba cho mọi nhóm user-agent, vì muốn công cụ AI trích dẫn BeevR. robots.txt được sinh bằng next-sitemap, nên chỉ cần một hàm transformRobotsTxt ngắn chèn dòng Content-Signal sau mỗi dòng User-agent. Hãy chọn giá trị có cân nhắc: nhiều nhà xuất bản đặt ai-train=no.
Link header (RFC 8288). Mọi trang HTML giờ trả header Link trỏ tới API catalog, mô tả OpenAPI, llms.txt, AI catalog và sitemap, nên agent tải bất kỳ trang nào cũng biết dữ liệu có cấu trúc nằm ở đâu. Trong Next.js, đây là một mục headers() trong next.config.js, kèm Vary: Accept vì cùng một URL có thể trả Markdown. Kiểm tra bằng curl -sI https://beevr.ai/.
API Catalog (RFC 9727) và AI catalog. /.well-known/api-catalog là tài liệu linkset+json liệt kê ba giao diện cho agent (JSON API, MCP, A2A) cùng mô tả. /.well-known/ai-catalog.json là manifest ARD (Agentic Resource Discovery): một danh sách gồm MCP server card, A2A agent card, API catalog và skills index, mỗi mục kèm vài câu hỏi mẫu.
DNS-AID. DNS for AI Discovery công bố endpoint của agent dưới dạng bản ghi SVCB trong không gian tên _agents. Chúng tôi thêm _index._agents.beevr.ai và _a2a._agents.beevr.ai, cùng trỏ về beevr.ai cổng 443. Công cụ quét chỉ chấp nhận bản ghi từ zone có ký DNSSEC, nên chúng tôi bật DNSSEC trên Cloudflare và thêm bản ghi DS ở nhà đăng ký tên miền.
Agent đọc trang thế nào mà không phải cào HTML?
Agent yêu cầu Markdown. Cùng một URL trả Markdown sạch cho agent và HTML bình thường cho trình duyệt, còn llms.txt cho agent một bản đồ website được chọn lọc.
Trả Markdown theo yêu cầu. Khi request gửi Accept: text/markdown, beevr.ai trả phần nội dung chính của trang dưới dạng Markdown. Trình duyệt không bao giờ gửi header này, nên người đọc vẫn thấy trang như cũ. Trang chủ của chúng tôi nặng khoảng 111 KB HTML nhưng chỉ 6 KB Markdown, và response có header x-markdown-tokens: 1508 để agent biết trước chi phí:
curl -s -H 'Accept: text/markdown' https://beevr.ai/ | headCloudflare có thể chuyển đổi ở edge với gói trả phí. Chúng tôi tự làm trong ứng dụng. Middleware chuyển request Markdown sang một API route; route này render trang ở nội bộ, tách phần nội dung chính và chuyển sang Markdown kèm front matter (tiêu đề, mô tả, URL canonical). Bộ chuyển đổi khoảng 120 dòng, không dùng thư viện ngoài.
llms.txt. llms.txt là mục lục Markdown được chọn lọc của website, có mục "Agent access" liệt kê endpoint MCP, A2A, API và Markdown. Công cụ quét không chấm điểm mục này, nhưng các công cụ tìm kiếm AI có đọc.
Agent thực sự dùng website của bạn như thế nào?
Agent dùng website qua công cụ: các endpoint có mô tả công khai và trả dữ liệu thật. Đây là phần có giá trị kinh doanh, và cũng là phần hầu hết website bỏ qua. beevr.ai cung cấp cùng một bộ dữ liệu chỉ đọc qua năm giao diện:
- MCP server tại
https://beevr.ai/mcp. JSON-RPC không trạng thái qua Streamable HTTP, 8 tool chỉ đọc bằng tiếng Anh và tiếng Việt, trong đó cósearch_beevr,get_pricing,get_case_studyvàget_article. Server card tại/.well-known/mcp/server-card.jsonnêu endpoint, danh sách tool vàauthentication.required: false. Thêm URL này làm custom connector trong một trợ lý hỗ trợ MCP, câu hỏi về giá sẽ được trả lời từget_pricingchứ không phải từ trí nhớ của model. Kiến trúc và bảo mật có trong bài phát triển MCP server. - A2A agent tại
https://beevr.ai/a2a, mô tả bởi/.well-known/agent-card.json. Agent khác gửi một tin nhắn văn bản (message/send) và nhận lại dịch vụ, case study, bài viết hoặc bảng giá phù hợp. Agent này cố ý được làm tất định, không có LLM phía sau, nên không thể bịa ra giá. - JSON API dưới
/agent-api/, mô tả bởi/openapi.json. - Agent Skills tại
/.well-known/agent-skills/index.json: hai tệpSKILL.mdkèm mã băm SHA-256, một để tìm hiểu về BeevR, một để đưa ra ước tính ban đầu có căn cứ từ các gói giá đã công bố rồi chuyển người dùng tới báo giá thật. - WebMCP. Khi có agent chạy trong trình duyệt, website đăng ký bốn tool qua
document.modelContext. Ở trình duyệt khác, component này không làm gì.
Thử A2A agent:
curl -s https://beevr.ai/a2a -H 'content-type: application/json' -d '{
  "jsonrpc":"2.0","id":1,"method":"message/send",
  "params":{"message":{"role":"user","messageId":"m1",
    "parts":[{"kind":"text","text":"How much does an MVP cost?"}]}}}'
Agent trả về ba gói giá cố định kèm link, nên trợ lý của người dùng có thể đưa ra con số thật, có nguồn.
Chúng tôi làm trên Next.js thế nào, và gặp lỗi gì?
beevr.ai chạy Next.js 12 với i18n tích hợp (tiếng Anh ở gốc, tiếng Việt dưới /vi). Ba module đảm nhận phần chính. lib/agent/data.js chứa dịch vụ, gói giá và case study; bài viết lấy từ CMS. lib/agent/tools.js định nghĩa mỗi tool một lần cho MCP server, A2A agent và JSON API. lib/agent/manifests.js sinh mọi tài liệu phát hiện từ cùng dữ liệu, nên tool mới tự xuất hiện trong mọi manifest và các giao diện không bao giờ lệch nhau. Một vài API route phục vụ toàn bộ.
Lỗi gặp phải. Cách hiển nhiên để ánh xạ /mcp hay /.well-known/agent-card.json sang API route là dùng rewrites() trong next.config.js. Khi bật i18n, mọi rewrite đều trả 404. Next.js gắn locale vào đích đến (/en/api/...), mà API route không tồn tại dưới locale. Đặt locale: false hay chuyển quy tắc giữa beforeFiles và afterFiles đều không được. Cách sửa là định tuyến các đường dẫn cho agent ngay đầu middleware.js bằng URL tuyệt đối, vốn không mang locale:
const AGENT_ROUTES = [
  [/^\/\.well-known\/agent(?:-card)?\.json$/, () => '/api/wk?doc=agent-card'],
  [/^\/mcp\/?$/, () => '/api/mcp'],
  [/^\/a2a\/?$/, () => '/api/a2a'],
  [/^\/agent-api\/(.+)$/, m => `/api/agent/${m[1]}`],
]
// trong middleware(): so khớp, rồi
return NextResponse.rewrite(new URL(target, request.url))
Thêm hai bẫy nhỏ. Matcher của middleware không khớp đường dẫn gốc / khi bật i18n, nên Markdown không chạy ở trang chủ cho tới khi chúng tôi khai báo '/' tường minh. Và route Markdown tự tải trang ở nội bộ, nên phải gửi kèm một header đánh dấu để middleware không rewrite request đó lần nữa, nếu không sẽ lặp vô hạn.
Chúng tôi sinh các tài liệu well-known trong một route từ dữ liệu sống. Tệp tĩnh trong public/ cũng ổn nếu dịch vụ của bạn ít thay đổi.
Chúng tôi cố ý bỏ qua những gì, và vì sao?
Chúng tôi bỏ qua OAuth, cơ chế agent tự đăng ký và các giao thức thương mại, vì không mục nào hợp với một website không có tài khoản người dùng và không bán hàng trực tuyến. Level 5 không đòi hỏi các mục này. Web Bot Auth được bổ sung một ngày sau (xem bên dưới).
- OAuth discovery và protected-resource metadata. beevr.ai không có tài khoản người dùng, không có dữ liệu riêng tư. Dựng authorization server chỉ để qua một hạng mục là mô tả một luồng xác thực chẳng bảo vệ gì. EcoCheck thì ngược lại: khách hàng có workspace và dữ liệu phát thải, nên
https://ecocheck.ai/mcp/accountlà một OAuth 2.1 resource server. Gọi không có token sẽ nhận401kèm headerWWW-Authenticatetrỏ tới metadata RFC 9728, trong đó nêu authorization server và scope chỉ đọcecocheck/read. Cả hai hạng mục OAuth đạt ở đó vì có thứ thật cần bảo vệ. - Đăng ký agent qua auth.md. Tệp auth.md của chúng tôi nói đúng sự thật: không đăng ký, không cấp thông tin xác thực, truy cập ẩn danh chỉ đọc, và agent không được gửi form liên hệ thay người dùng. Hạng mục này đòi một luồng để agent tự đăng ký. Chúng tôi không cho agent tạo tài khoản, nên nó trượt, đúng như ý muốn.
- Giao thức thương mại (x402, MPP, UCP, ACP, AP2). Các giao thức này cho agent thanh toán hoặc đặt hàng. Chúng tôi bán dự án bắt đầu bằng một cuộc trao đổi, không phải giỏ hàng. Công cụ quét gắn cờ beevr.ai có thể là site thương mại vì chữ PayPal và Adyen xuất hiện trong một case study thanh toán; đây là cảnh báo sai và không ảnh hưởng tới mức.
- Web Bot Auth (bổ sung ngày 7/10). Cơ chế này cho bot chứng minh danh tính bằng cách ký request (RFC 9421). Chúng tôi công bố khoá công khai Ed25519 tại
/.well-known/http-message-signatures-directory, và chính phản hồi này được ký trên@authority. Mất khoảng một giờ. Nó chỉ thật sự có ích khi bạn vận hành agent gọi ra ngoài, nên chúng tôi chưa gửi form xác minh bot của Cloudflare; công cụ quét chỉ coi đây là thông tin tham khảo.
Checklist đầy đủ để website sẵn sàng cho agent gồm những gì?
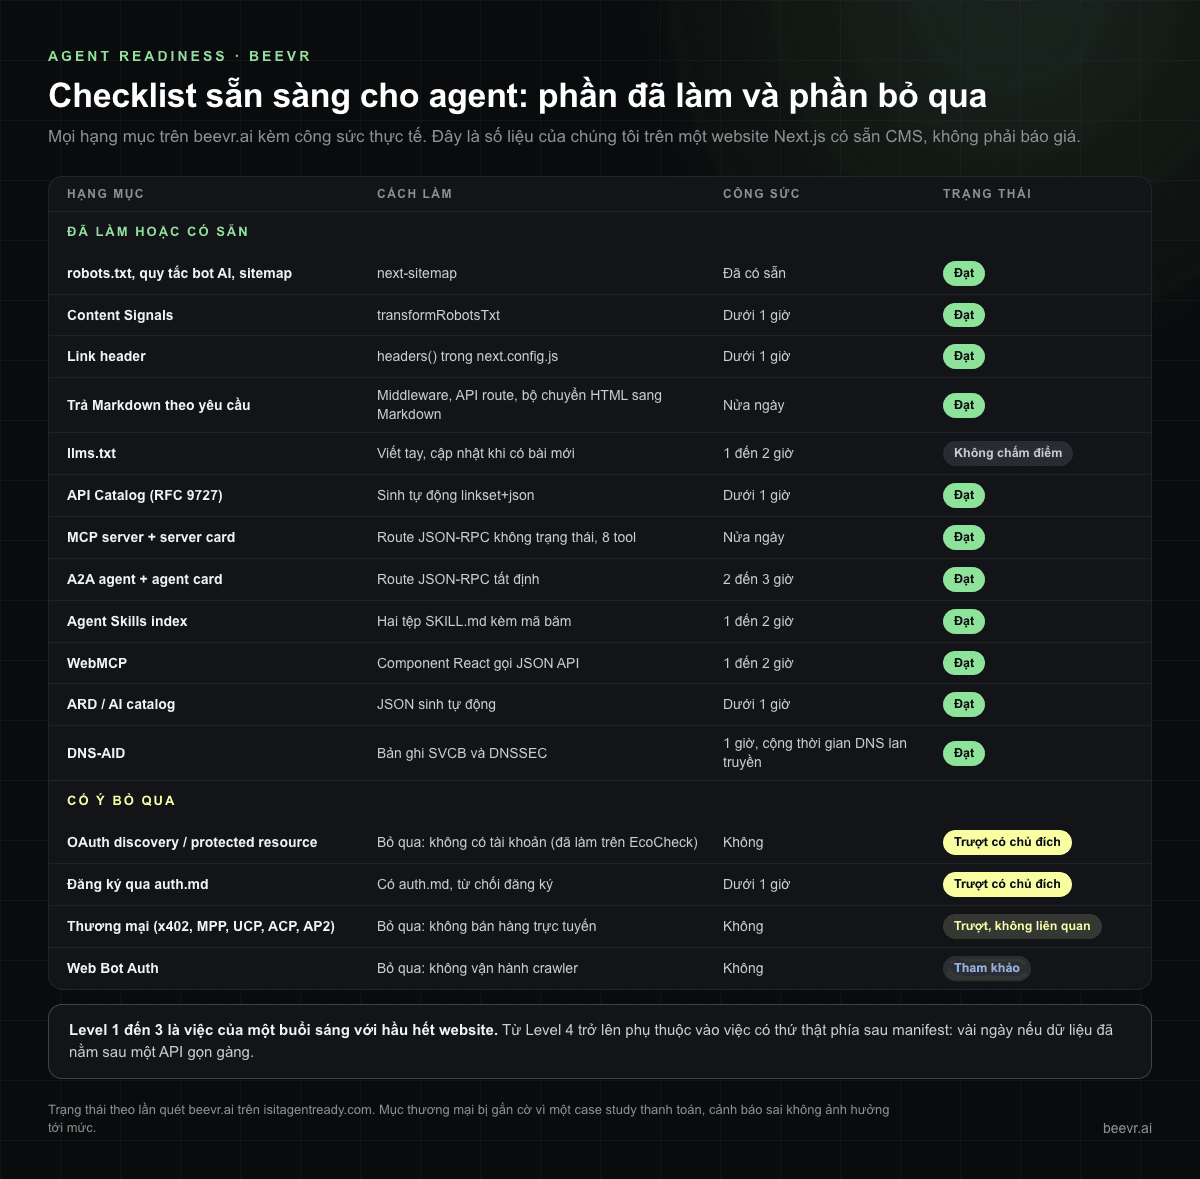
Mọi hạng mục chúng tôi đã làm trên beevr.ai, kèm công sức thực tế. Đây là số liệu của chúng tôi trên một website Next.js có sẵn CMS, không phải báo giá.
| Hạng mục | Cách làm | Công sức | Trạng thái |
|---|---|---|---|
| robots.txt, quy tắc bot AI, sitemap | next-sitemap | Đã có sẵn | Đạt |
| Content Signals | transformRobotsTxt | Dưới 1 giờ | Đạt |
| Link header | headers() trong next.config.js | Dưới 1 giờ | Đạt |
| Trả Markdown theo yêu cầu | Middleware, API route, bộ chuyển HTML sang Markdown | Nửa ngày | Đạt |
| llms.txt | Viết tay, cập nhật khi có bài mới | 1 đến 2 giờ | Không chấm điểm |
| API Catalog (RFC 9727) | Sinh tự động linkset+json | Dưới 1 giờ | Đạt |
| MCP server + server card | Route JSON-RPC không trạng thái, 8 tool | Nửa ngày | Đạt |
| A2A agent + agent card | Route JSON-RPC tất định | 2 đến 3 giờ | Đạt |
| Agent Skills index | Hai tệp SKILL.md kèm mã băm | 1 đến 2 giờ | Đạt |
| WebMCP | Component React gọi JSON API | 1 đến 2 giờ | Đạt |
| ARD / AI catalog | JSON sinh tự động | Dưới 1 giờ | Đạt |
| DNS-AID | Bản ghi SVCB và DNSSEC | 1 giờ, cộng thời gian DNS lan truyền | Đạt |
| OAuth discovery / protected resource | Bỏ qua: không có tài khoản (đã làm trên EcoCheck) | Không | Trượt có chủ đích |
| Đăng ký qua auth.md | Có auth.md, từ chối đăng ký | Dưới 1 giờ | Trượt có chủ đích |
| Thương mại (x402, MPP, UCP, ACP, AP2) | Bỏ qua: không bán hàng trực tuyến | Không | Trượt, không liên quan |
| Web Bot Auth | Thư mục khoá có chữ ký (Ed25519), bổ sung 7/10 | ~1 giờ | Đạt (tham khảo) |
Level 1 đến 3 là việc của một buổi sáng với hầu hết website. Từ Level 4 trở lên phụ thuộc vào việc có thứ thật phía sau manifest: vài ngày nếu dữ liệu đã nằm sau một API gọn gàng, và là một dự án riêng nếu cần server có xác thực trên dữ liệu khách hàng như của EcoCheck.
Doanh nghiệp của bạn có nên đầu tư cho agent không?
Có, nếu agent đang hành động thay khách hàng của bạn. Các mức rẻ chỉ tốn vài giờ và giúp câu trả lời AI về bạn lấy từ chính trang của bạn. Công cụ đáng xây khi agent cần trả lời bằng dữ liệu sống thay vì trí nhớ: giá, tình trạng còn hàng, điều kiện áp dụng, trạng thái đơn. Với EcoCheck, câu hỏi đó là "cơ sở của tôi có phải kiểm kê khí nhà kính không?", được trả lời bởi tool công khai check_ghg_inventory_obligation. Đừng công bố tệp mô tả cho endpoint bạn không có, và đừng thêm OAuth hay giao thức thương mại chỉ để tăng điểm. Khi agent đã hành động được, bạn cũng cần giới hạn những gì chúng được làm; bài governance cho AI agent nói về phần này.
Câu hỏi thường gặp
Website sẵn sàng cho AI agent là gì?
Là website mà AI agent phát hiện, đọc và dùng được qua các tiêu chuẩn công khai thay vì cào HTML: robots.txt có quy tắc và Content Signals, Link header, bản Markdown của trang, và tệp mô tả máy đọc được cho công cụ thật như MCP server, A2A agent card hay API catalog.
Làm sao kiểm tra điểm agent readiness của website?
Nhập URL tại isitagentready.com, hoặc gửi POST {"url":"https://website-cua-ban"} tới https://isitagentready.com/api/scan. Kết quả gồm mức từ 0 đến 5, trạng thái của cả 22 hạng mục và điều kiện để lên mức tiếp theo.
Có cần MCP server mới sẵn sàng cho agent không?
Không, với Level 3: chỉ cần robots.txt, sitemap, quy tắc cho bot AI, Content Signals và trả Markdown. Level 4 cần ít nhất một tích hợp: MCP server card, A2A agent card, Agent Skills hoặc API catalog. Hãy xây cái trả lời được một câu hỏi thật từ dữ liệu của bạn.
Trả Markdown cho agent có ảnh hưởng SEO không?
Không. Trình duyệt và crawler tìm kiếm yêu cầu HTML và vẫn nhận HTML. Chỉ client gửi Accept: text/markdown mới nhận Markdown. Hãy gửi Vary: Accept để bộ nhớ đệm tách hai phiên bản, và ghi URL canonical trong bản Markdown.
Vì sao rewrite tới /api trong Next.js trả 404?
Khi bật i18n, Next.js 12 gắn locale vào đích rewrite, nên đích thành /en/api/..., vốn không tồn tại. Hãy định tuyến các đường dẫn này trong middleware bằng NextResponse.rewrite(new URL('/api/...', request.url)), và thêm '/' vào matcher một cách tường minh.
BeevR xây lớp agent cho sản phẩm: MCP server, A2A agent, API công khai và OAuth cho truy cập của agent, giá cố định theo từng giai đoạn và bạn sở hữu toàn bộ code. Bạn có thể thử ngay server của chúng tôi tại https://beevr.ai/mcp. Để đưa sản phẩm của bạn sẵn sàng cho agent, xem dịch vụ phát triển AI agent hoặc kể cho chúng tôi bạn muốn agent làm được gì với sản phẩm của mình.